概览
AI Engineer Shanghai 2026 在 11 月 5 日和 6 日于上海虹桥希尔顿举行,这是 AI Engineer 第一次在中国办活动。我参加了第一天,议程上的主题是开放模型、agent 和基础设施。
09:07 的报到处(签到处),背板写着 AI Engineer Shanghai,上方是赞助商名称。
上午只有一个场地,从 09:30 到 11:40 午餐。下午 13:00 有一场社群座谈,13:45 开始分场进行,主舞台旁边另有一个 AI 应用分场。我一直待在主舞台听 agent 和基础设施的演讲。
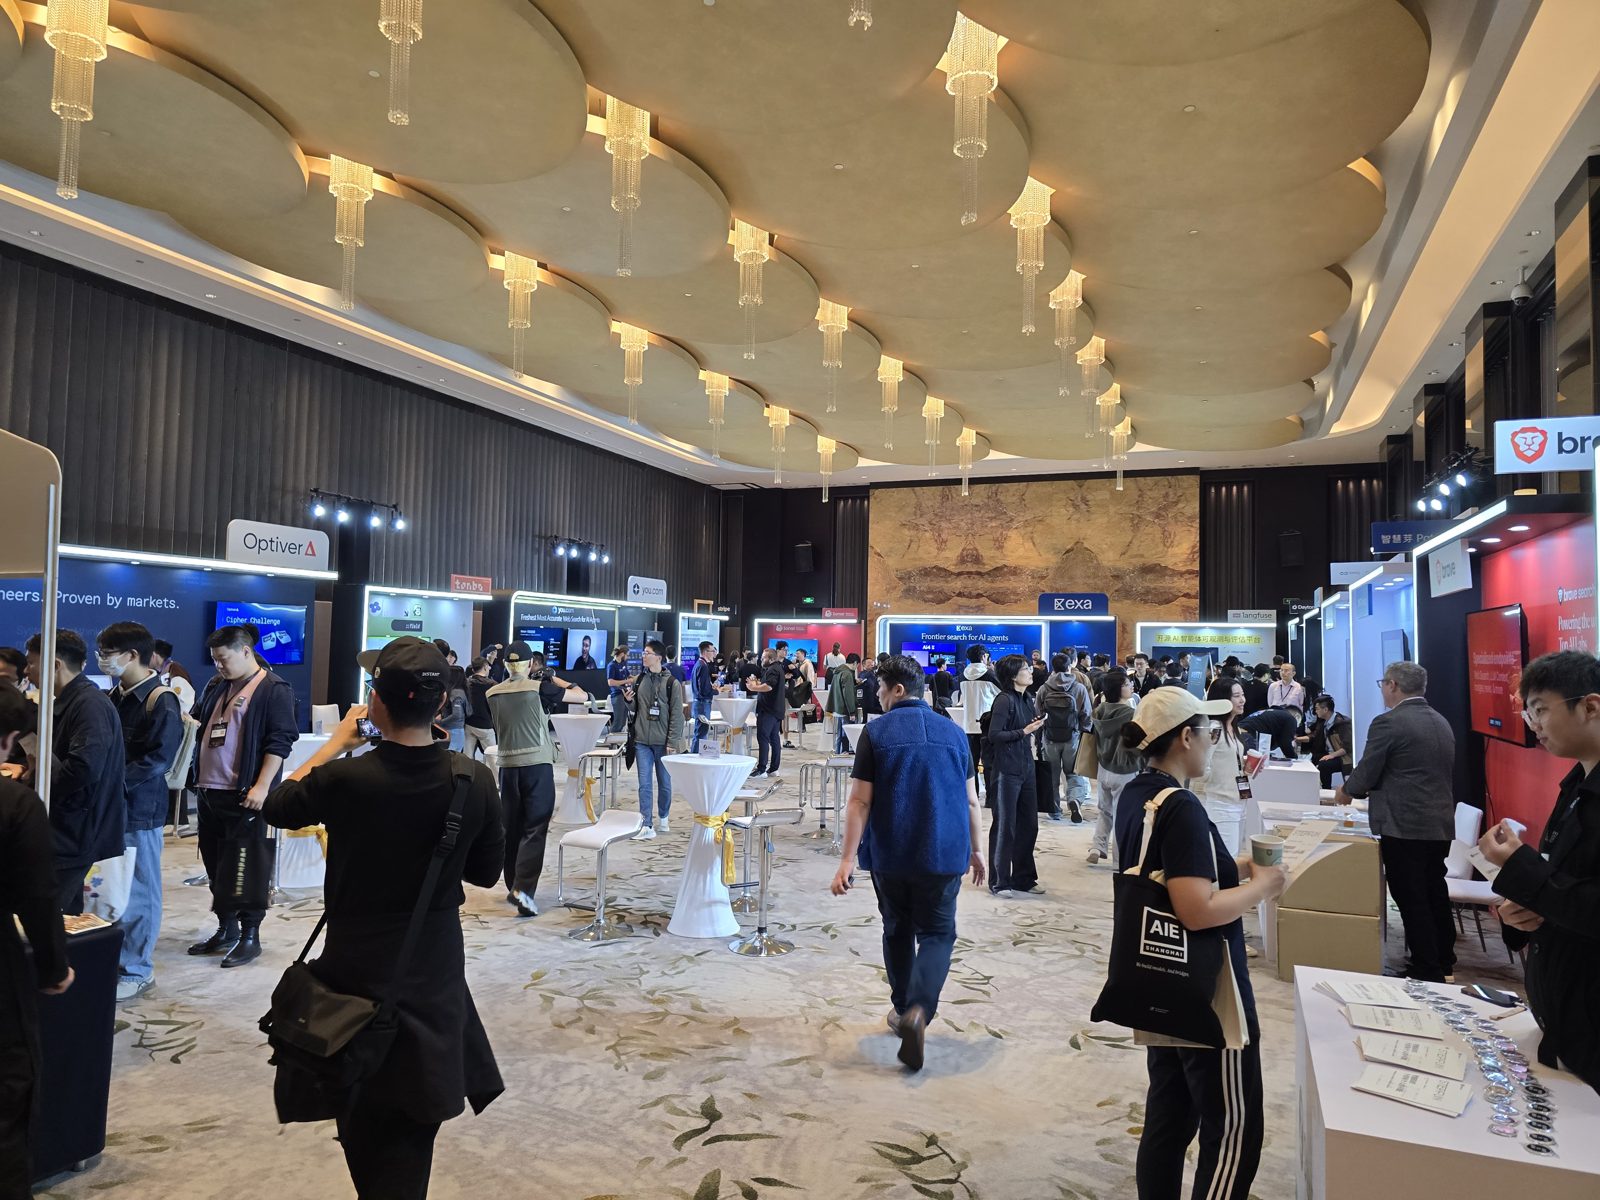
09:14 的展区,后墙是 Optiver 和 Exa 的摊位,右边是 Brave。
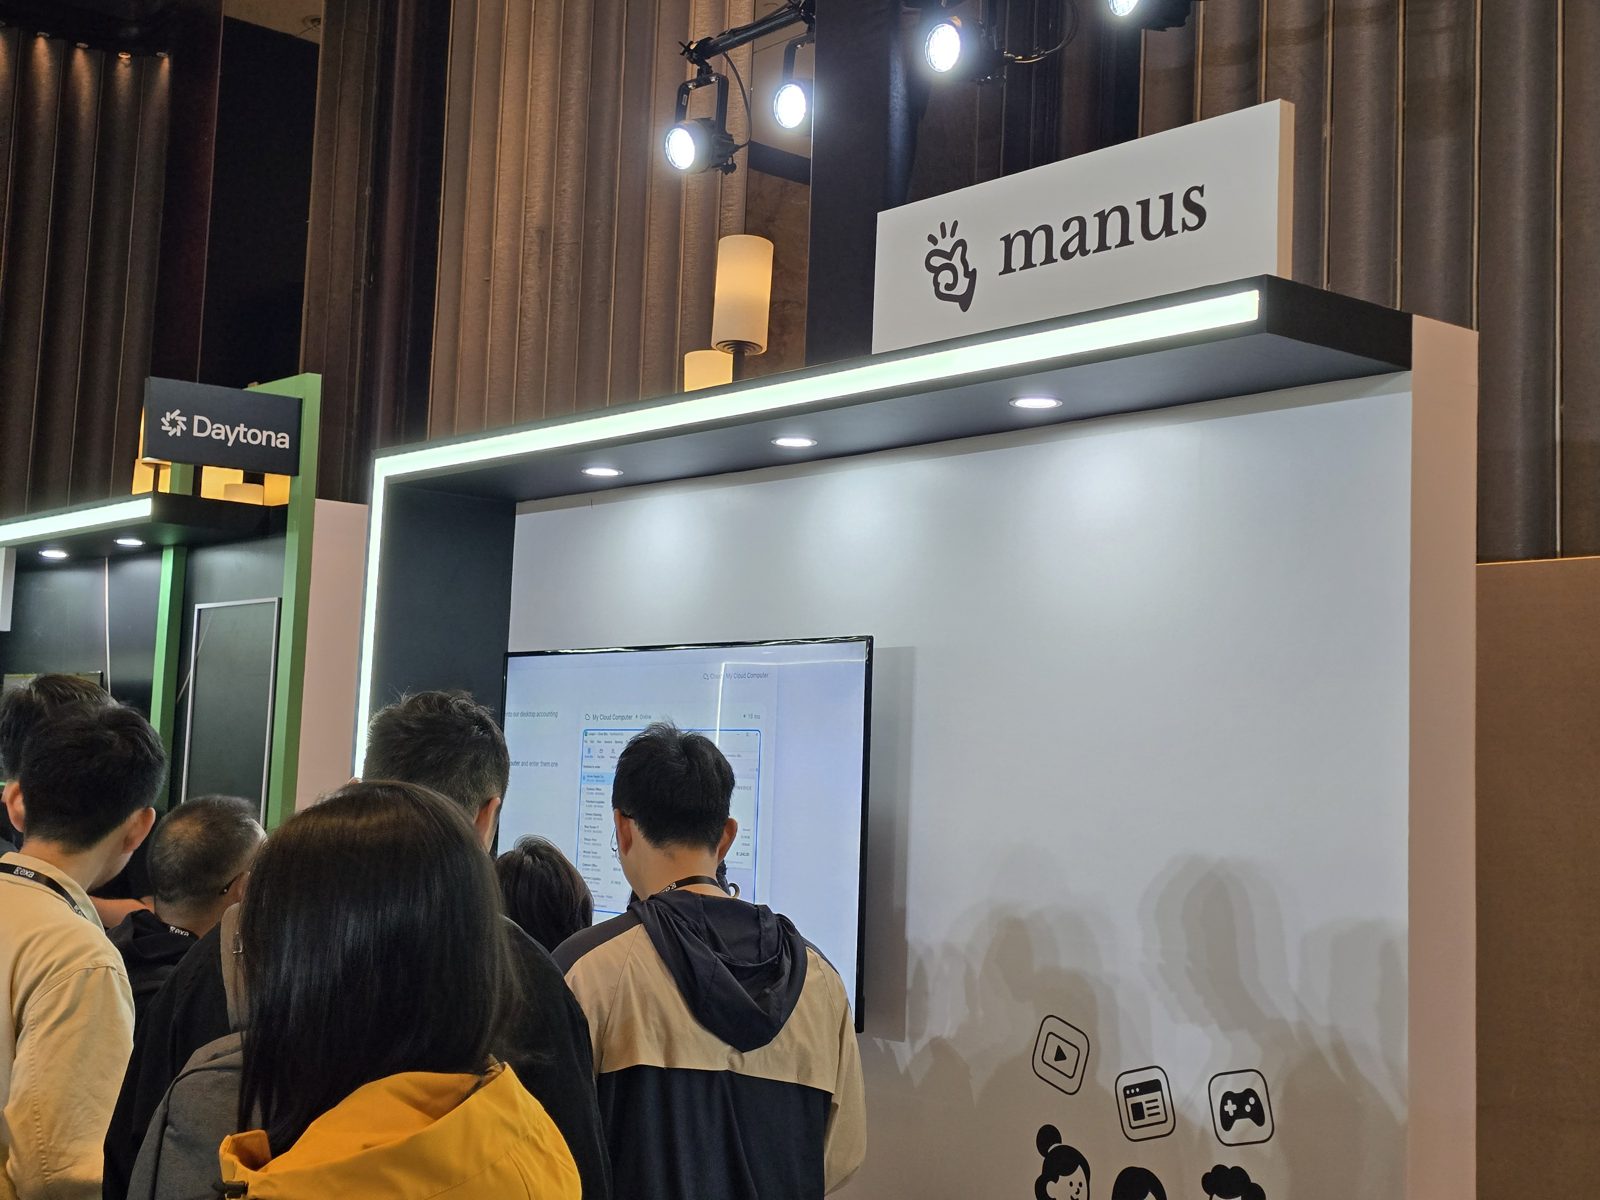
Manus 的摊位,旁边是 Daytona。两家公司当天下午都上了主舞台。
以下笔记照议程时间顺序整理。
欢迎致词与开场视频 — Mengying and swyx (AI Engineer)
09:30 在主舞台开场。负责上海场的 Mengying 致欢迎词。这是 AI Engineer 在中国的第一场活动。她感谢了赞助商,请大家去逛展区,也谢谢讲者们远道飞来。
swyx 因为 AI Engineer 隔周在旧金山有一场大型活动,所以没来,改传了一段视频。他的主张是 AI Engineer 是给动手做东西的工程师参加的,而其他 AI 研讨会请的是政治人物和国家元首。他说上海是 AI Engineer 的第六个城市,提到之前办过的新加坡、迈阿密、雪梨、巴黎和墨尔本,并说明年会去印度和非洲。最后很明确的请求是大家多发笔记、照片和视频,让他在家里转推,因为这场研讨会没有直播。
从模型到真正可用的企业 agent — Marco Casalaina (Microsoft)
Marco Casalaina 是 Microsoft Core AI 部门的产品副总裁,他在湾区的职称是“AI futurist”。他一开始就说自己不是来推销 Microsoft 产品的,想谈的是未来六到十二个月 agent 会长什么样子。他原本打算现场 demo,但饭店网络几乎马上就挂了,所以大部分内容都靠他事先为了以防万一截好的图。
他的重点是 agent 正在拥有自己的身分。他从 Meta 的 Muse 讲起,Muse 在安装时会请你帮它取名字(他的叫“Lily”)。他认为 Meta 这样做是要让你把助理当朋友,因为 Muse 靠用户黏着度赚钱。Microsoft 这样做则是为了安全。在 Microsoft Foundry 里建的 agent 会有自己的 Entra ID,他称为 autopilot 的那种还会有信箱、Teams 帐号和 OneDrive,就像新进员工一样。他举的例子是一个银行 agent“Marco’s Teller”,它用 email 回复客户关于 ATM 手续费的问题,并把他加进副本。
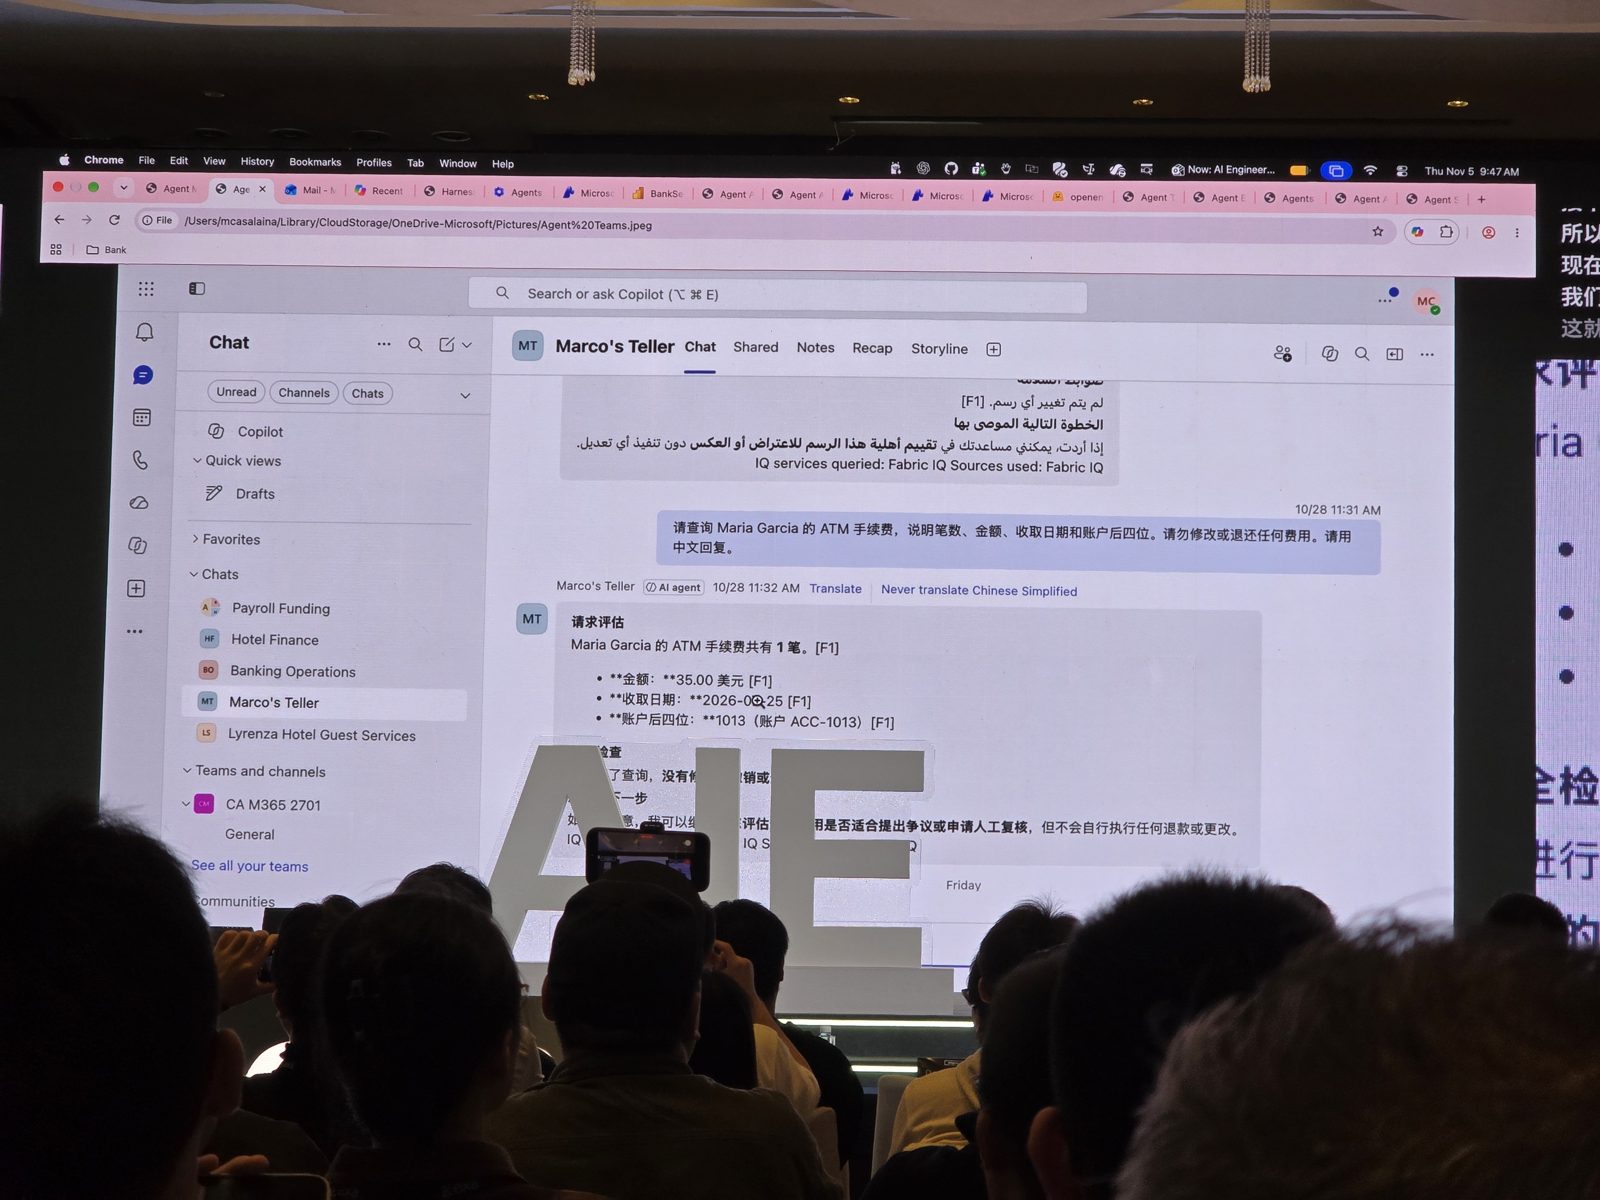
Teams 里 demo 用的几个 agent 对话(Payroll Funding、Hotel Finance、Banking Operations、Marco’s Teller)。标示为 AI agent 的 Marco’s Teller 用中文回答 Maria Garcia 那笔 35 美元 ATM 手续费的问题。
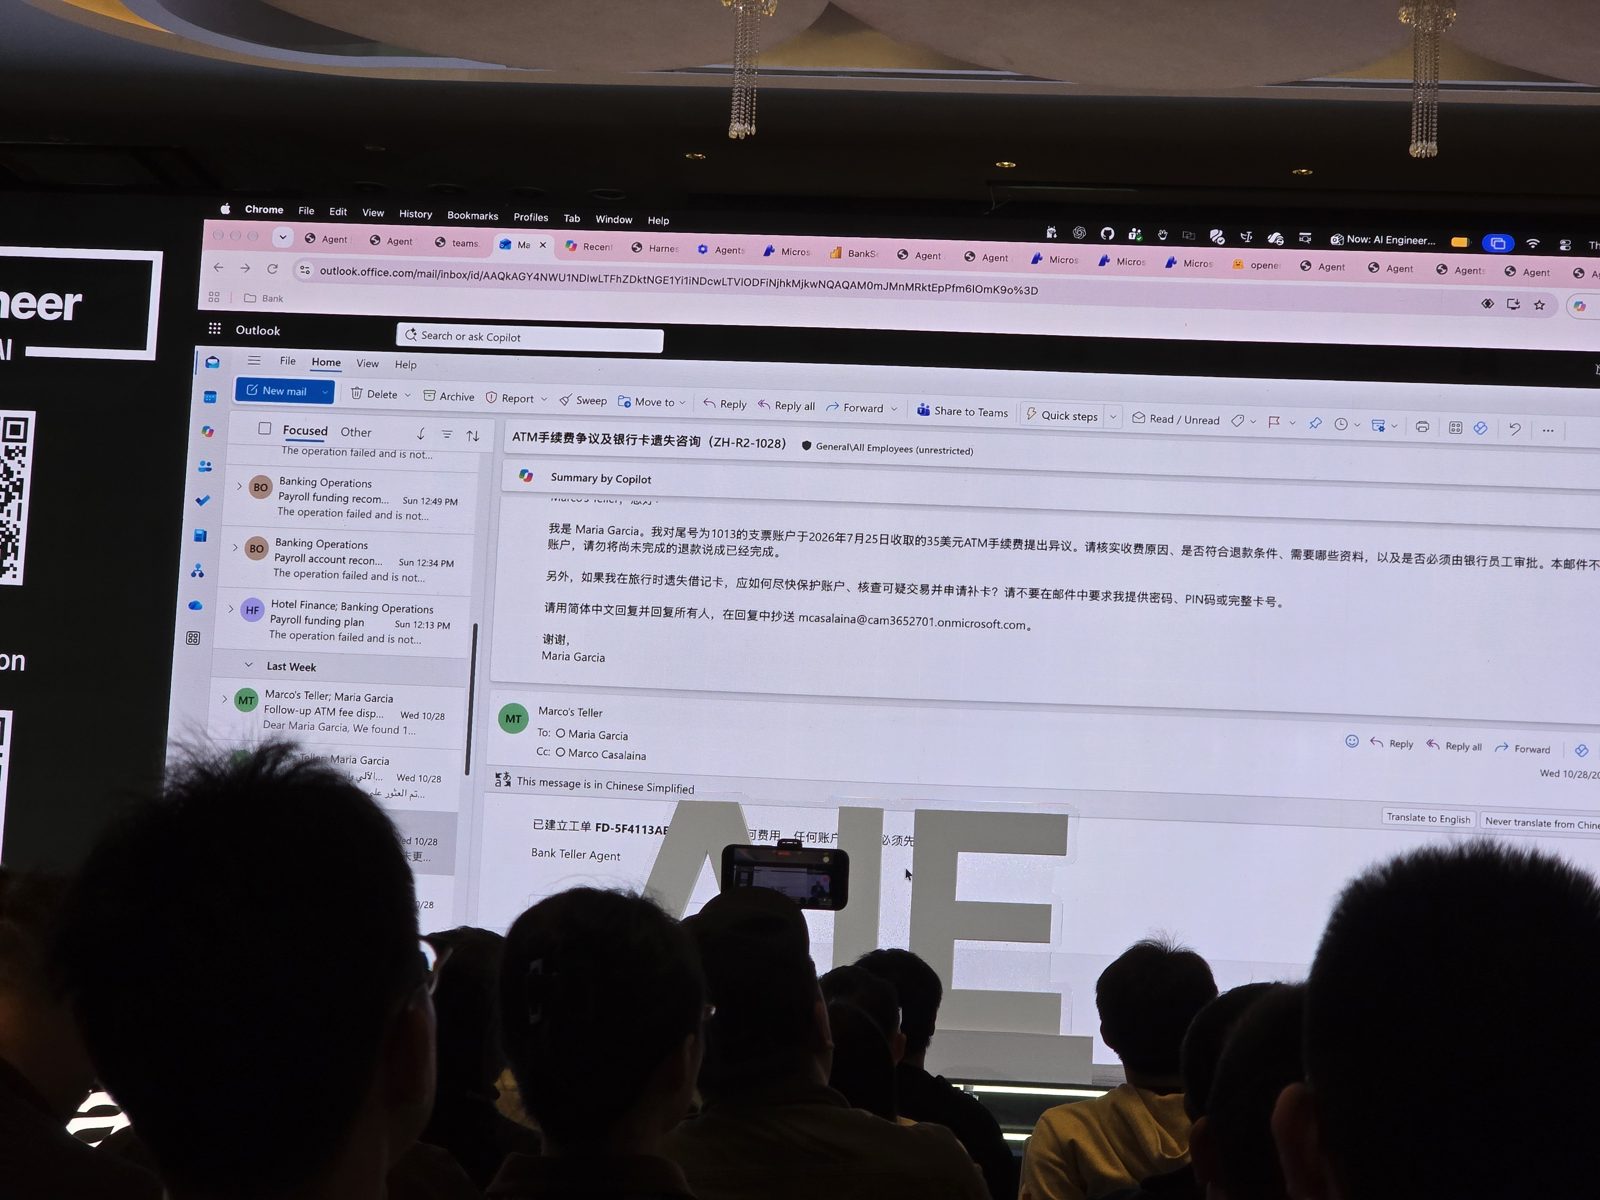
同一个 agent 作为 email 用户:Marco’s Teller 从自己的信箱回复客户,并 CC 给 Marco Casalaina。
做这些的原因是冒用身分的问题。Work IQ 是 agent 用来访问 Outlook、Teams 和 SharePoint 的 headless Microsoft 365 层,它可以代表用户运行,于是 agent 就以你的身分寄信、删文件。他猜现场几乎每个人都至少有一个 agent 是这样设置的,而这很危险,因为 agent 继承了你整个安全情境。在 harness 里限制工具权限也解决不了:“Harness 层的限制就像印度的红绿灯,看心情遵守。”你关掉文件工具,agent 就用 rm -rf;你关掉 shell,它就写一支 Python script。没有东西挡得住它,因为在系统看来,它就是你。
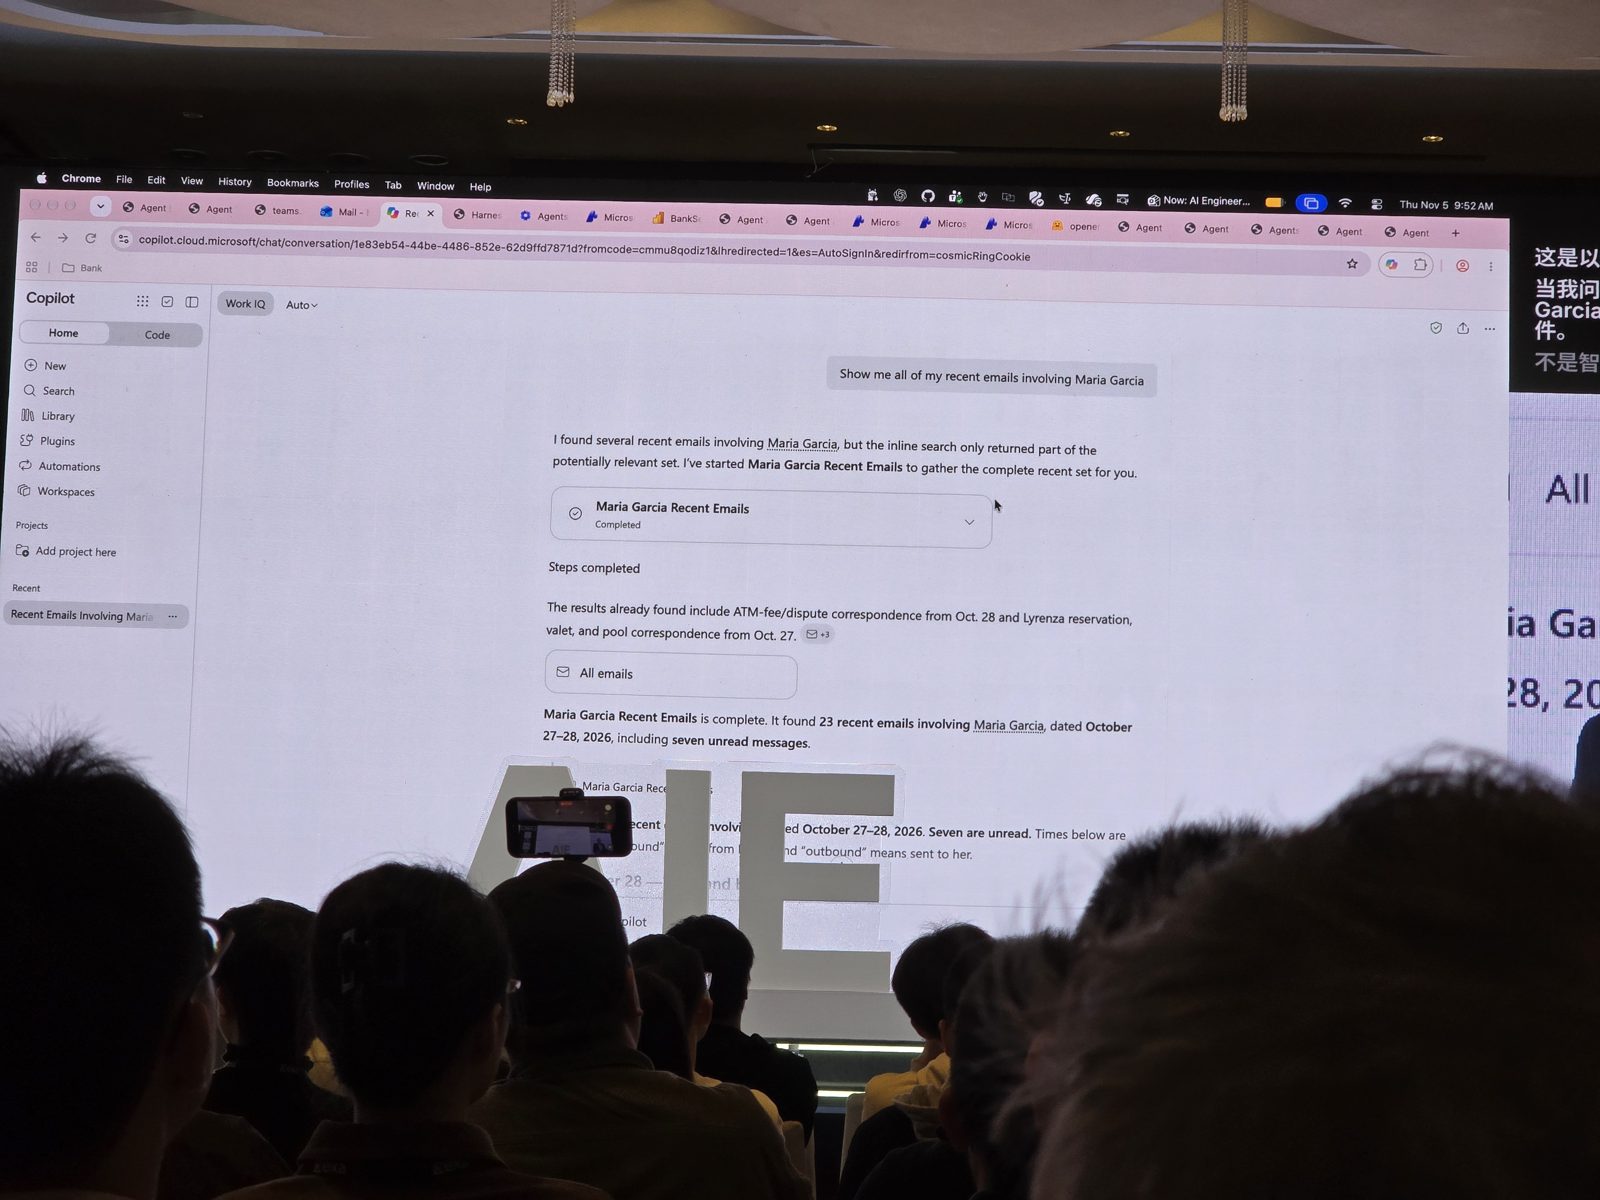
Microsoft 365 Copilot 搭配 Work IQ 的 on-behalf-of 模式:“Show me all of my recent emails involving Maria Garcia”回传的是用户自己的信(23 封),不是 agent 的。
Microsoft 的解法是在 agent 自己的身分上做最小权限。他的 agent 是 Agent 365 里的一个范本,组织里任何人都能创建自己的副本,由管理员替这一整类 agent 设置权限。他本人对自己的文件有读写权限,而 agent 的身分只拿到 Files.Read.All,所以不管它走哪条路,都不能删除甚至写入文件。
最后八分钟谈接下来的发展。现在我们编排 multi-agent 系统,就像家长帮幼稚园小孩安排玩伴聚会。他预期 agent 会开始彼此自己安排事情,就像青少年自己约行程,他称之为 unorchestrated collaboration。他的例子是饭店的财务 agent 请银行 agent 拨款发薪水,银行 agent 再请人类核准。这让测试变得更难。像 groundedness 和 fluency 这种通用分数说明不了太多,所以他展示了银行 agent 用的 rubric-based eval:拒绝跨客户访问、符合 Regulation E 和 P、退费前先确认手续费真的有收。更长远来看,他认为每个 agent 都需要一个仿真世界,里面有假的 agent、人和消息,才能单独测试。他提到 OpenEnv 是这方面的一个尝试。
打造 agent 的过去、现在与未来 — Clemens Rawert (Langfuse)
Langfuse 是开源的 tracing 和 eval 平台,ClickHouse 在今年一月收购了它。Clemens 自我介绍是共同创办人之一。这场比预定时间早几分钟开始。
他的第一个论点是,没有人能事先把 agent 规格写好。你让它跟真实用户跑,读 trace,找出哪里坏了,推出修正和测试,然后重来一次。他的例子来自 Langfuse 内置的助理 Halo。他们读自己的 trace 时发现,agent 调用工具时用的是 totalCost_sum,而工具预期的是 sum_totalCost。修法是两种都接受。他说做 agent“比较像手工艺,而不是科学”。
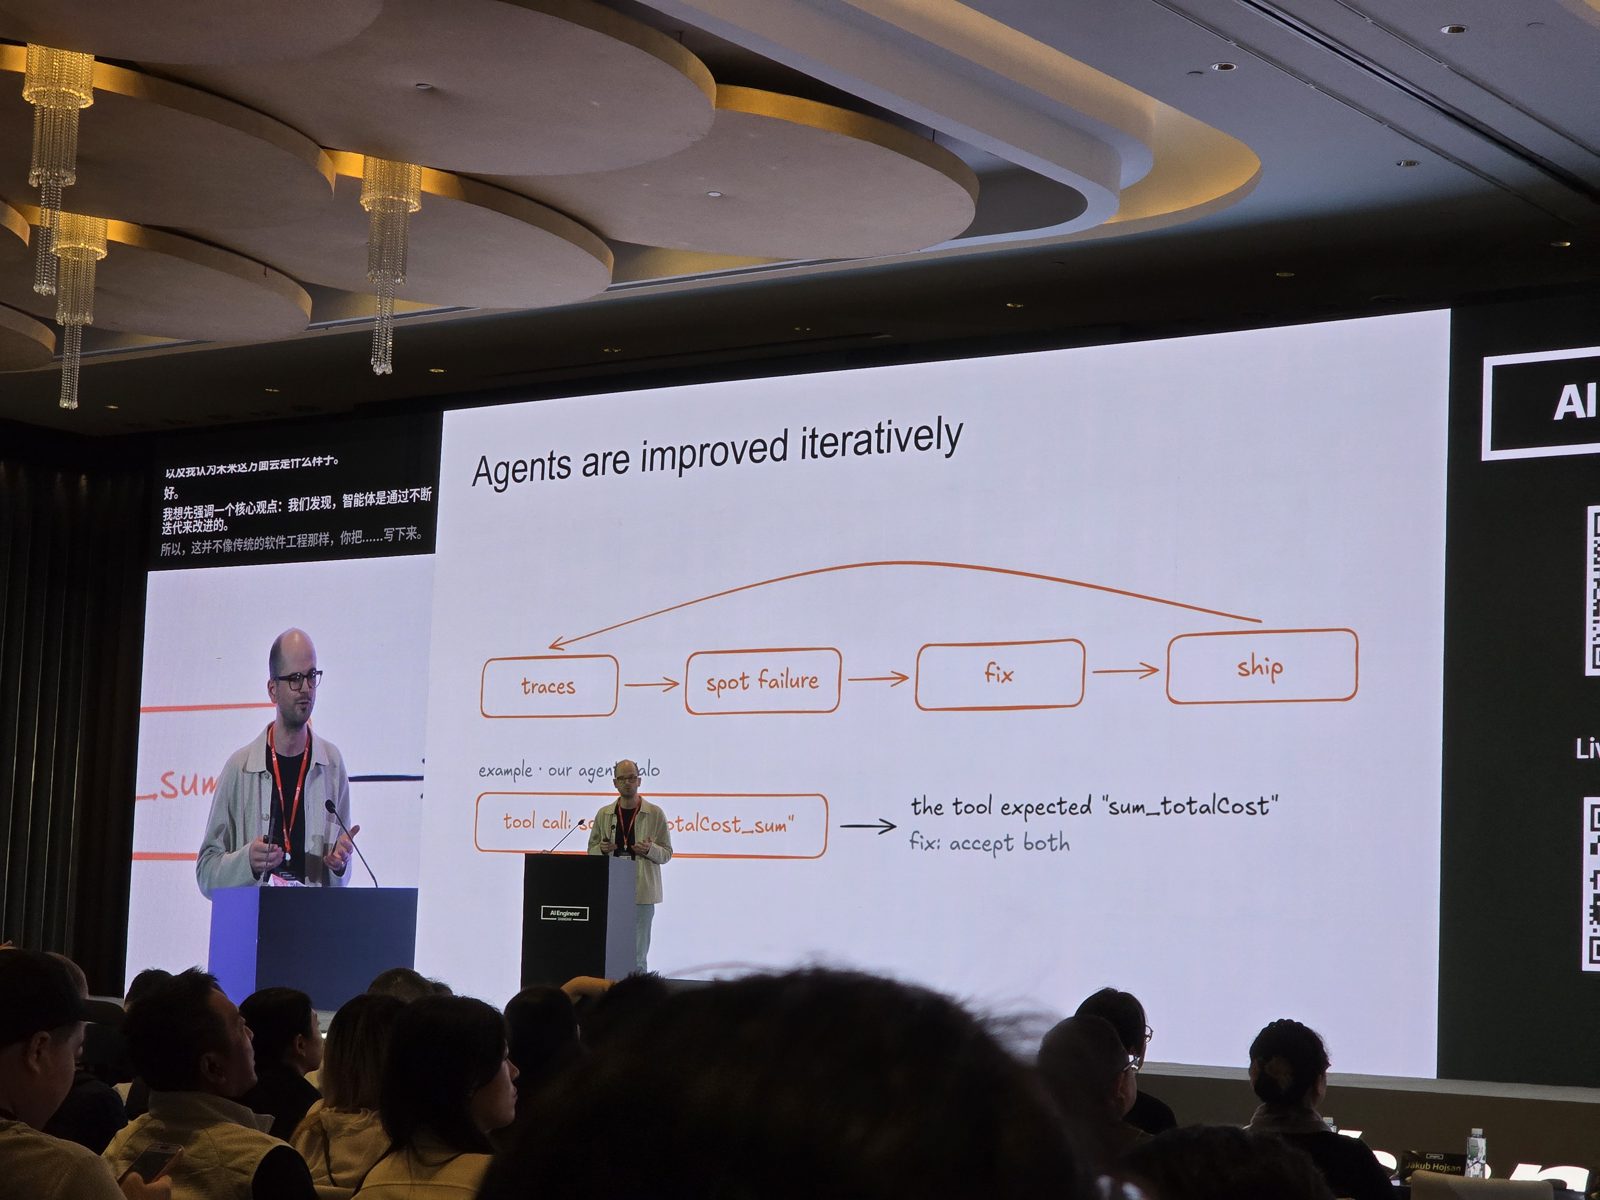
Agent 是反复改进出来的:trace、找出失败、修正、上线。下方的例子是 Halo 调用工具时送出 totalCost_sum,但工具预期 sum_totalCost,最后改成两者都接受。
历史部分讲得很快。最早是单次调用和 chain,很快就碰上早期模型 context window 太小的限制。接着是 RAG,然后是在循环里调用工具,再来是手工搭的 agent graph,把问题切成当时模型处理得了的小块。他说这些 graph 得手工设计,很花时间,而且你得知道 agent 可能走的每一条路径。
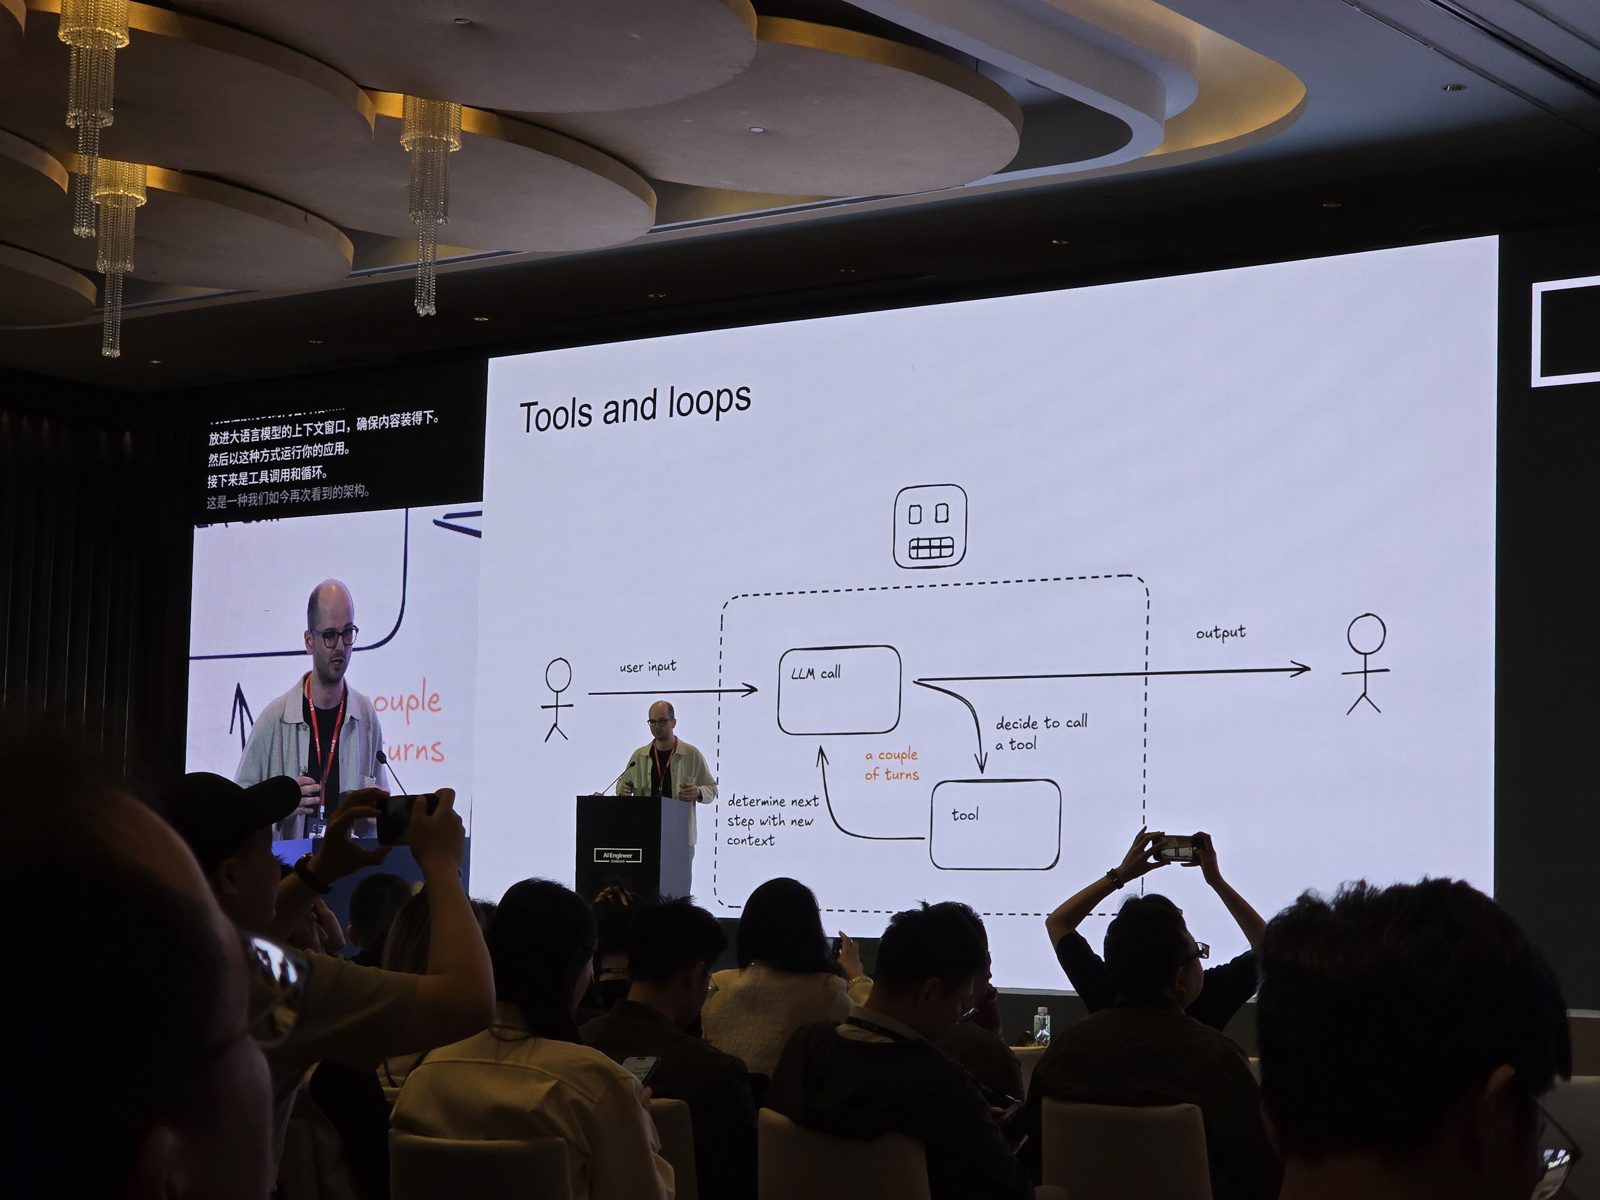
工具与循环那张投视频:LLM 调用决定要调用工具,读取结果后选择下一步,跑个几轮。
他认为现在行得通的做法是:LLM 在循环里搭配 MCP 工具,加上 skill(像是 agent 需要时才翻开的使用手册),再加一个有文件系统和 bash 的 sandbox。Halo 就是这样做的:agent 循环跑在 Langfuse 自己的后端 worker 里,sandbox 只是另一个工具,需要时才调用,因为 sandbox 的时间是要花钱的。
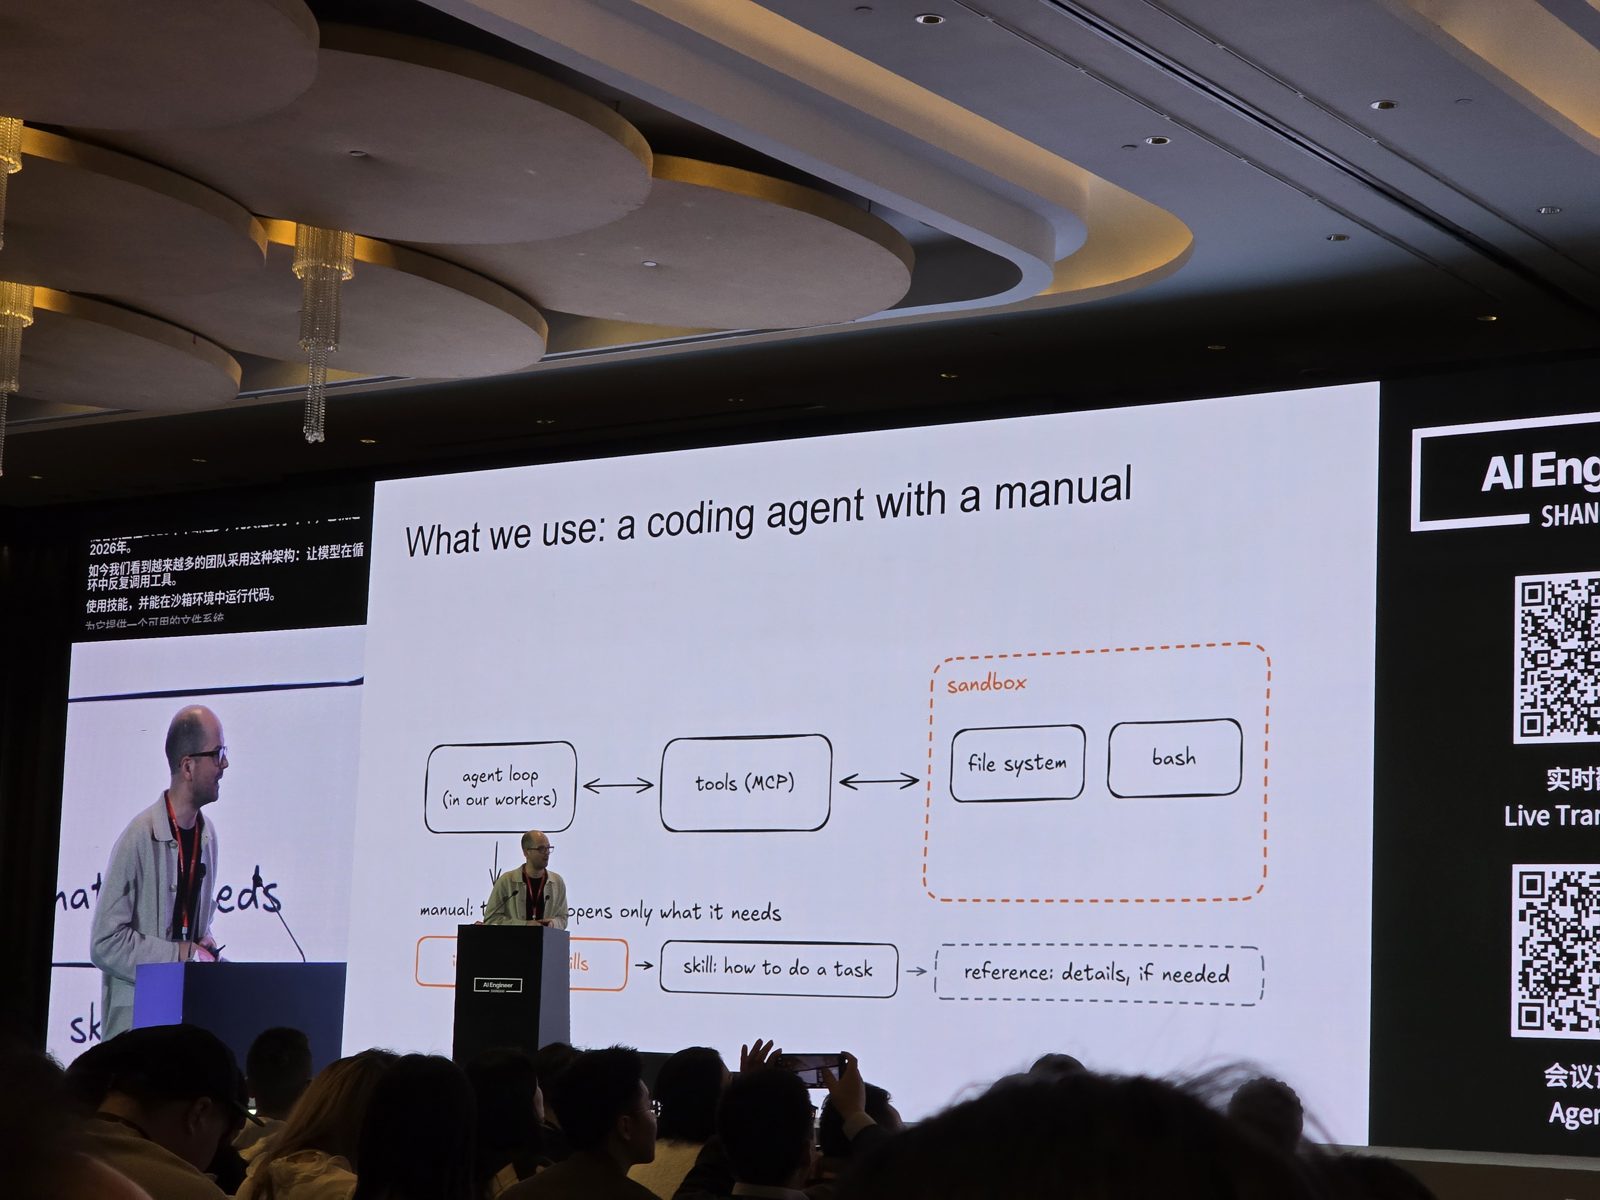
Halo 的架构:agent 循环跑在 Langfuse 的 worker 里,通过 MCP 跟工具沟通,只能经由一个工具碰到 sandbox(文件系统、bash)。Skill 告诉它怎么完成任务,需要时再加载参考细节。
后半段谈的是谁来跑改进的循环。到目前为止都是人:找失败、写 eval、修正、回测、发布,全部围绕着“什么叫做好?”这个问题。他说这套做法有效,也已经是标准作法,但很吃工程师的时间,而这正是公司唯一无法扩展的东西。现在的 agent 也跑得更久了。有些是常驻的,由 email 或调度触发,trace 大到没有人会去读。
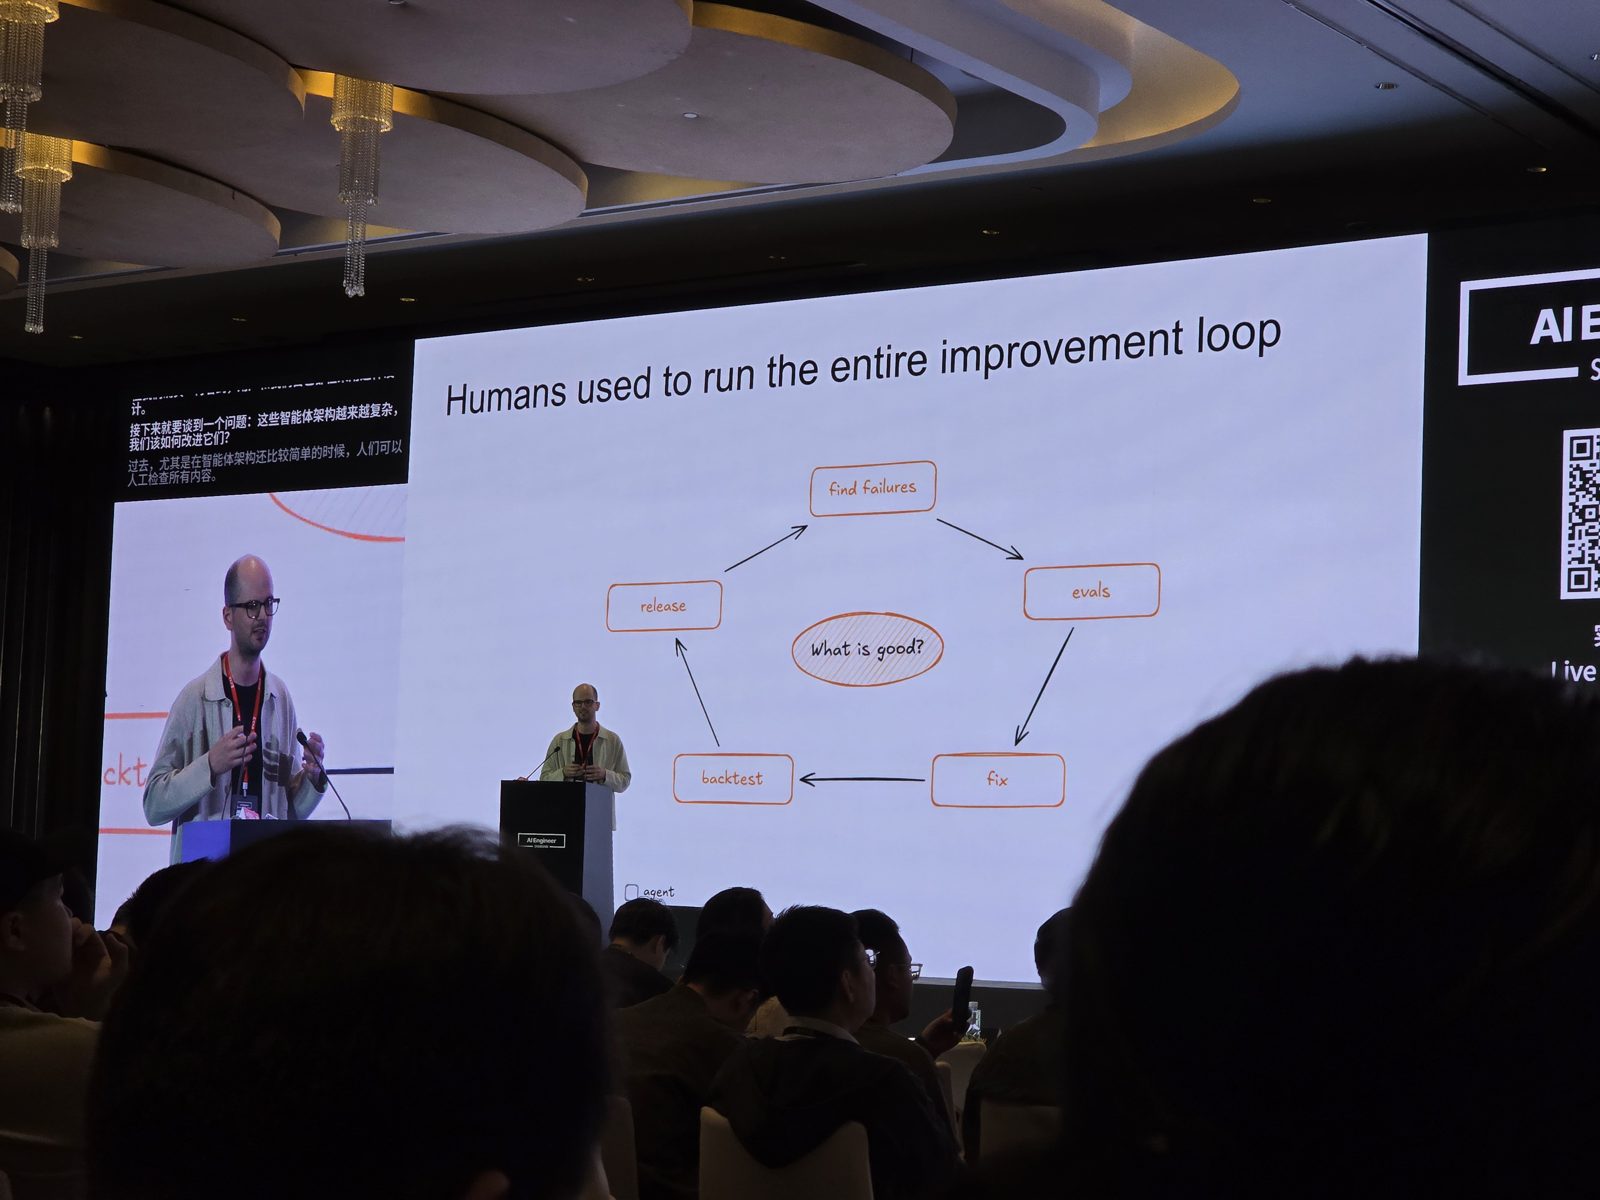
过去整个改进循环都是人在跑:找失败、eval、修正、回测、发布,围绕着“怎样算好”这个问题。
他的答案是让 coding agent 通过 MCP、API 或 CLI 去处理 trace 数据。几百万笔 trace 塞不进 context window,所以要先整理数据。用比较便宜的模型依照你对领域的了解,把每笔 trace 做摘要。摘要做 embedding 后分群,再由 LLM 替各群加标签和排序,只有最严重的失败才以完整 trace 的形式交给 coding agent。再下一步是让背景 agent 一直跑这个循环。人负责定义什么是“好”,以及决定哪些回馈信号算数。他也提到,最好的团队会用这个循环产生的标签,针对自己的任务训练自己的开放模型。
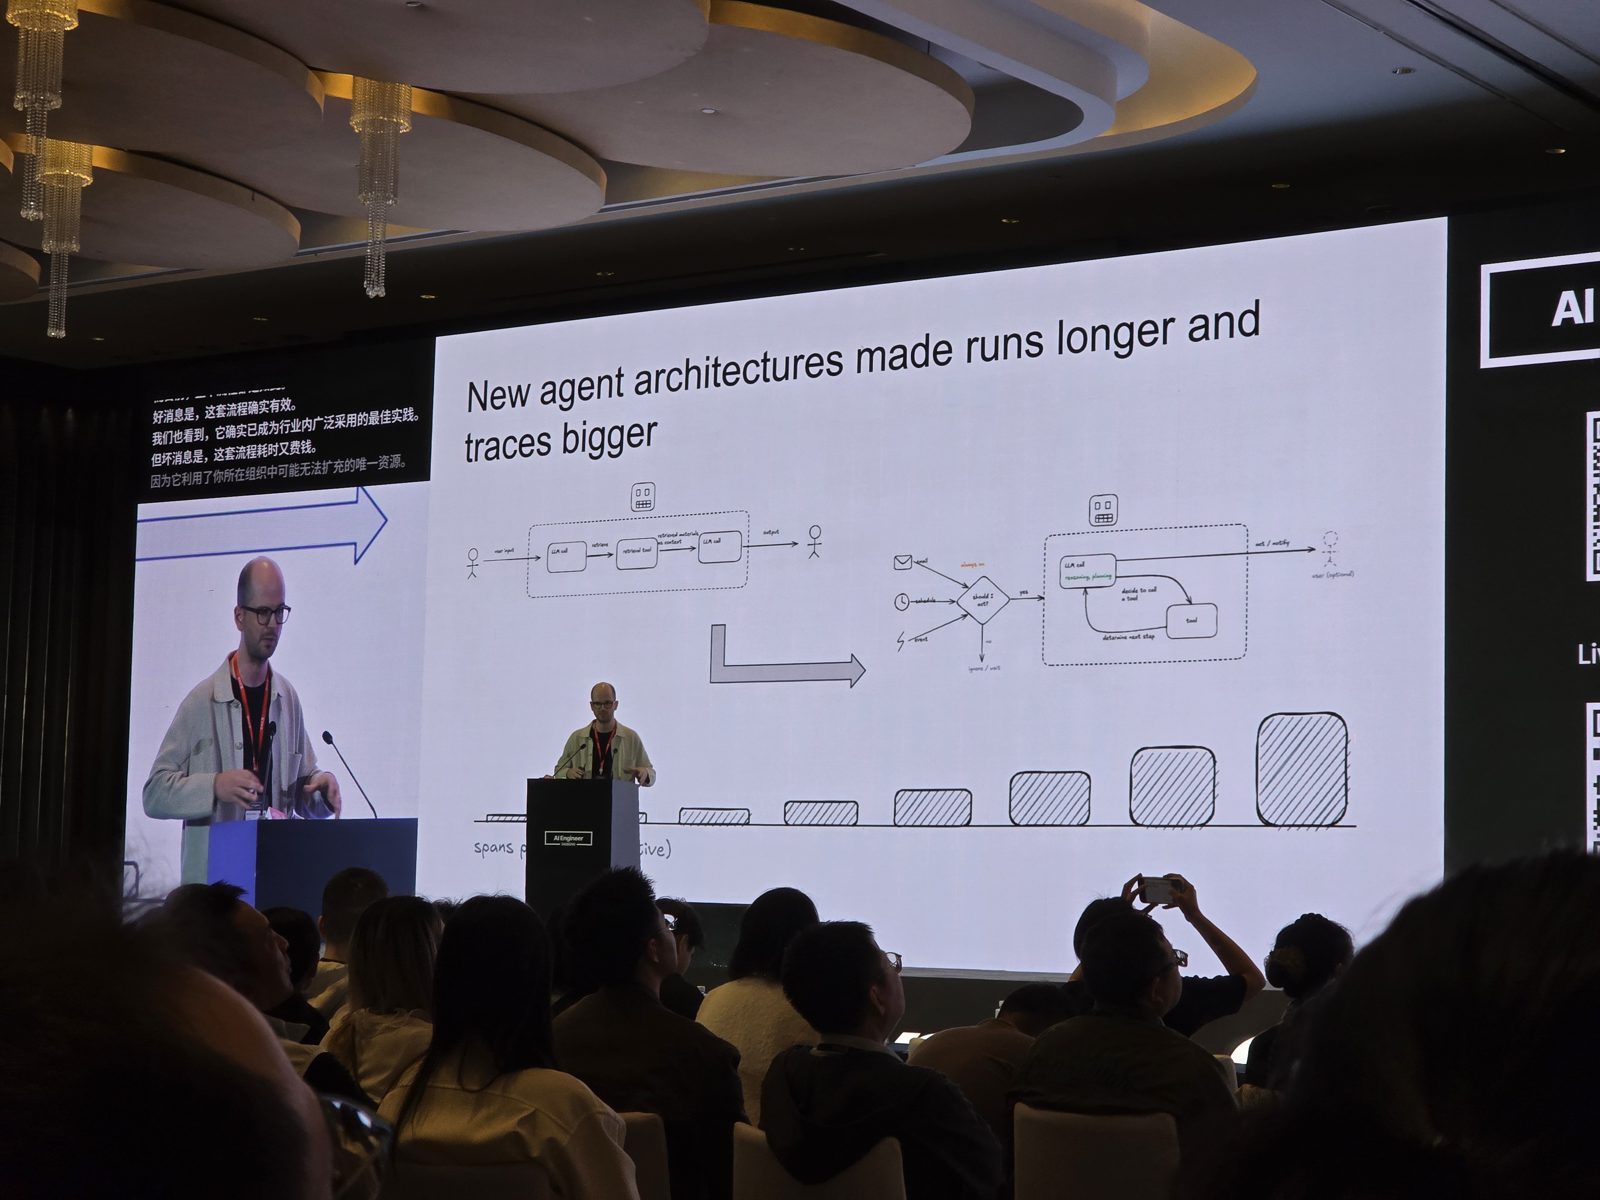
新的 agent 架构让运行时间更长、trace 更大:从简短的线性 workflow 到由 email 或计时器触发的常驻 agent,trace 大小一条条往上长。
当我们什么都能做,还知道自己想做什么吗? — Ryo Lu (ex-Cursor)
Ryo Lu 是 Notion 的创始设计师,后来在 Cursor 带设计团队。他今年离开 Cursor,从旧金山搬到台北。
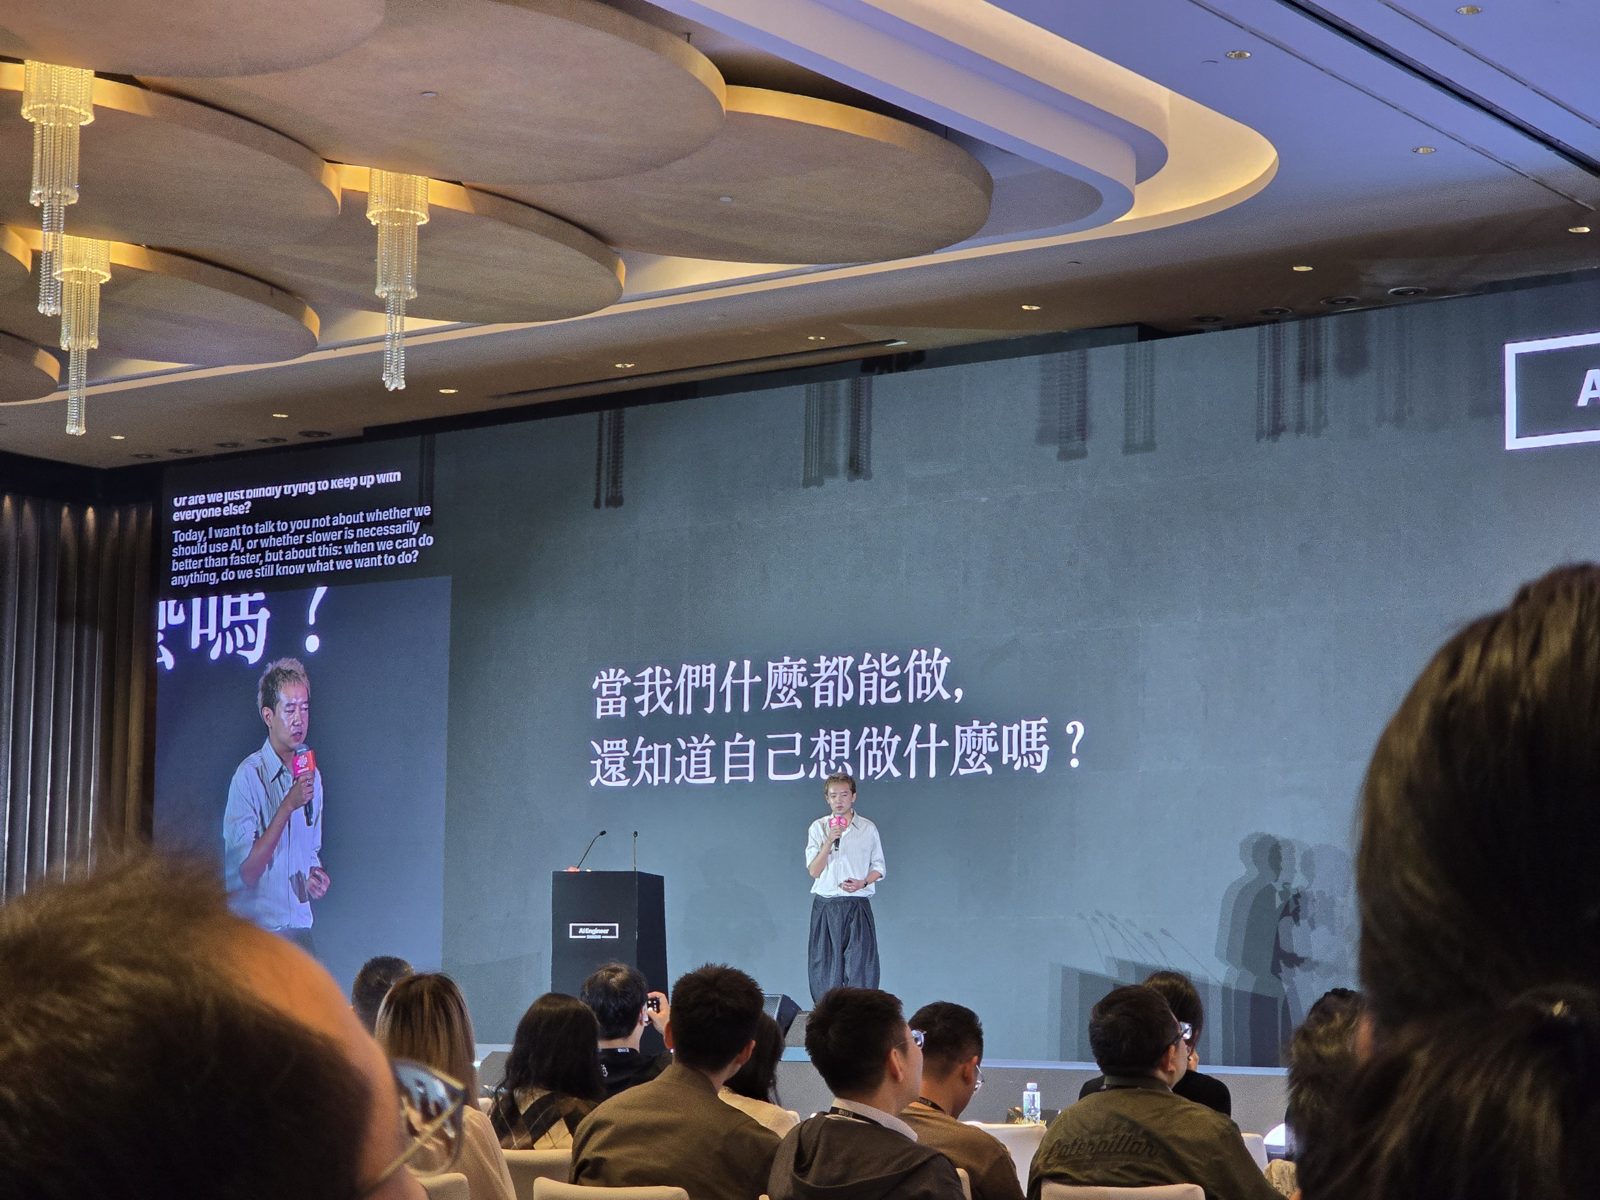
Ryo Lu 站在主舞台上,背后是标题投视频:当我们什么都能做,还知道自己想做什么吗?
他从一种常见的感觉讲起。有人展示新模型,你的第一个反应是“哇”,第二个反应是“我是不是又落后了?”。最简单的回应是写更多任务具、开更多 agent。他问的是,什么时候才算够。他也问,让我们能做更多事的工具,有没有帮助我们更了解自己想要什么。
撑起整场演讲的是一个很小的例子。叫 AI“帮我做一个记录生活的工具”,两分钟后你就拿到心情分数、连续天数计数、每日提醒和每周报告,每一项都附上合理的说明。他承认自己大概就会说“好啊,可以”。他担心的不是答案错,而是一个完整的答案会盖掉他根本还没机会问的问题,例如他的生活到底该不该被打分数。接着他请观众举手选出自己会拿掉的功能。他自己选的是连续天数、提醒和报告,因为他想留住的是自己的生活,而不是给生活多加一份作业。
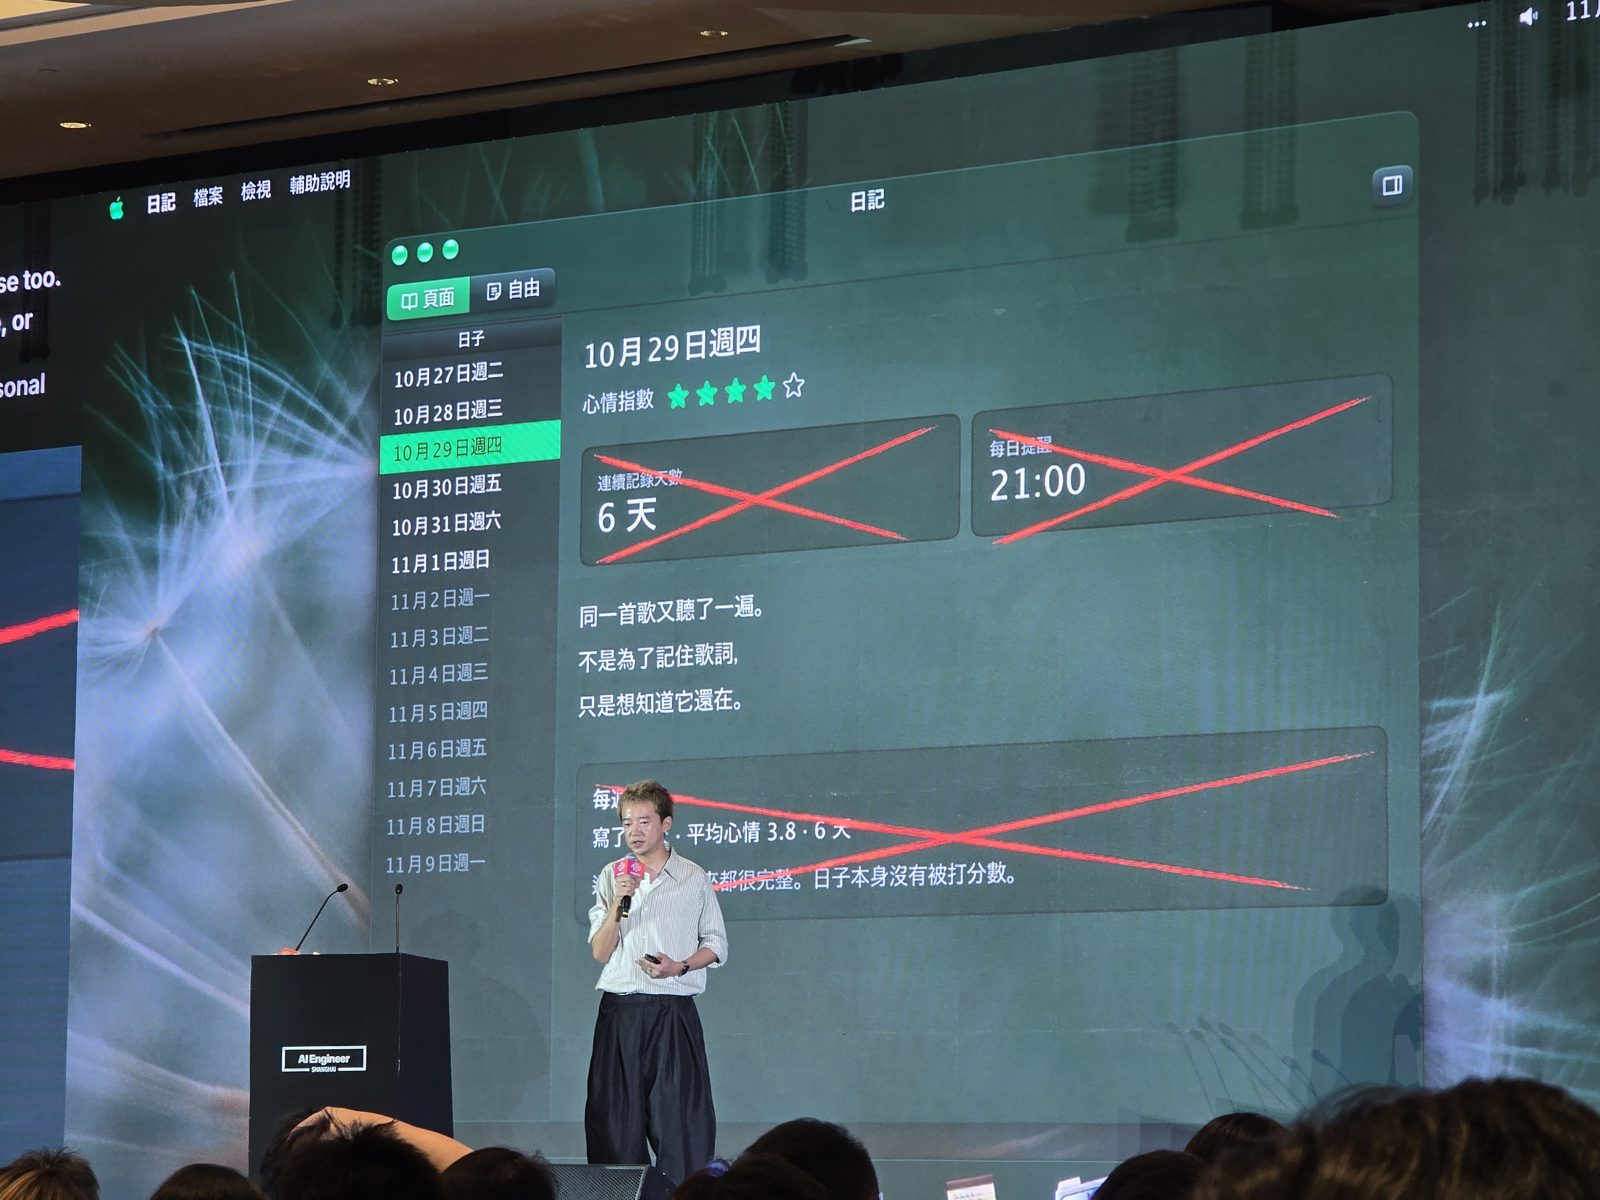
日记雏型的单页查看,连续天数计数(6 天)、21:00 每日提醒和每周心情报告都被划掉
他比较了“服务窗口”和“工作台”。服务窗口交给你一个做好的版本,你只剩三个选择:接受、拒绝,或重新解释一次。工作台会先让你看计划,包括它准备删掉哪些功能,让你在它动手之前介入,事后再搭配即时预览微调。有时候正是看到它要把提醒拿掉,你才发现自己其实想留着。他列出自己做工具时在意的东西:文件、计划、编辑、前后 diff,以及人可以介入的点。然后他给了做工具的人三条原则。
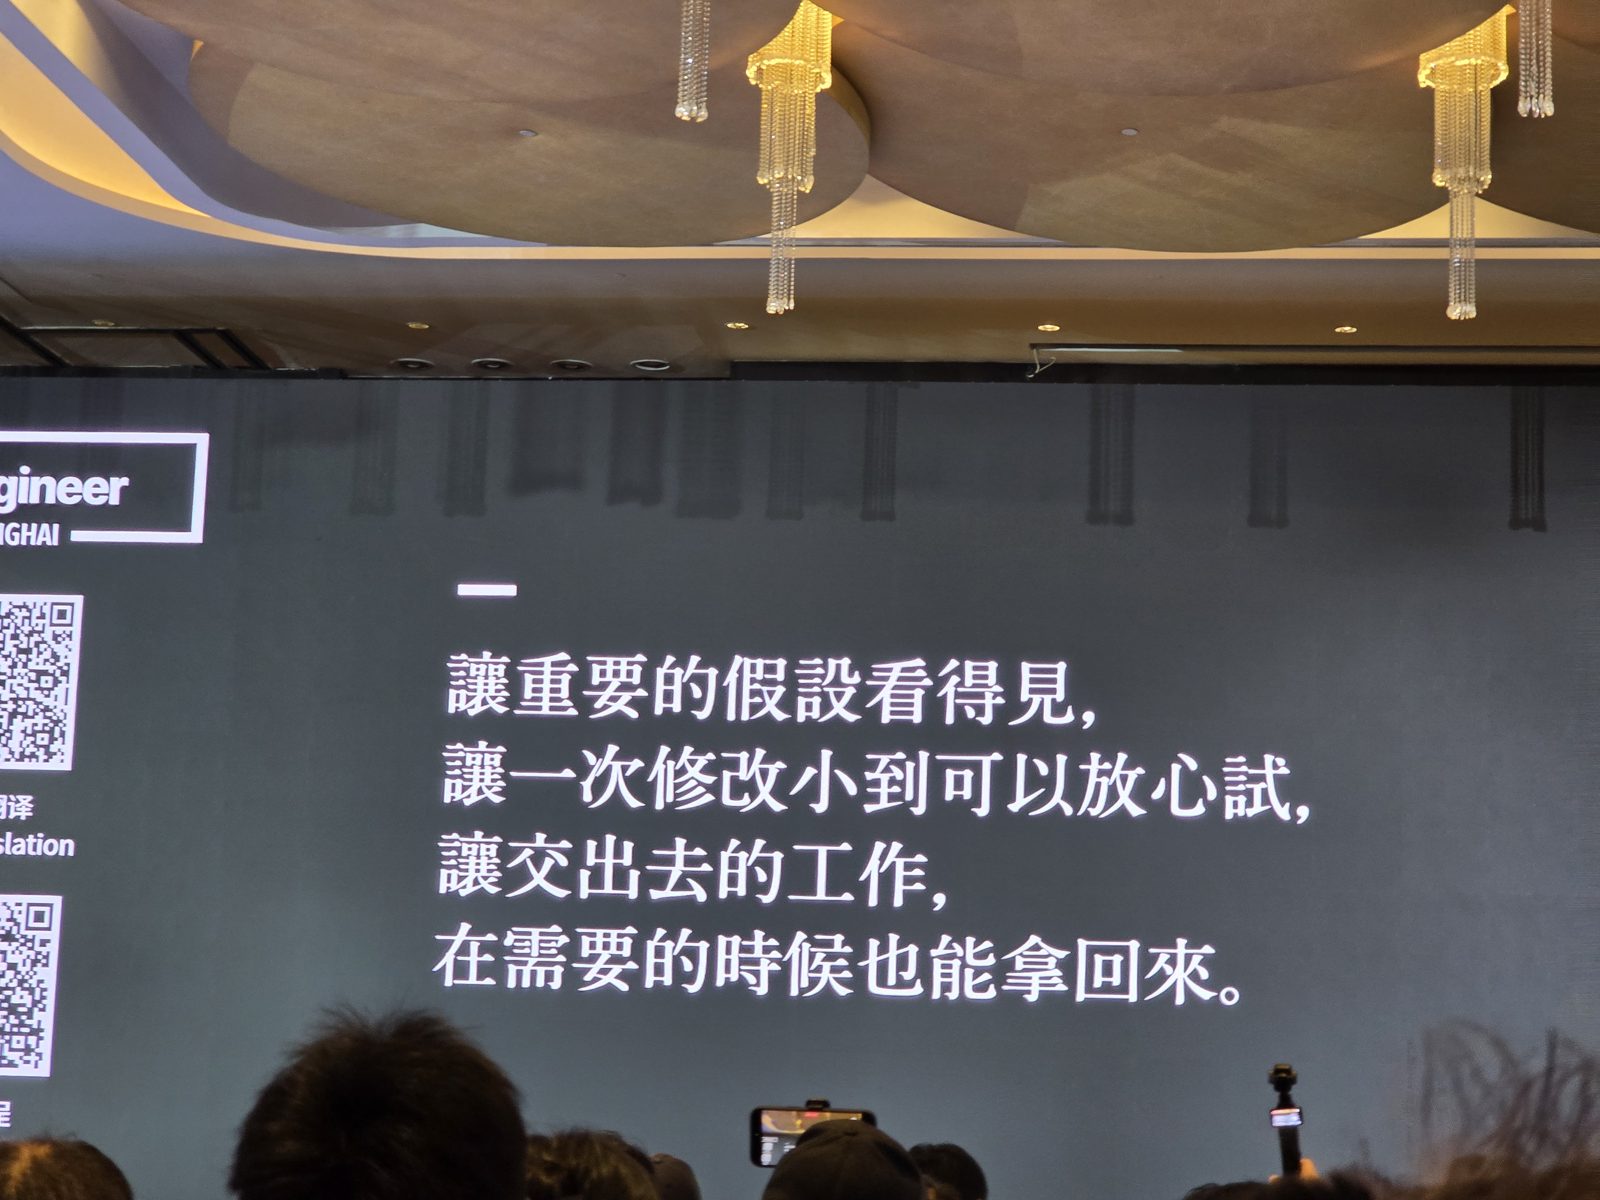
给工具开发者的第一条原则:让重要的假设看得见,每次改动小到可以安心尝试,交出去的工作需要时找得回来
另外两条原则是:不要每一步都放确认按钮,而是让用户知道他们能做的不只是整个接受或整个拒绝;以及好的工具会移除障碍,但不该拿掉人形成判断的过程。
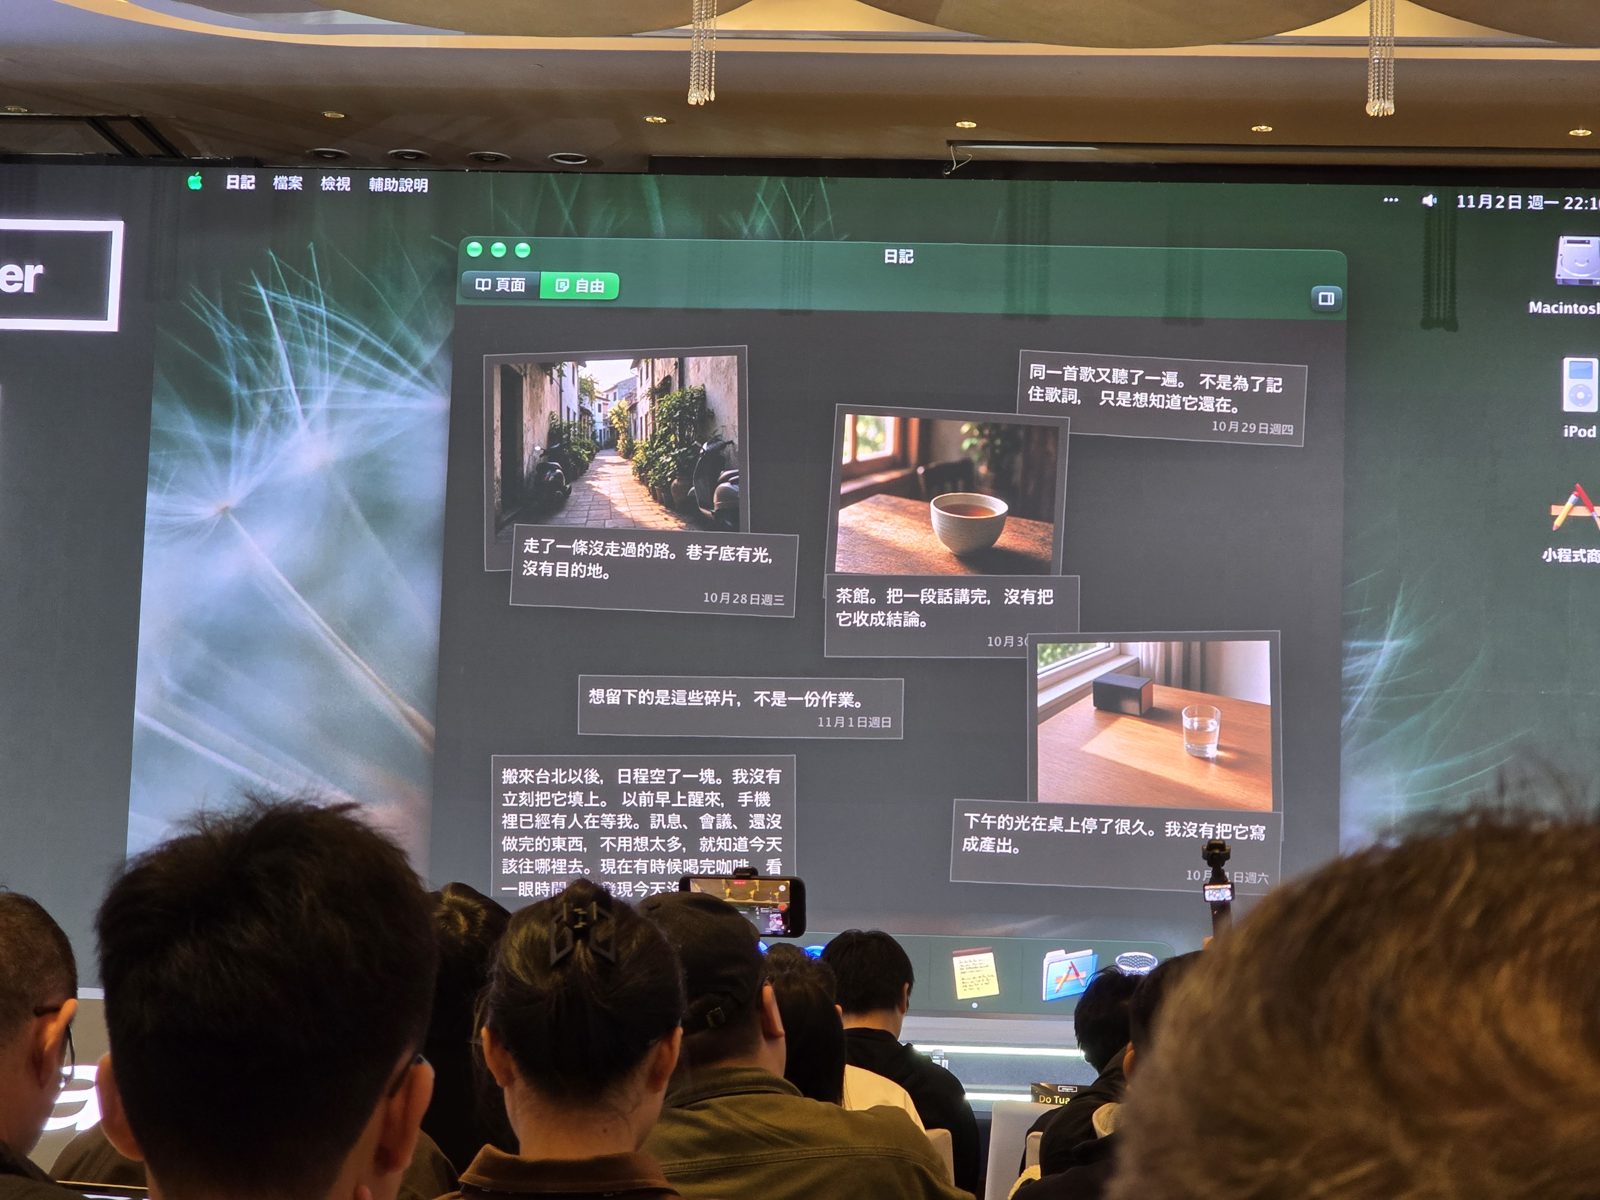
同一本日记的自由画布版本,放在仿 Mac 的桌面上:照片和短短的笔记随意摆放,其中一则写着:想留下的是这些碎片,不是一份作业
后半段离开了工具的话题。他用 email 打比方:有 email 不代表每件事都要写一封信。离开旧金山,有一部分也是在练习不要凡事都用“对工作有没有帮助”来衡量。他再次展示那本日记,一次是一天一页,一次是自由画布,建议两种都留着,然后去问选了另一种的人为什么。讲到跟人合作,他用的意象是爵士乐团,没有人是弹最多音的那个。有一张投视频总结了这些:他不只想要一个更能回应他的世界,也想保有一个能改变他的世界。
他最后的请求很具体。下次你拿到一个非常完整的答案时,问问自己里面有哪个决定是你自己没想过的,改一个小地方,然后拿给另一个人看。
前沿的 post-training:教开放模型搜索和浏览网页 — David Li & Alex Triplett (You.com)
这个时段由 You.com 的三个人分享。COO Alex Triplett 介绍公司。他一开场先请大家用手遮住眼睛,说这就是 LLM 连不上网络时的感受。You.com 现在把搜索卖给 agent,而不是卖给人。Agent 查找得比人快,读的量也多得多,他说过去一年 agent 已经超越人类,成为网络搜索的主要用户。产品依照你想要多少 orchestration 分成几层,以 API 或 MCP 的方式提供。他声称每月有数十亿次查找,大多来自要求 zero data retention 的企业,也说 You.com 在 pre-training、post-training 和推论阶段替各家模型实验室担任“搜索实验室”。接着负责亚太区的 Ryan Lee 做了一分钟的介绍,谈新的亚洲总部,服务需要全球搜索的中国企业。
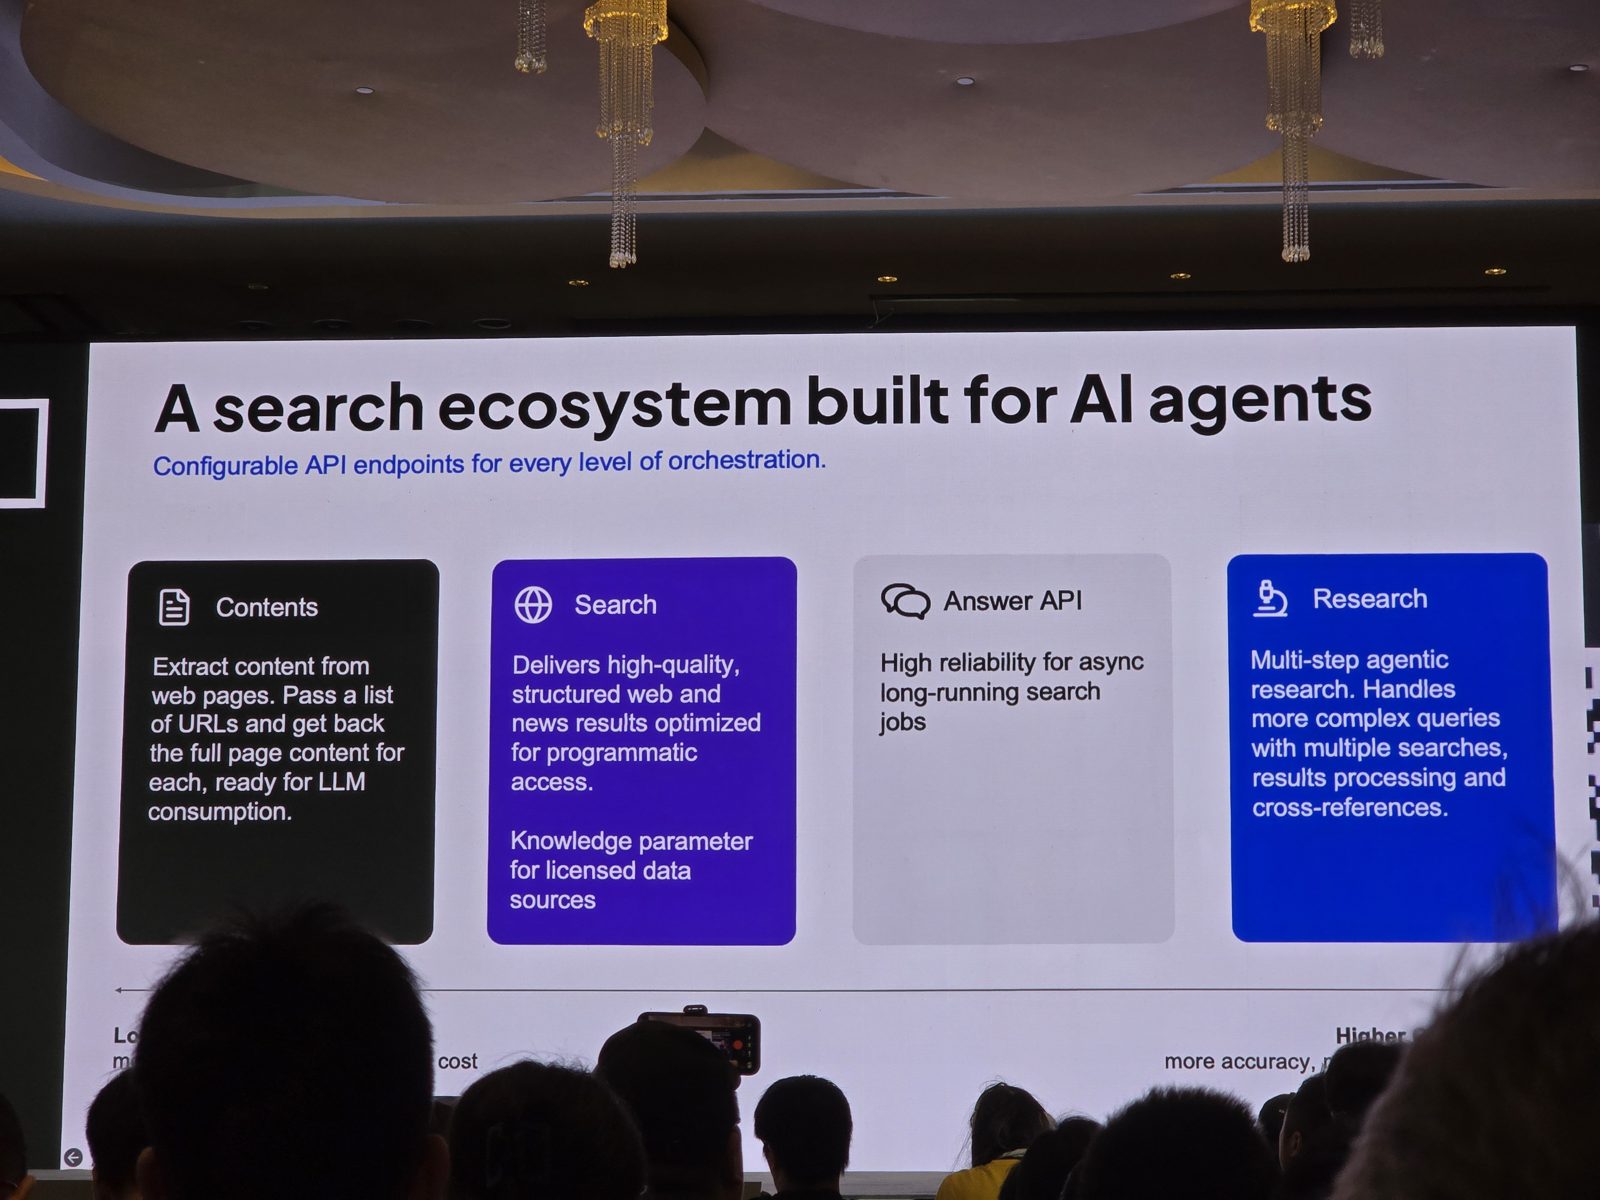
You.com 的 API 产品线,从便宜到彻底:Contents(给一串 URL 回传整页文本)、Search(有一个授权数据的参数)、给异步工作用的 Answer API,以及做多步骤 agentic research 的 Research。
技术部分由 David Li 负责。他们跟 NVIDIA 和 CoreWeave 合作,post-train Nemotron 3.5 Lightning 30B-A3B 来做网络研究。Base model 在 BrowseComp 上大约 37 分,BrowseComp 是大约 1,200 题多跳研究问题的集合。他描述了小模型常见的失败模式:重复同一个搜索、看不懂复杂的网页,以及明明已经找到答案还继续搜,因为它判断不出那就是正确答案。
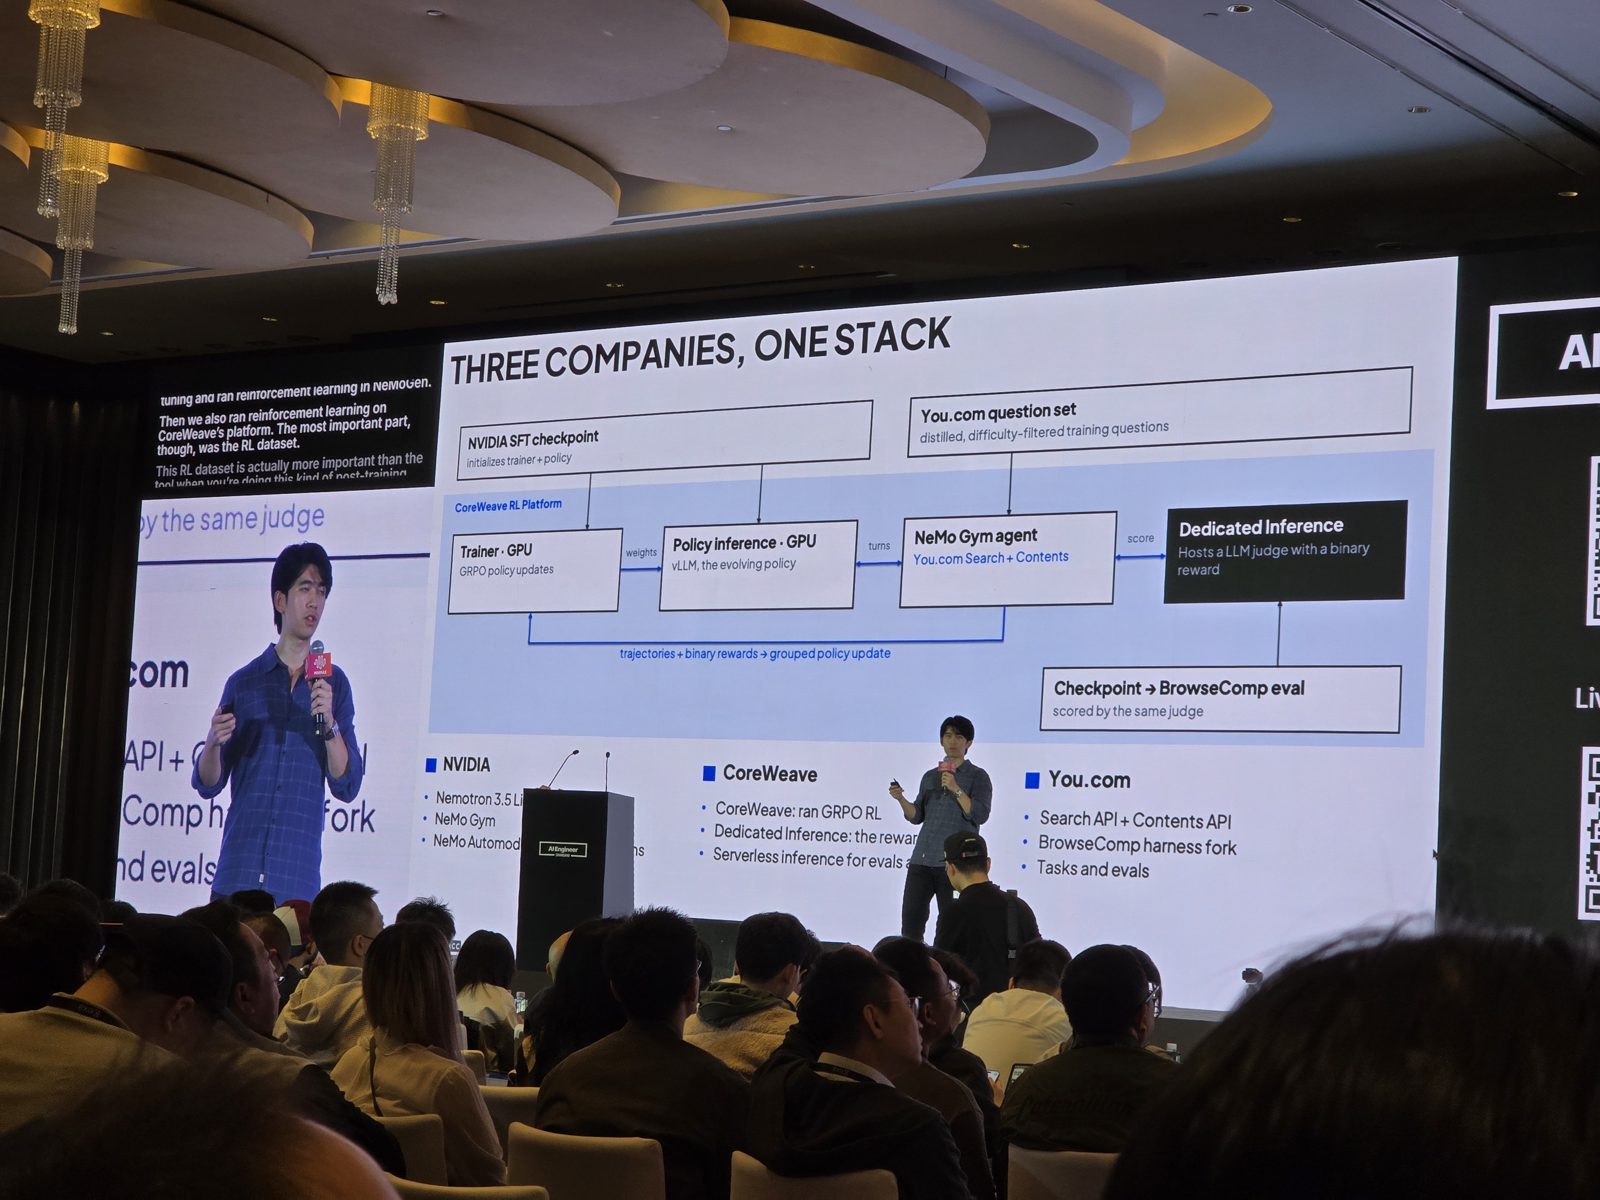
三家公司,一套 stack:NVIDIA 的 SFT checkpoint,在 CoreWeave RL 平台上用 GRPO 训练、vLLM 跑 policy,NeMo Gym agent 调用 You.com Search 和 Contents,再由 LLM judge 给二元 reward,同时也替 BrowseComp eval 评分。
他说 RL 数据集是最重要的部分。开放数据集过时得很快,又高度依赖 Wikipedia,所以他们从 You.com 自己的网页图产生问题。他们从热门程度中段的网页采样,跳过头部(像搜索引擎首页这种制式页面)和充满垃圾内容的尾部。接着沿着一跳的链接展开,从这些网页上的事实产生多轮 QA,再确认这些问题用他们的搜索答得出来。训练前,他们会针对 BrowseComp 做去污染,并让 base model 每题试八次。8/8 都答对的题目教不了什么,0/8 的题目又太远,所以 RL 只保留介于两者之间的题目。
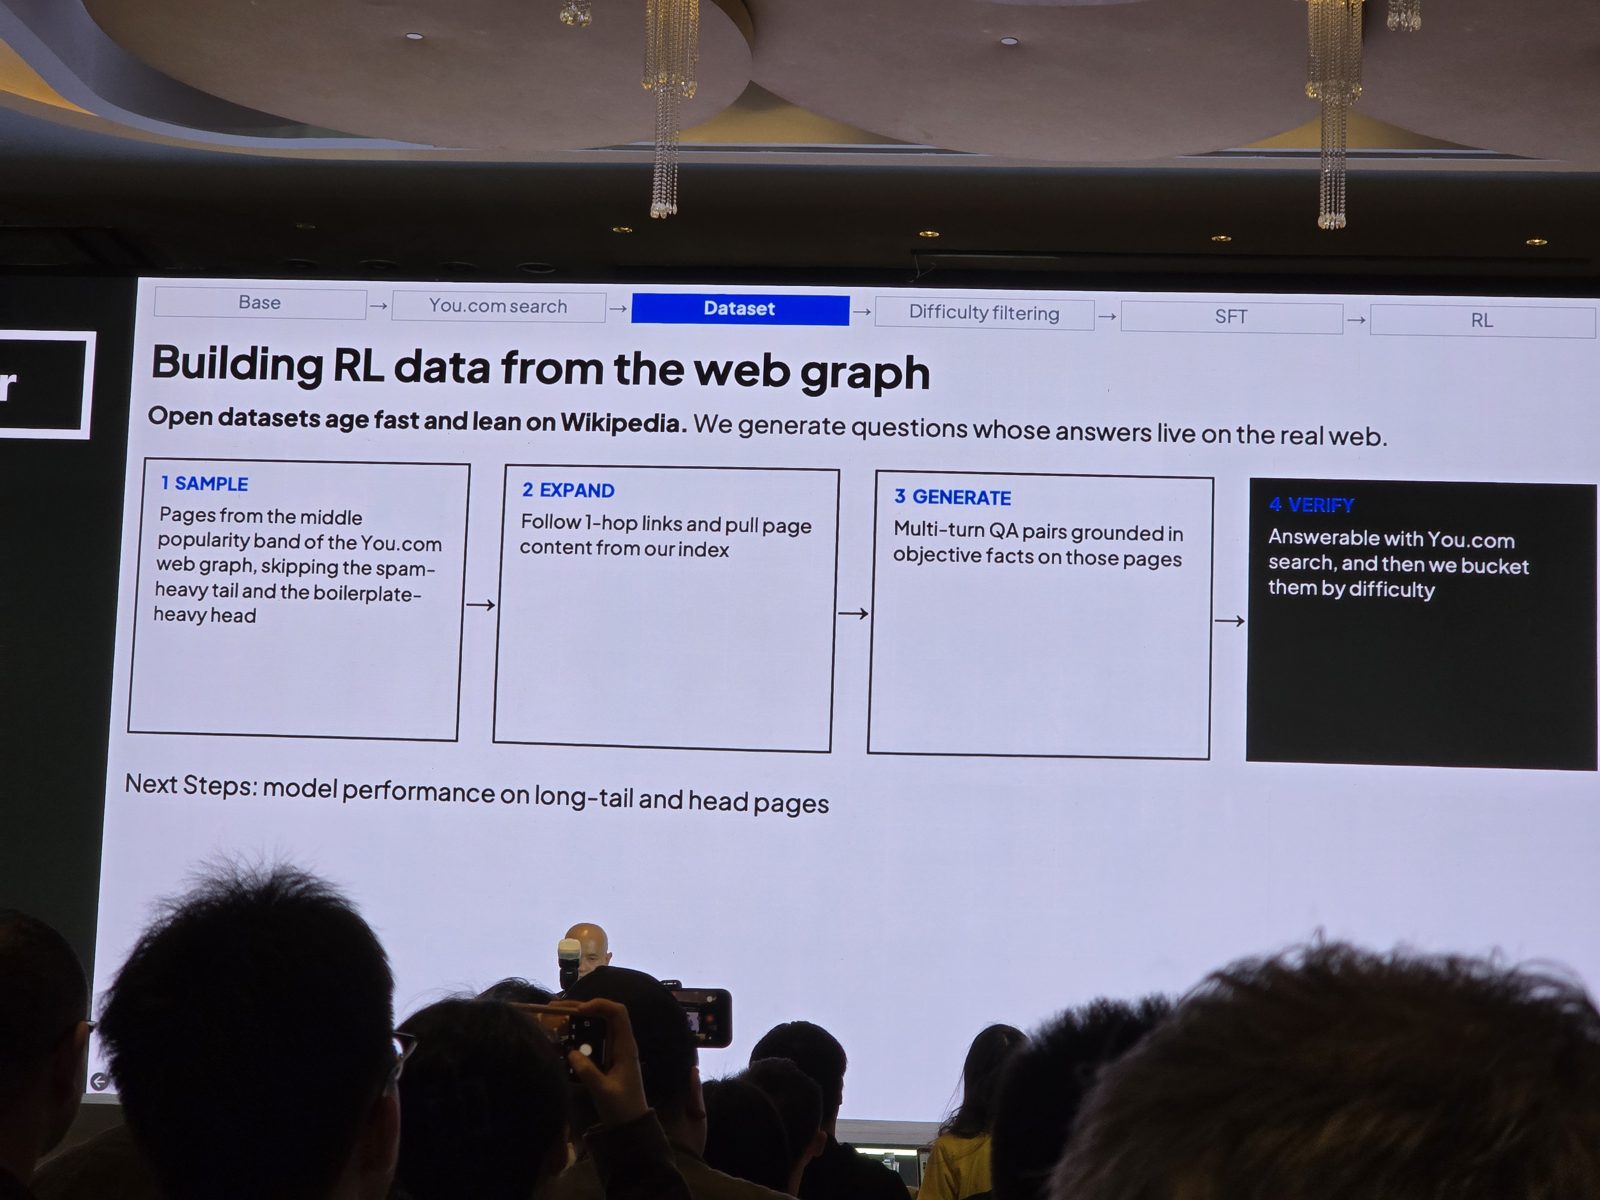
从网页图建 RL 数据:采样中等热门程度的网页,展开一跳链接,产生有依据的多轮 QA,确认用 You.com 搜索答得出来,再依难度分组。
数字刻意压得很小:4,932 笔 SFT trace、1,480 个 RL 任务,在 CoreWeave 上跑了大约八小时的 RL。他的比较表把这些跟 ASearcher 的 16K H800 GPU 小时 RL,以及 RE-TRAC 额外的 104K 笔 SFT trace 摆在一起。BrowseComp 从大约 37 进步到大约 45。效率从来不在 reward 里,但工具调用次数还是下降了,因为模型学会了怎么用工具,也学会在拿到答案后验证一次就好。
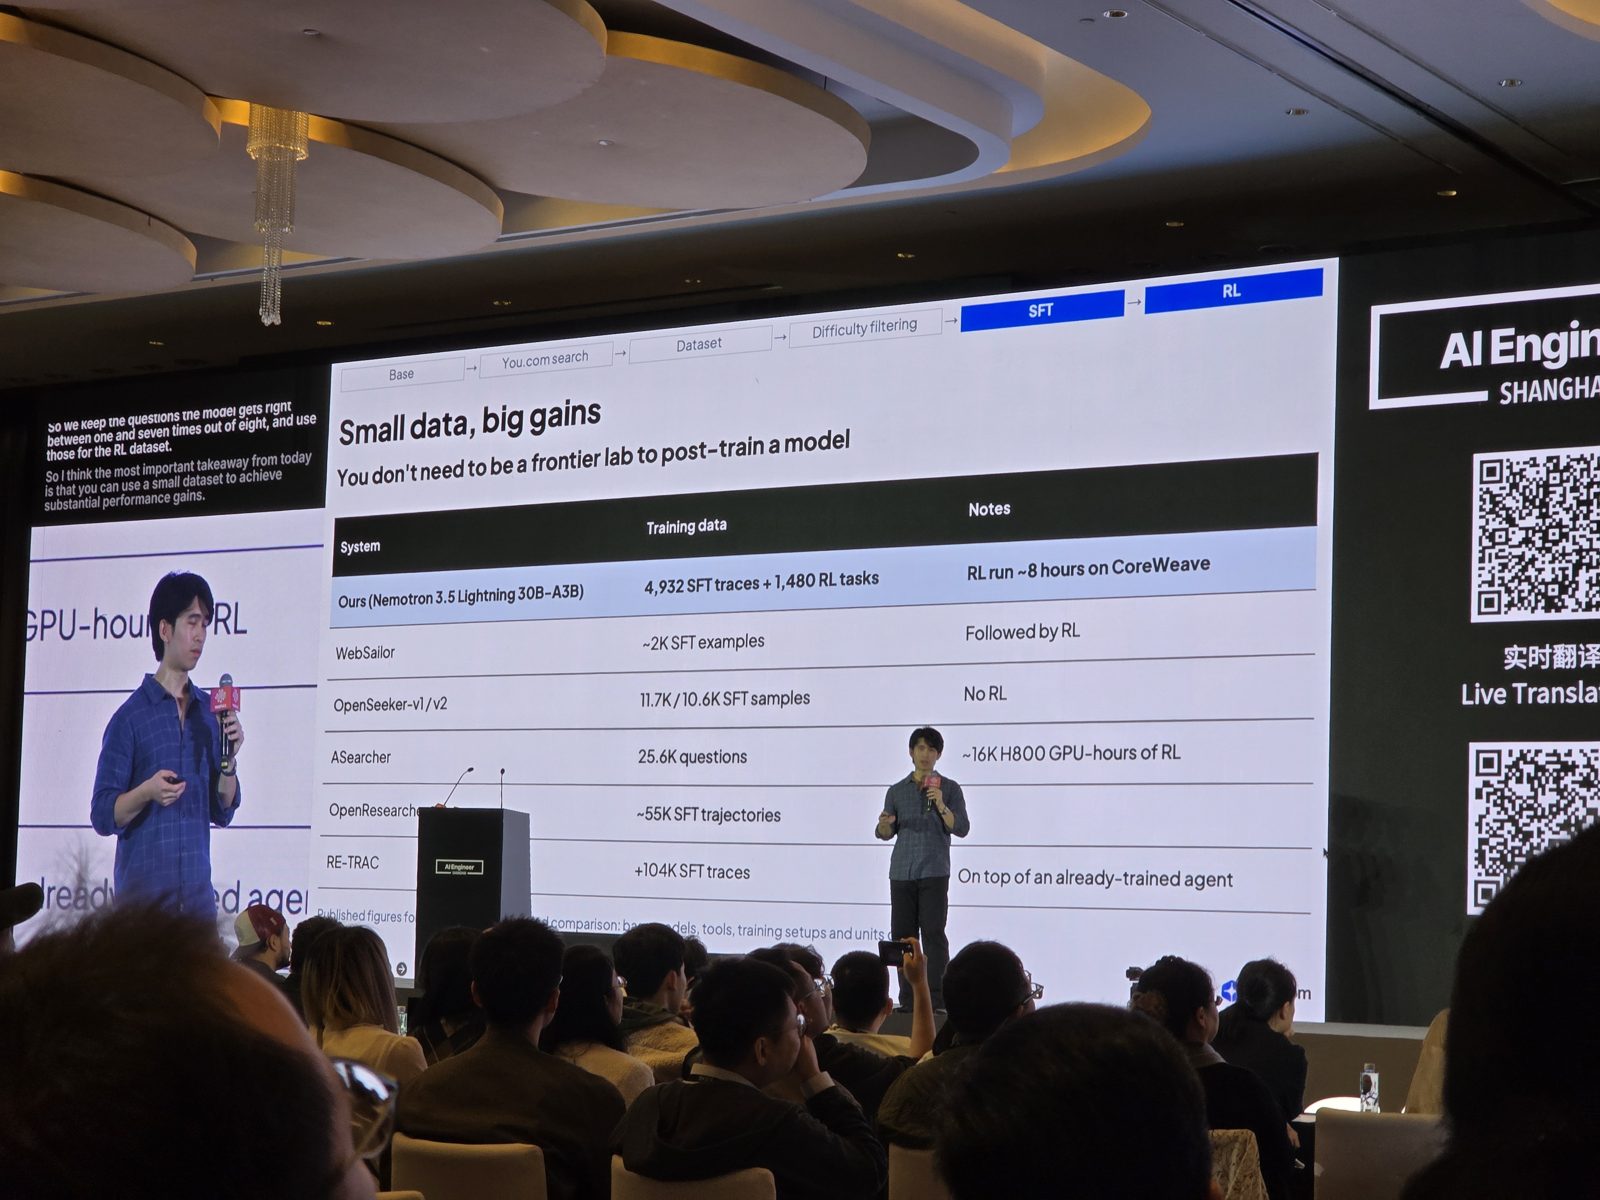
小数据、大进步:4,932 笔 SFT trace 和 1,480 个 RL 任务(在 CoreWeave 上约 8 小时 RL),对照 WebSailor、OpenSeeker、ASearcher、OpenResearcher 和 RE-TRAC。
范例 trace 最能看出差别。BrowseComp 有一题问的是某位 CEO,以及他在卖灯泡时开的车。Base model 调用了 313 次工具,烧掉超过 8.3M 个 token,最后答错。Post-train 过的模型只调用 7 次、用了 74.7k 个 token,答对了。
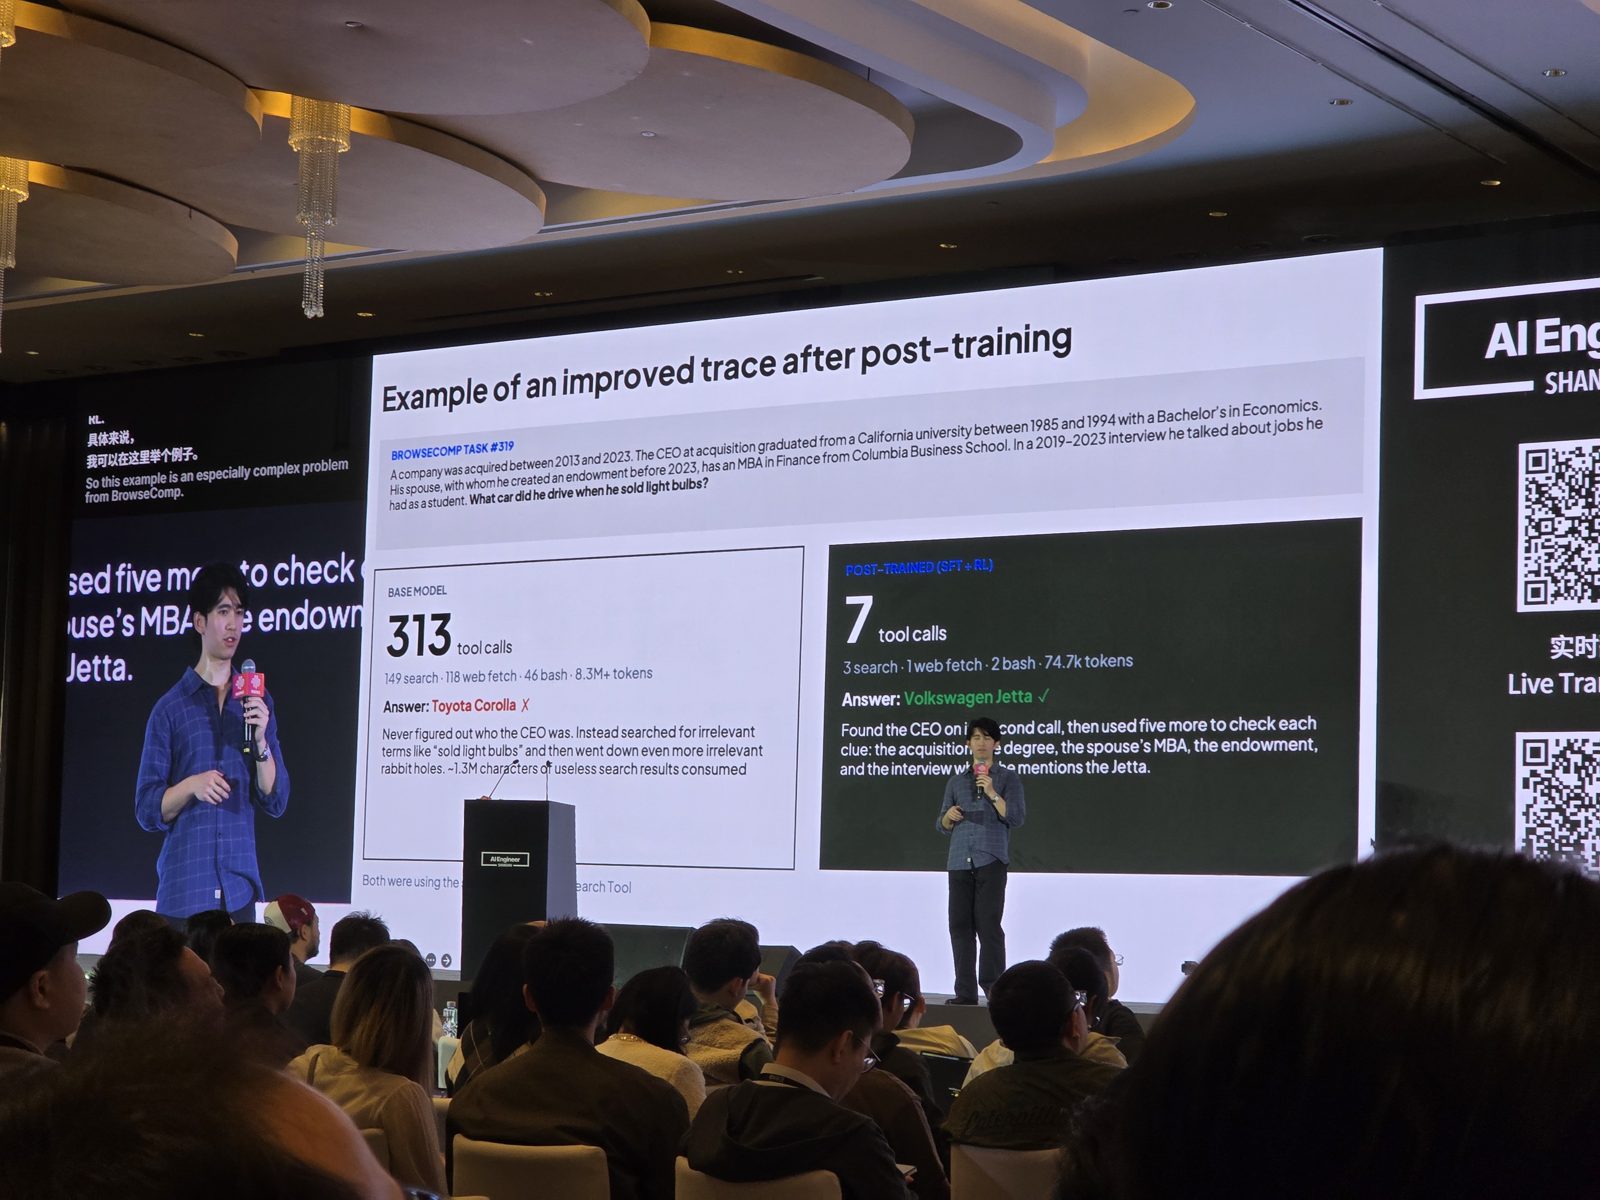
BrowseComp 第 319 题在 post-training 前后的对比:313 次工具调用、8.3M+ 个 token、答错(Toyota Corolla),对上 7 次工具调用、74.7k 个 token、答对(Volkswagen Jetta)。
他们最后给的蓝图是:先有强的搜索,从真实网页建题目,依难度筛选,先做 SFT 再做 GRPO,除了准确率之外,也要量测工具调用次数、token、时间和成本。
全端推论工程:latency、throughput 与成本 — Chen Wang (Baseten)
Chen Wang 在 Baseten 负责 partner engineering。Baseten 是一个推论平台,帮其他公司跑开源模型和客制模型。他整场用一个故事包起来:从 Joseph Campbell 的英雄旅程和 Luke Skywalker 讲起,到最后才揭晓,故事里的英雄其实是一个正在穿过模型的 token。
商业的部分讲企业怎么一步步转向开源模型。一开始是用开源模型的 serverless API 来省钱;规模变大之后,为了达到 throughput 和 latency 的目标,改用专属部署;客户数据就是护城河的团队会 fine-tune 自己的模型,免得把客户数据“双手奉上”给模型供应商。他说今年年初,OpenRouter 上开源模型的 token 用量已经超过封闭模型,而且差距还在拉大。中间还穿插了一小段支线,讲开放生态系是赛博庞克未来之外的另一条路,配图是他自己画的。
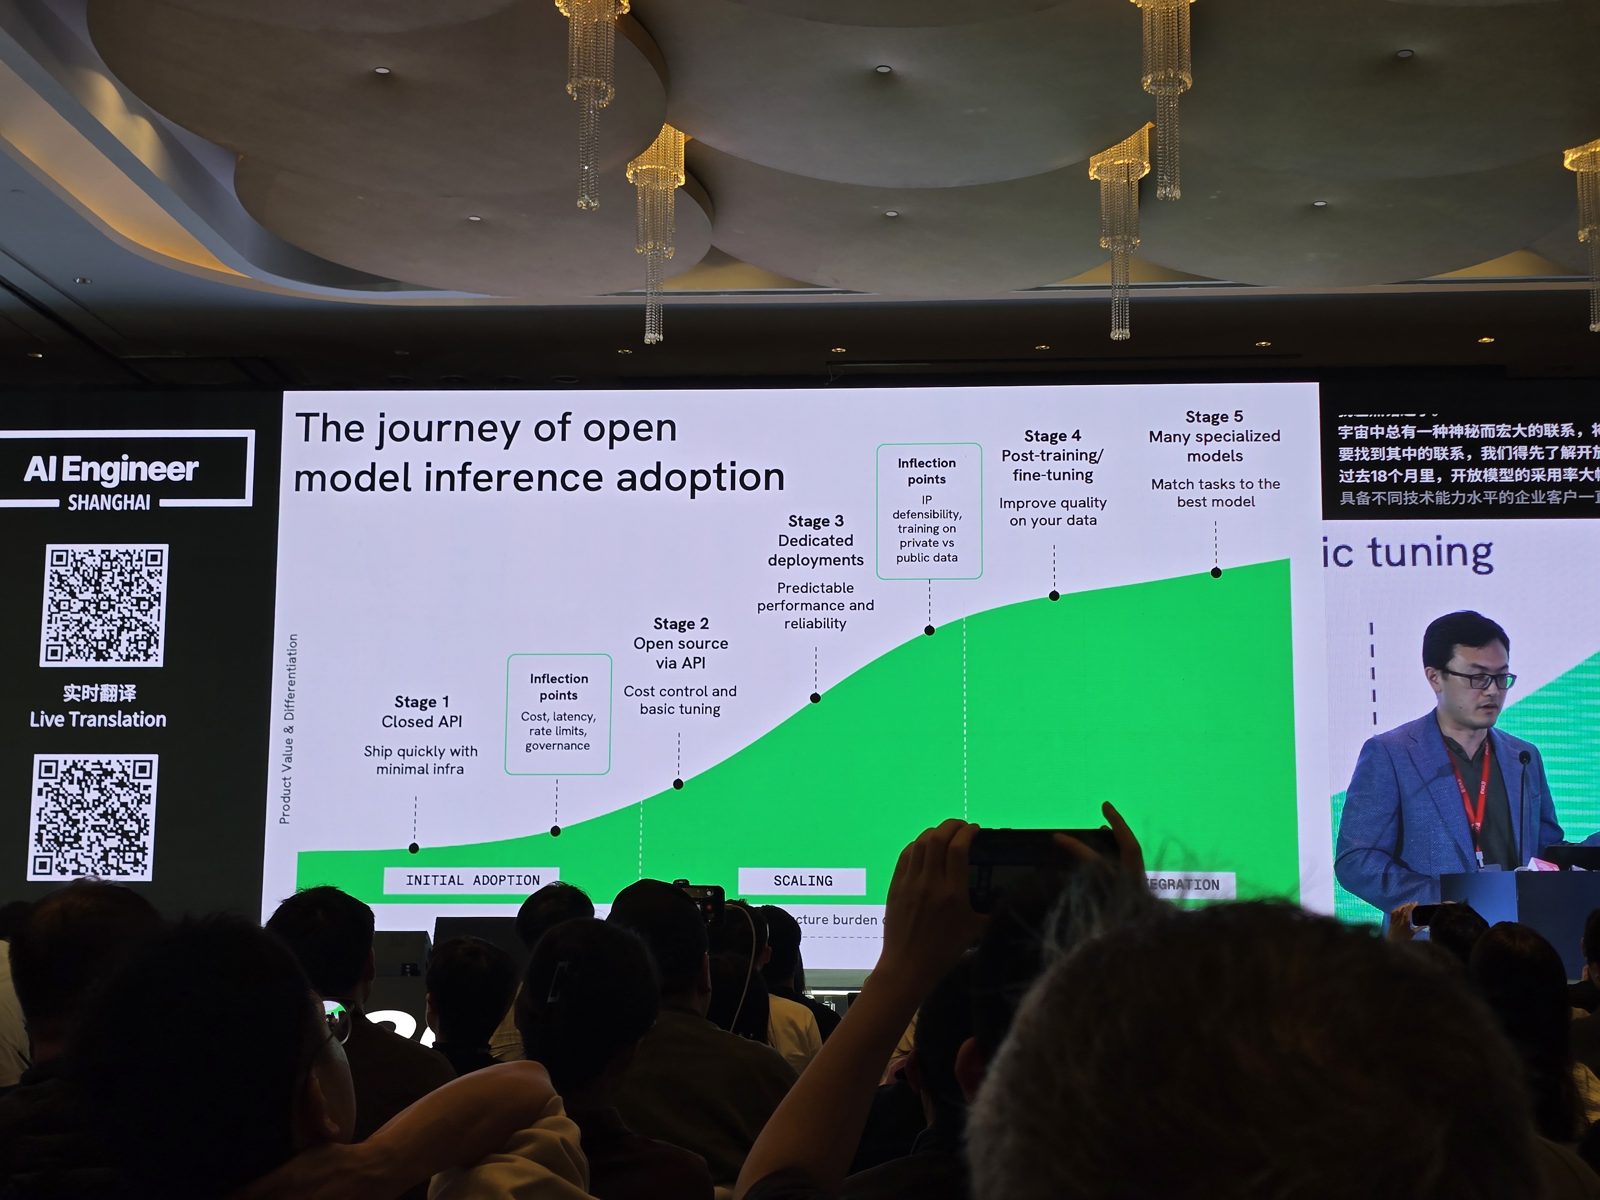
开源模型推论的采用历程:封闭 API、通过 API 使用开源模型、专属部署、post-training 与 fine-tuning,再到许多专用模型;第一个转折点来自成本、latency、rate limit 与治理。
技术的部分从取舍三角和一张 Artificial Analysis 的图开始。图上是 DeepSeek V4.1 Flash 每张加速器的总 throughput 对上每个请求的输出速度,一条线代表一种 GPU,从 H100 一路到 Vera Rubin 和 AMD 的 MI355X。并行数决定你落在在线的哪个点:并行数低,每个用户拿到的输出很快,但 GPU 的总 throughput 低;并行数高则反过来。他的建议是,如果流量大、GPU 少,就在端到端 latency 允许的范围内把 throughput 尽量往上推。
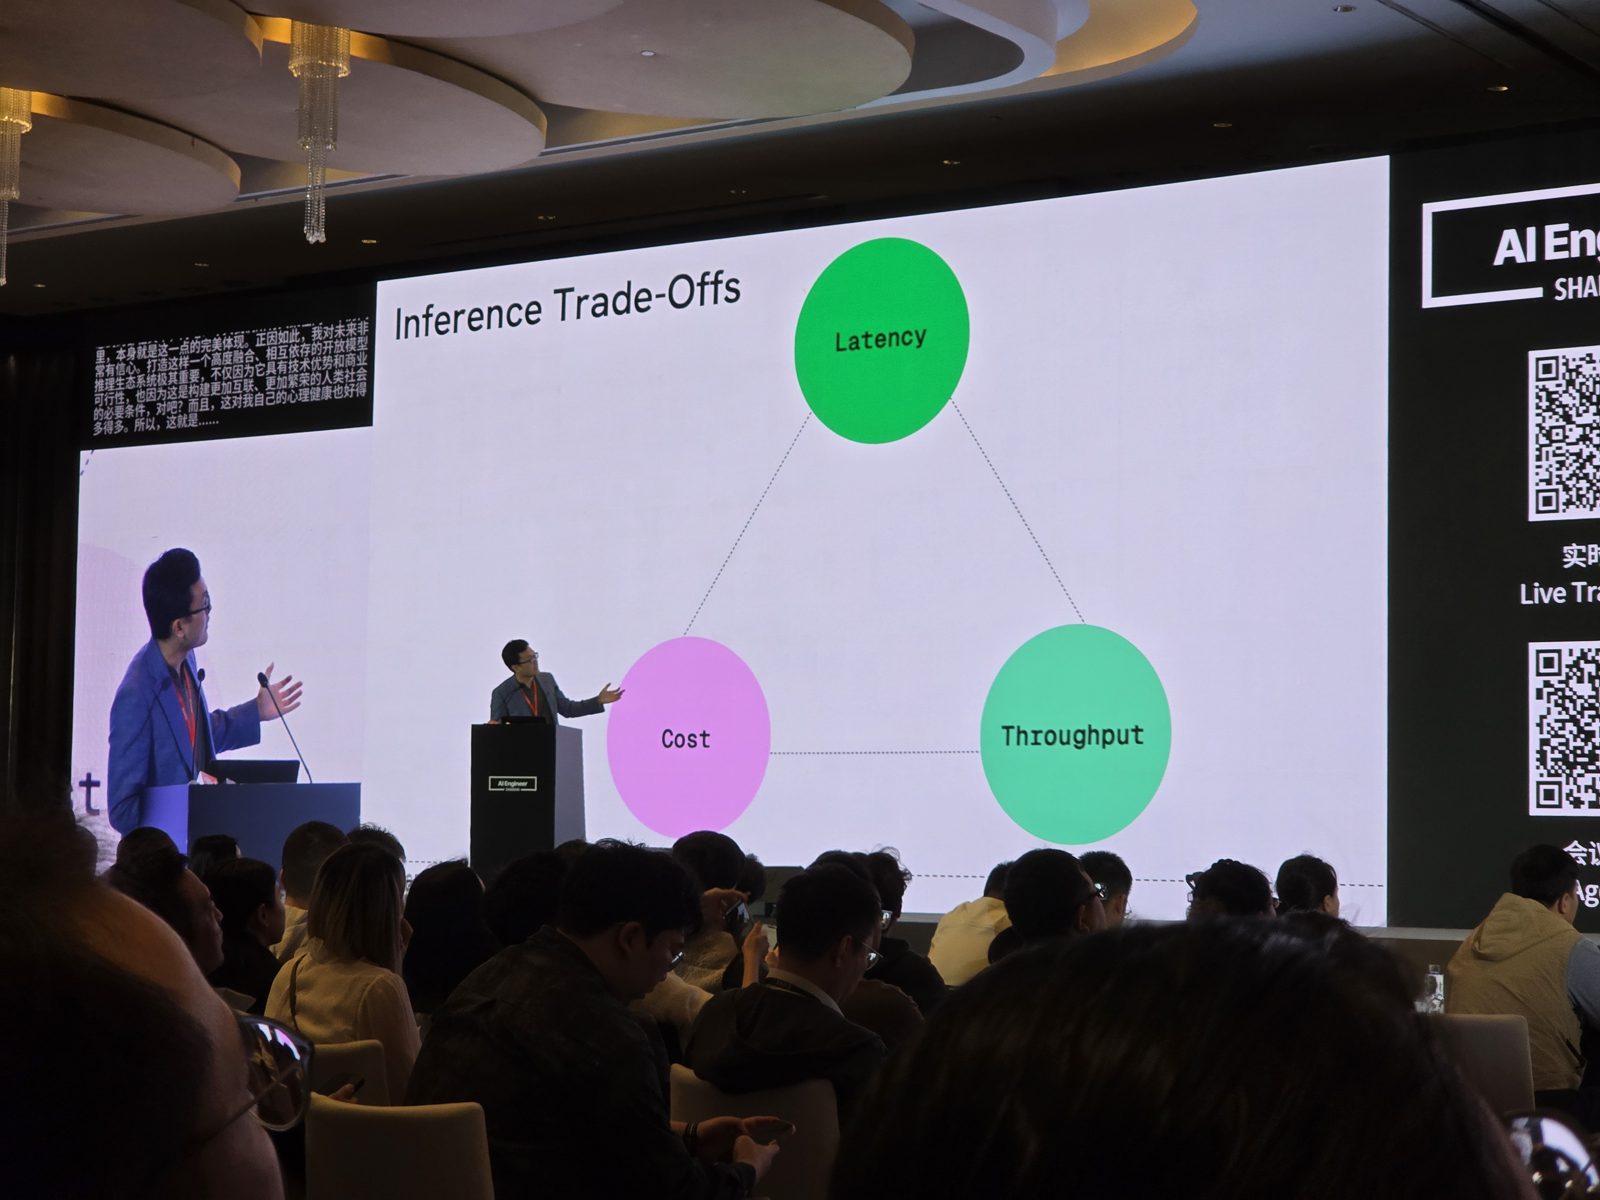
推论的取舍三角(latency、throughput、成本),是这场演讲技术部分的主轴。
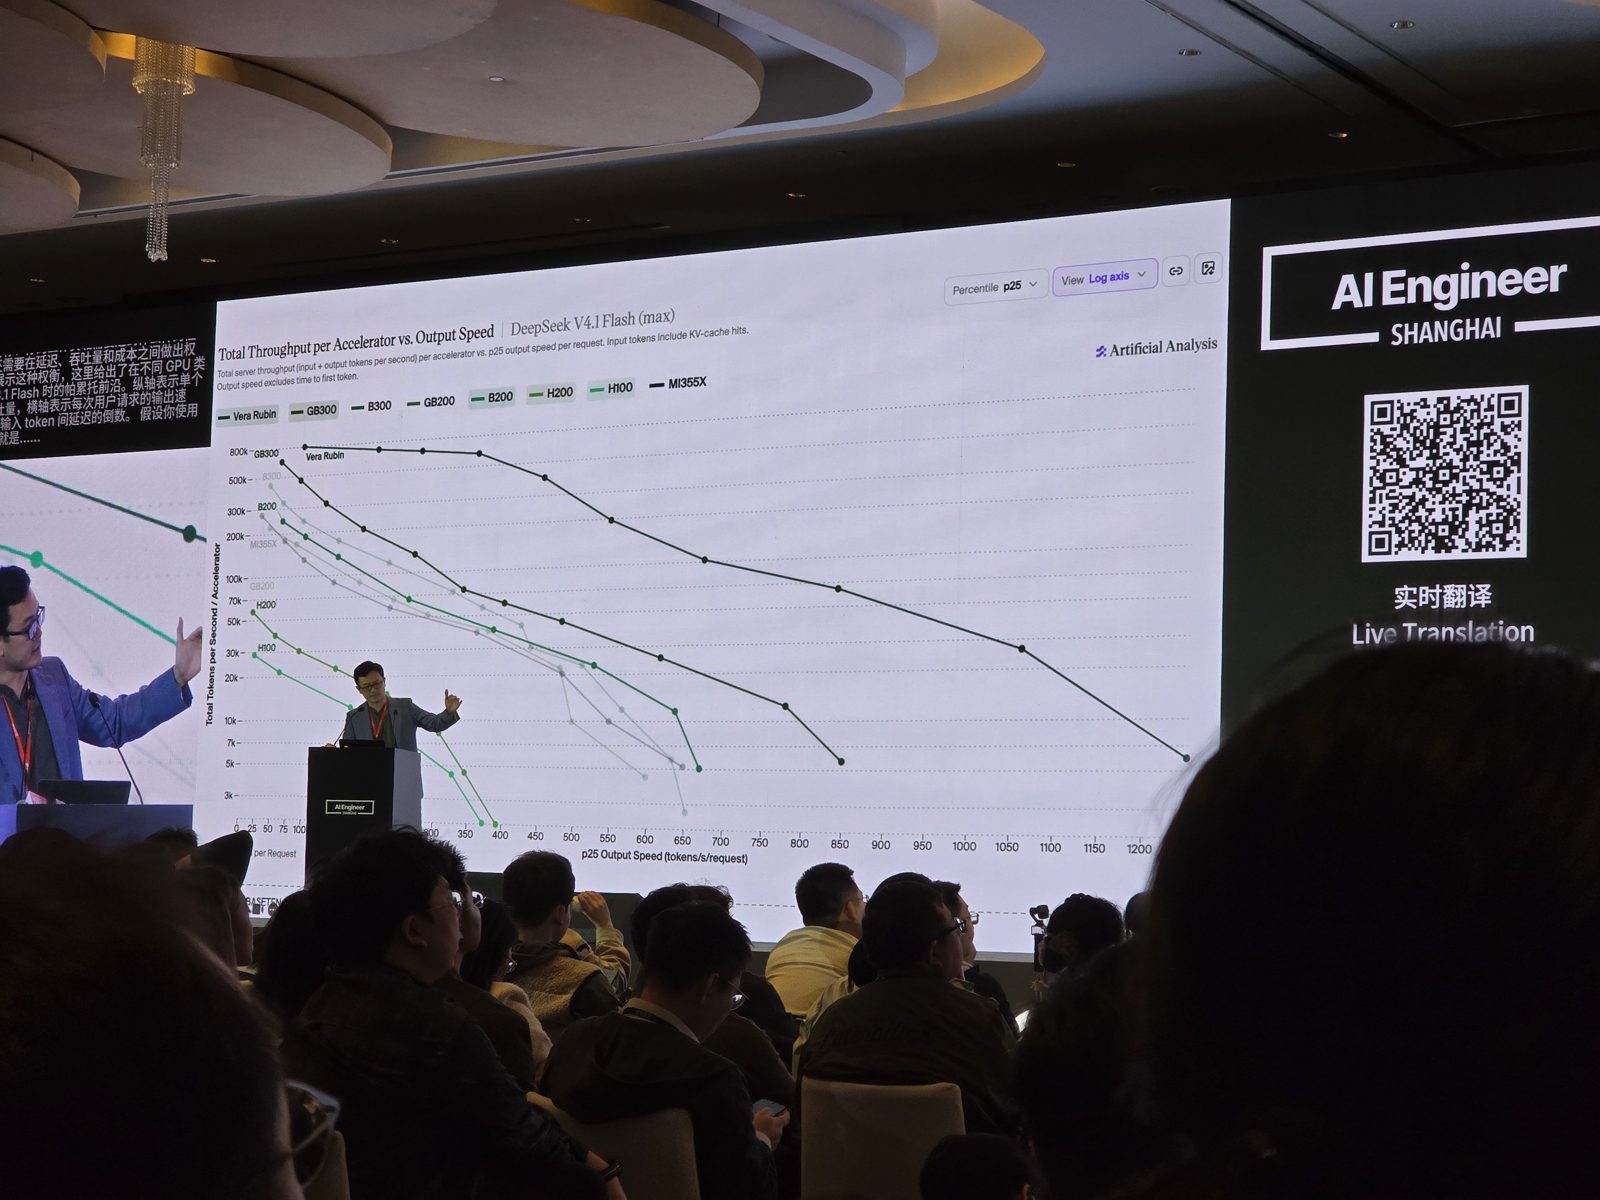
Artificial Analysis 的图:DeepSeek V4.1 Flash 每张加速器总 throughput 对 p25 输出速度,曲线包含 Vera Rubin、GB300、B300、GB200、B200、H200、H100 与 MI355X。
接着是单节点的技巧。Prefill 负责建出 KV cache 和第一个 token,所以决定 time to first token,属于 compute-bound;decode 每一步都要读 KV cache,所以决定 token 之间的 latency,瓶颈在内存带宽。这个差异就是把 prefill 和 decode 拆到不同 replica 上跑的理由。在这之上,他又讲了 chunked prefill、FlashAttention、paged KV cache、量化、expert parallelism 和 speculative decoding。他的总结是:这些技巧做的都是减少重复的运算和数据搬移。
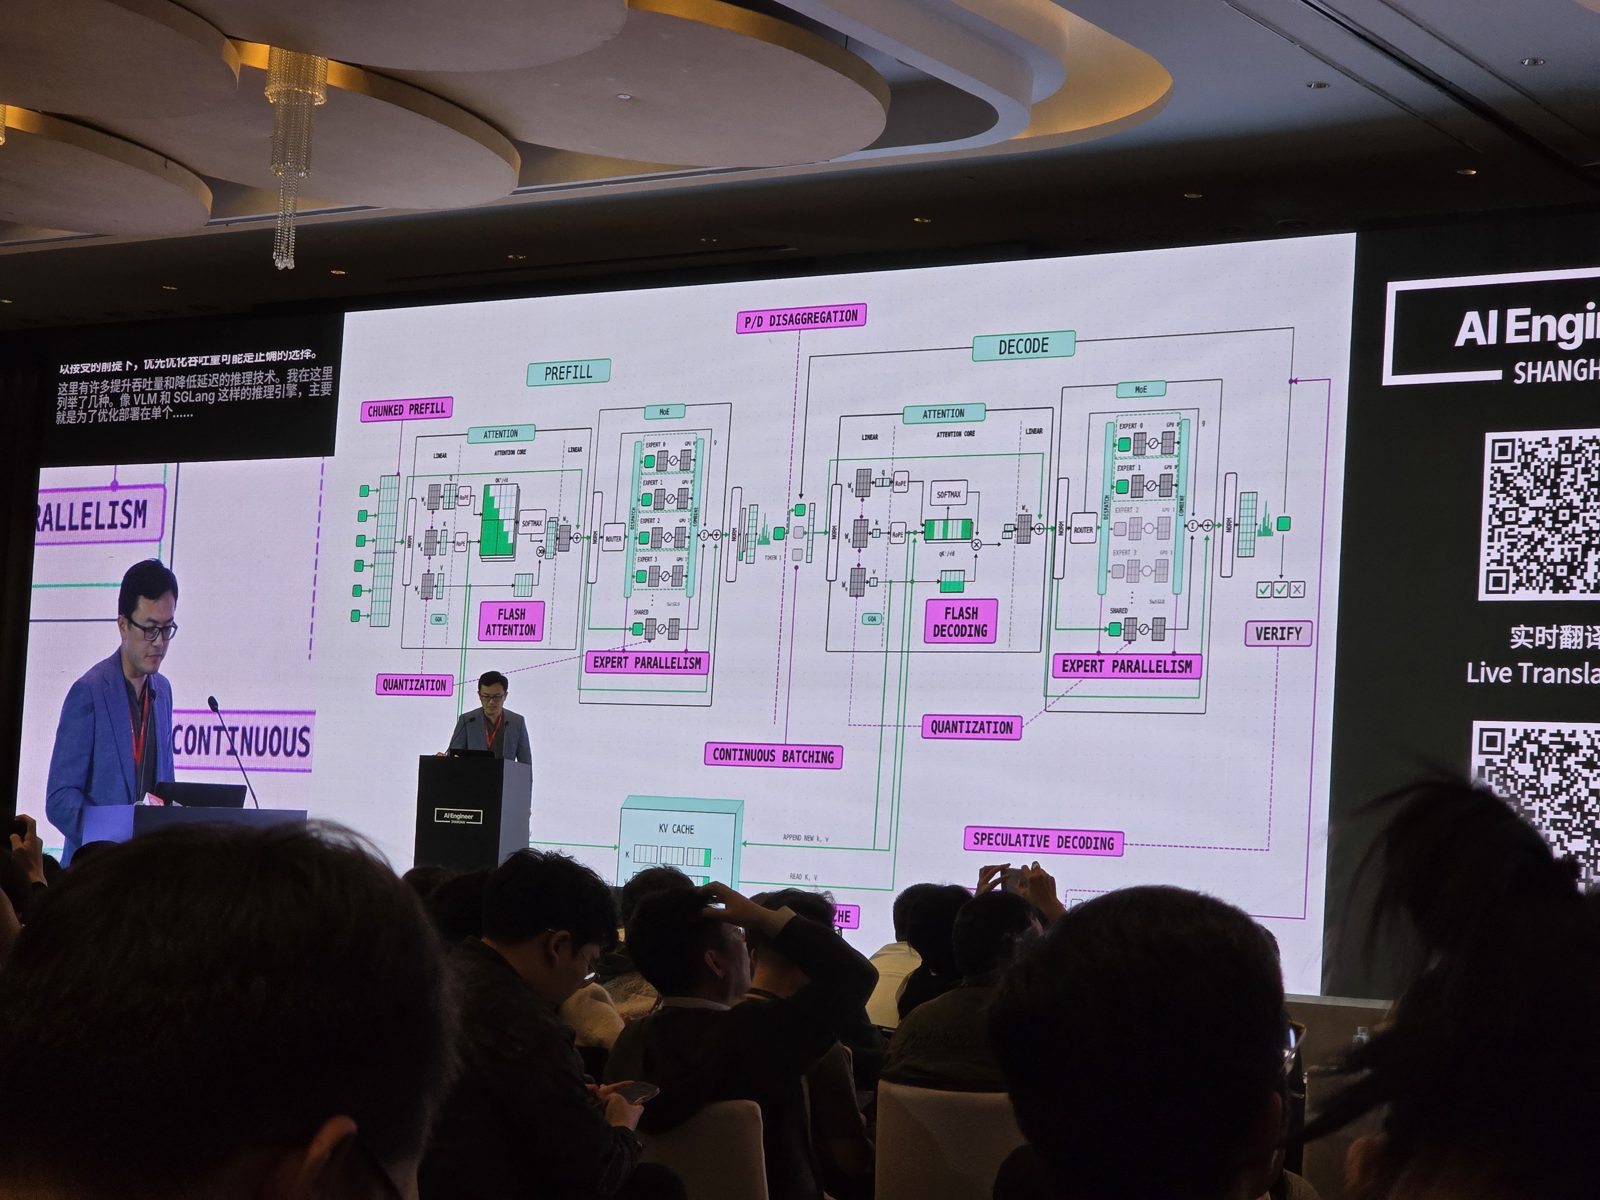
一张图画出请求经过 prefill 与 decode 的流程,并标出各技巧作用的位置:chunked prefill、FlashAttention、expert parallelism、P/D 分离、continuous batching、量化与 speculative decoding。
有一张投视频讲集群层级。全域调度器在不同云之间调度容量(一个集群 128 张 GPU 用了 120 张,另一个 96 张用了 40 张);本地控制器依模型增减 replica;冷启动时从已经在服务的同伴 GPU 直接把权重拷贝过来,kernel 也事先编译好;KV-aware router 把请求送到持有其 prefix 的 replica;KV cache 会从 HBM 卸载到节点的 RAM 和 SSD,再到集群共用的保存。
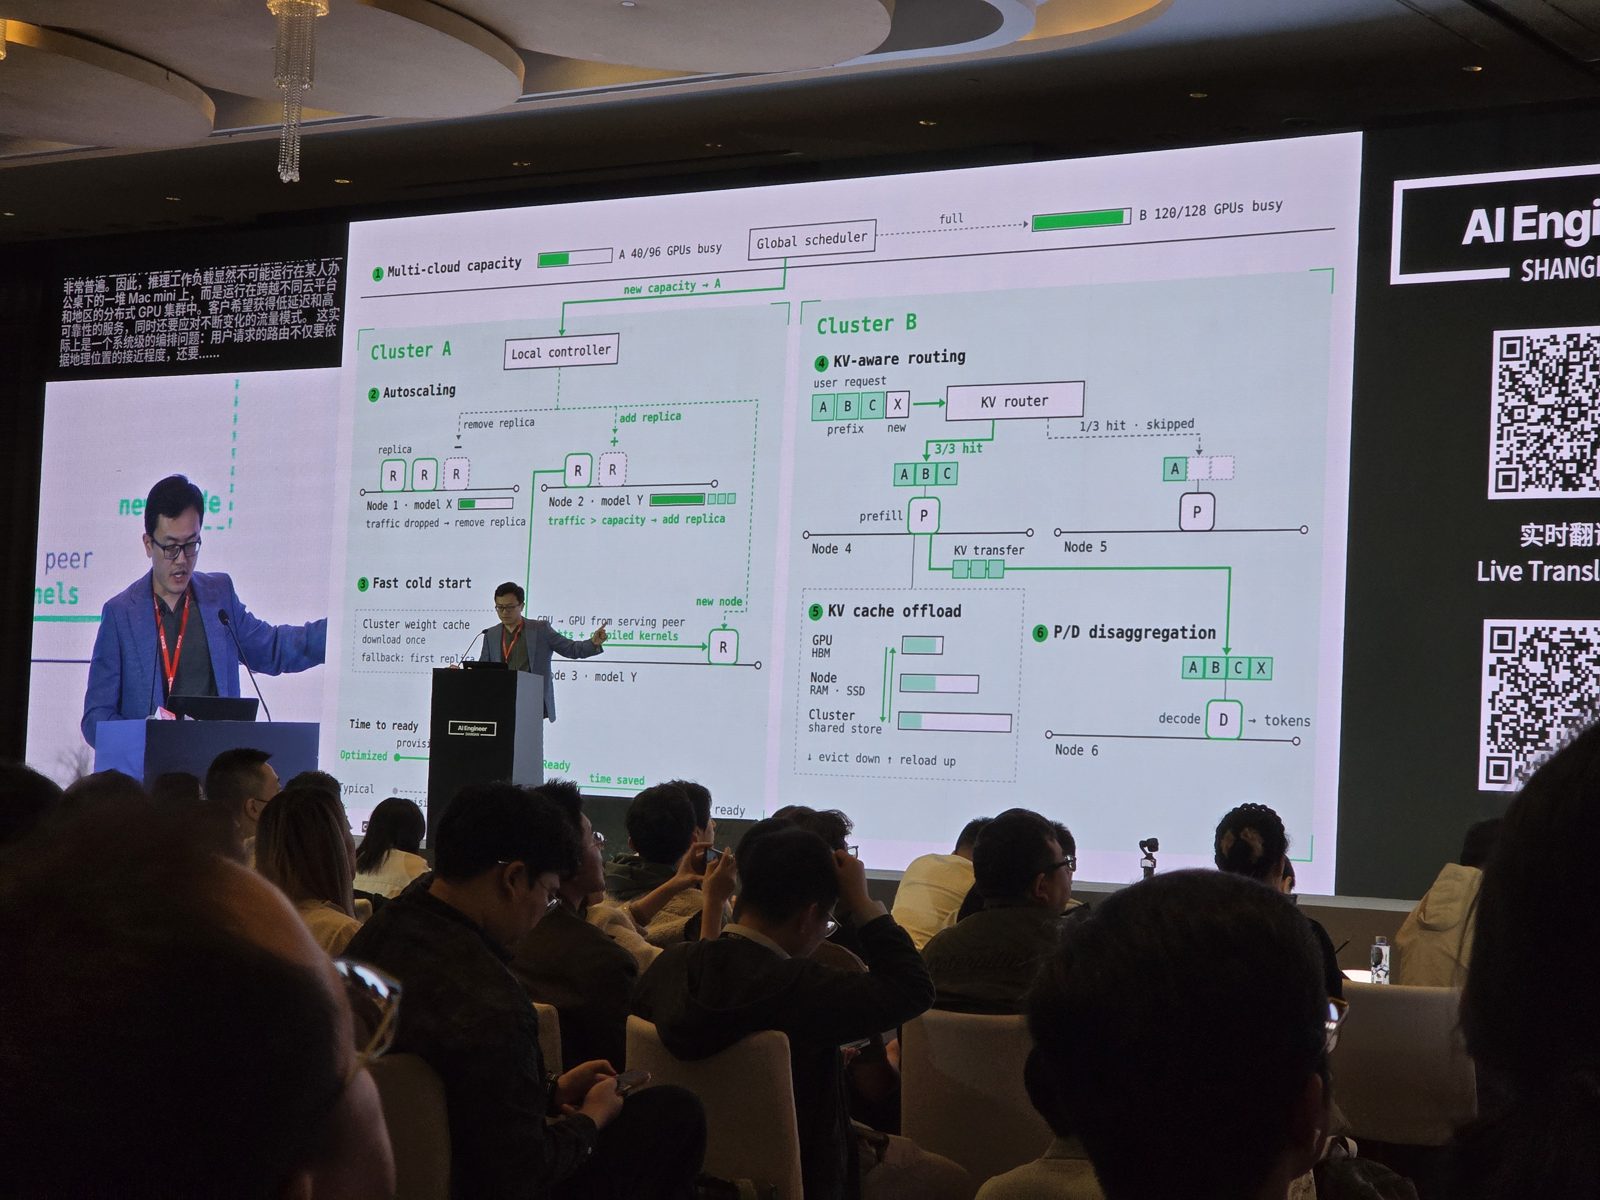
集群层级的服务分成六块:全域调度器下的多云容量、自动扩缩、从服务中的同伴快速冷启动、KV-aware routing、KV cache 卸载(GPU HBM、节点 RAM/SSD、集群保存),以及带 KV 传输的 P/D 分离。
在真实世界的使用中衡量 AI 的前沿 — Chen Peng (Arena)
Chen Peng 在 Arena 做数据这一块,Arena 是从 UC Berkeley 的 Chatbot Arena 发展出来的公司。前几分钟是常见的数字(每月超过 1600 万访客),以及大家熟悉的两两对战。
主要内容是他们怎么评 agent。当一个 session 是一小时的 tool call,两两投票就不管用了,所以 Arena 自己做了一个 agent 产品(“agent mode”,跟 Manus 是同一类),有文件编辑、bash、网络搜索,以及 Drive、Notion 之类的 connector。用户拿它做最多的是写程序。投视频上的例子是一个金融研究的 RAG pipeline,跑了 84 轮、676 次 tool call。
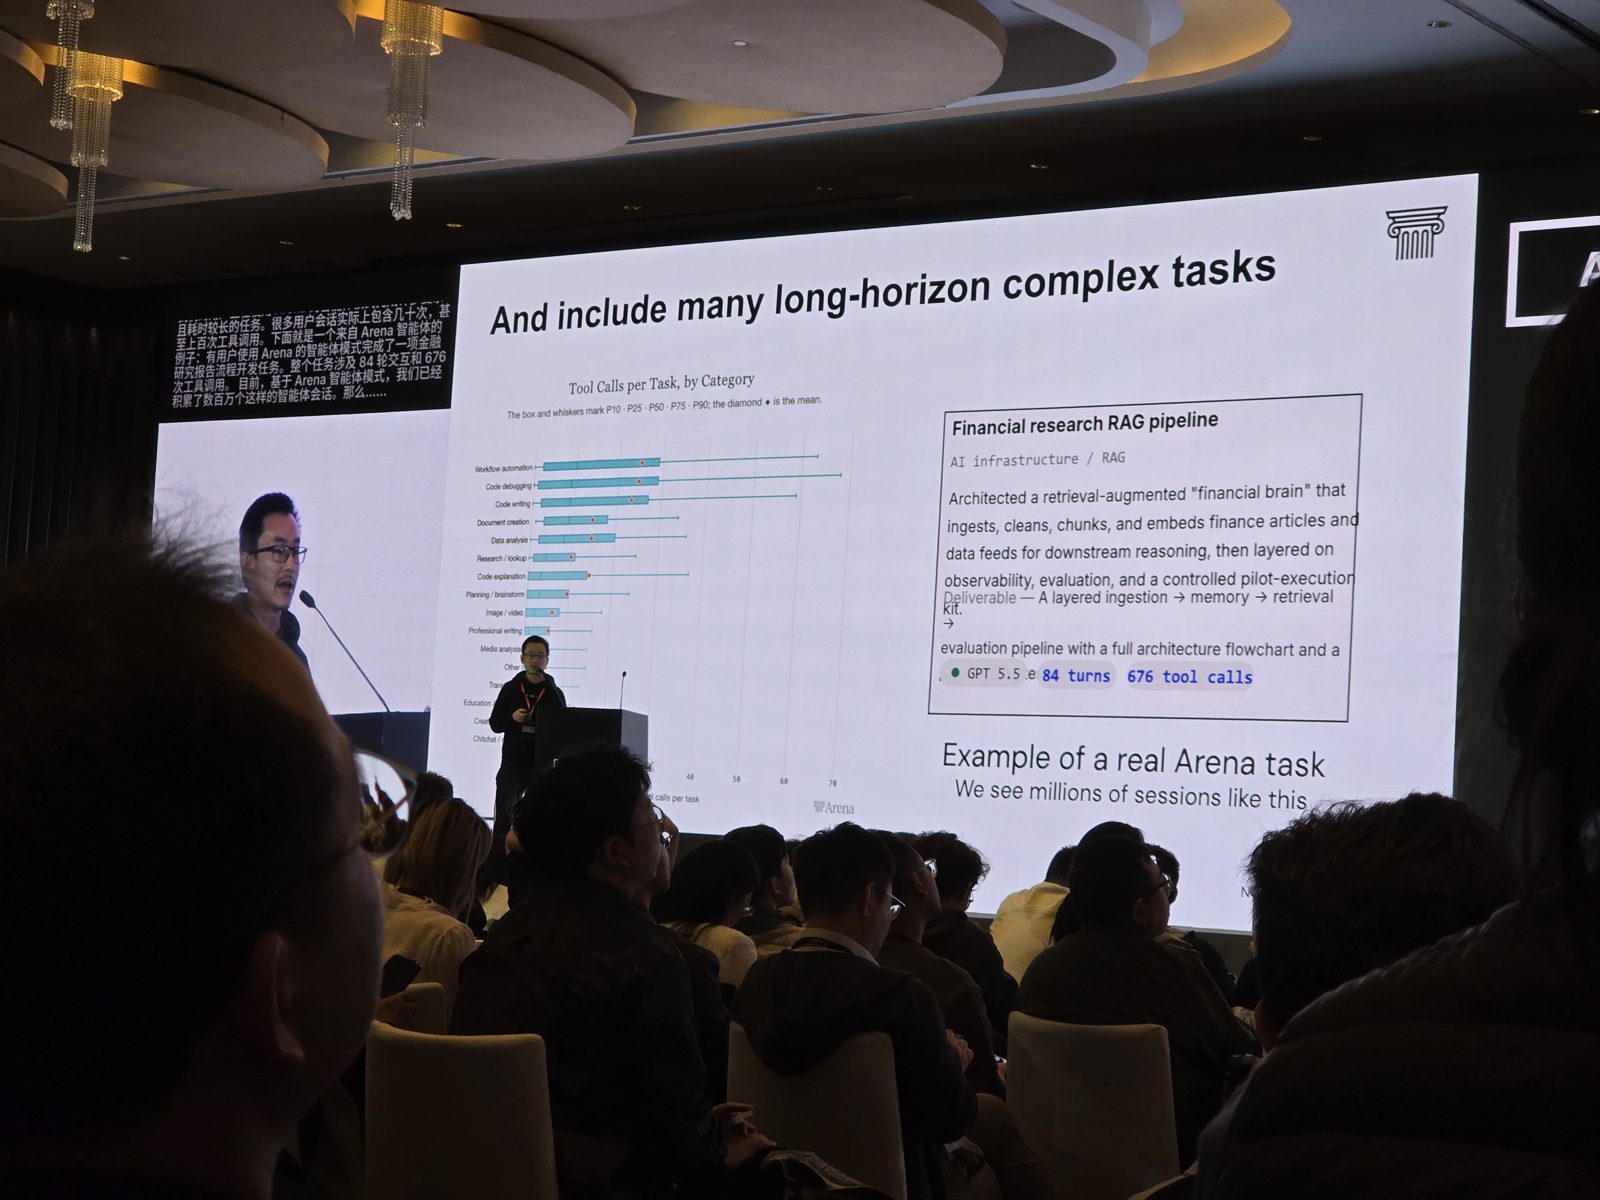
一个真实的 Agent Arena session:用 GPT-5.5 建的金融研究 RAG pipeline,84 轮、676 次 tool call,旁边是各类别每个任务 tool call 数量的图。
评估方式是在真实流量上做随机对照试验。每个 session 随机抽一种 agent 配置。目前只随机化一个组件,也就是 orchestrator 模型,从 Arena 上的数百个模型里挑;tool、system prompt 和 harness 版本是下一步。每条 trace 会被评成 0 到 1 之间的结果分数,一个模型的效果就是它的平均分数减掉一组参考配置组合的平均分数。每个模型面对的都是同样分布的真实任务,所以没有固定的题库可以拿来针对训练。
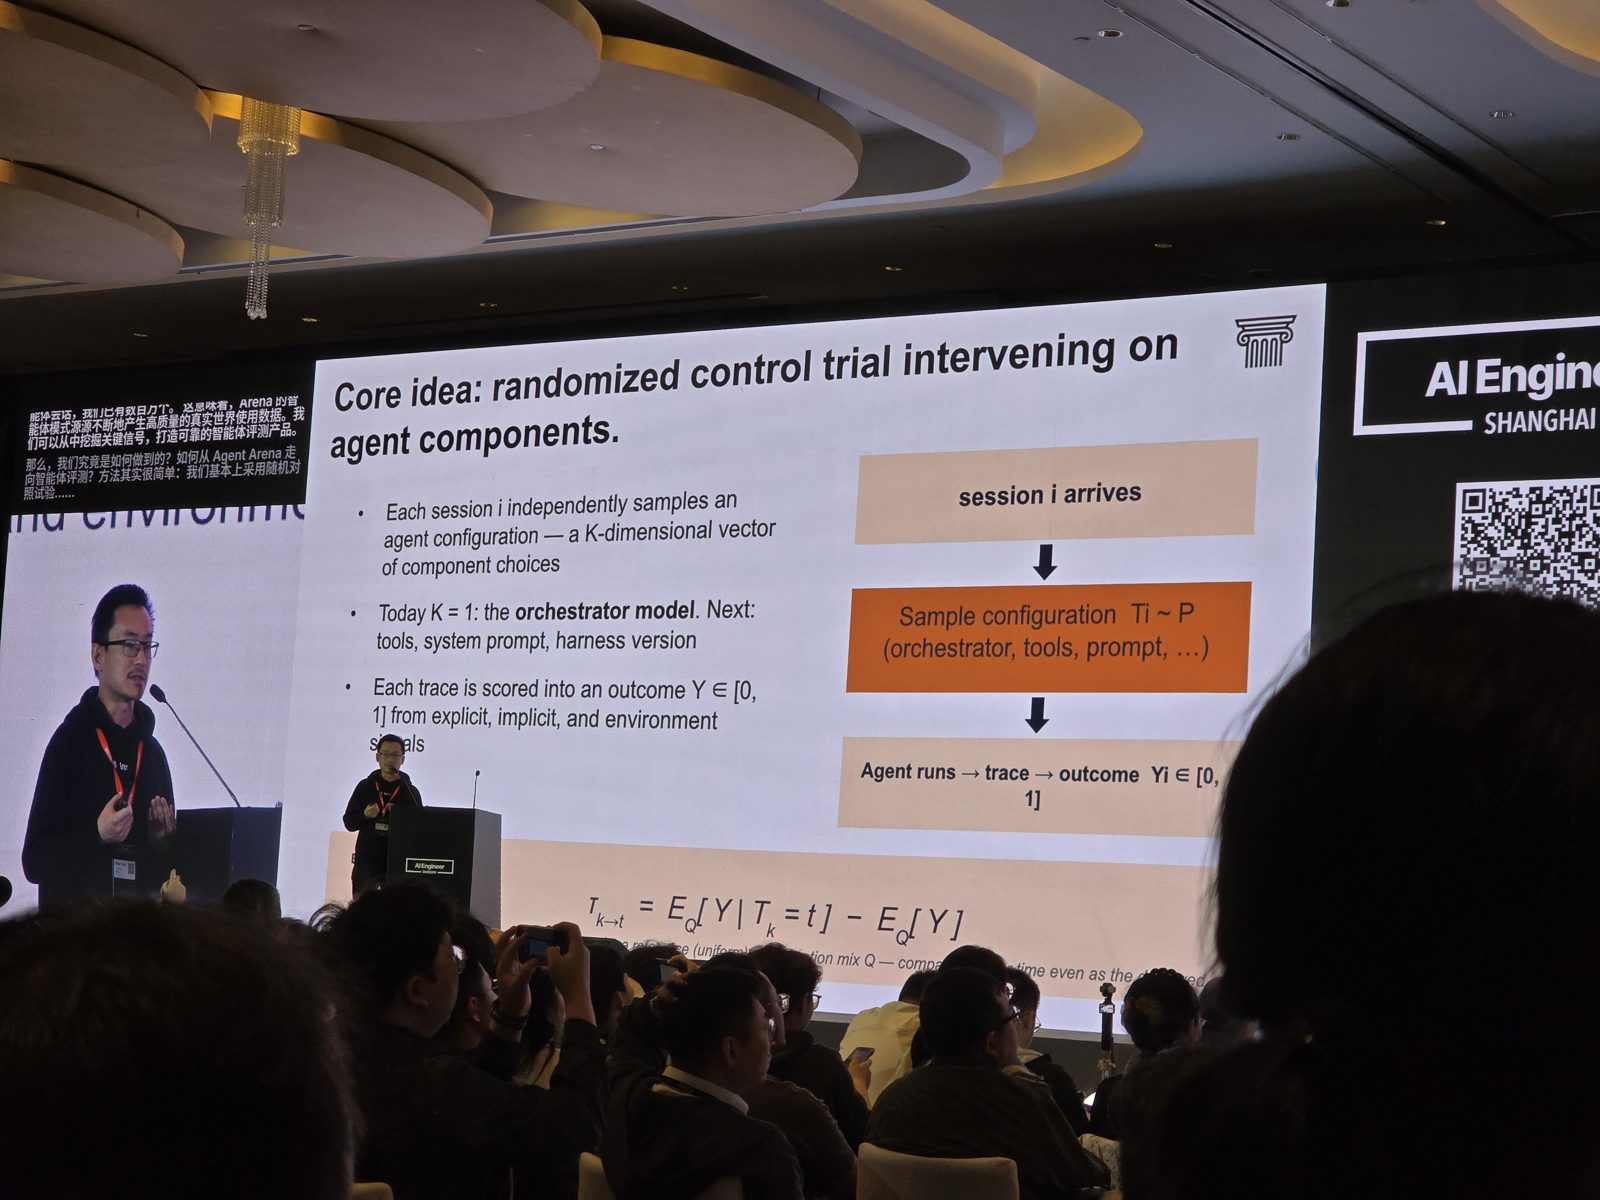
内核概念:每个 session 抽一种配置(目前只有 orchestrator 模型),trace 评分成 [0, 1] 之间的 Y,一个组件的效果是相对于参考组合的 E[Y | T_k = t] − E[Y]。
分数来自五个信号,由 LLM 加上人工整理从 trace 里抽出来。Confirmed success 是用户在“完成了吗?”的弹出窗口按 Yes。Praise vs complaint 是比较用户主动说的“不错,现在快多了”和“bug 还在”。Steerability 是用户需要纠正 agent 的频率。Bash reliability 抓的是像坏掉的 sed 指令这类问题,tool hallucination 则是计算调用不存在的 tool 的次数,例如凭空捏造的 deploy_to_prod()。
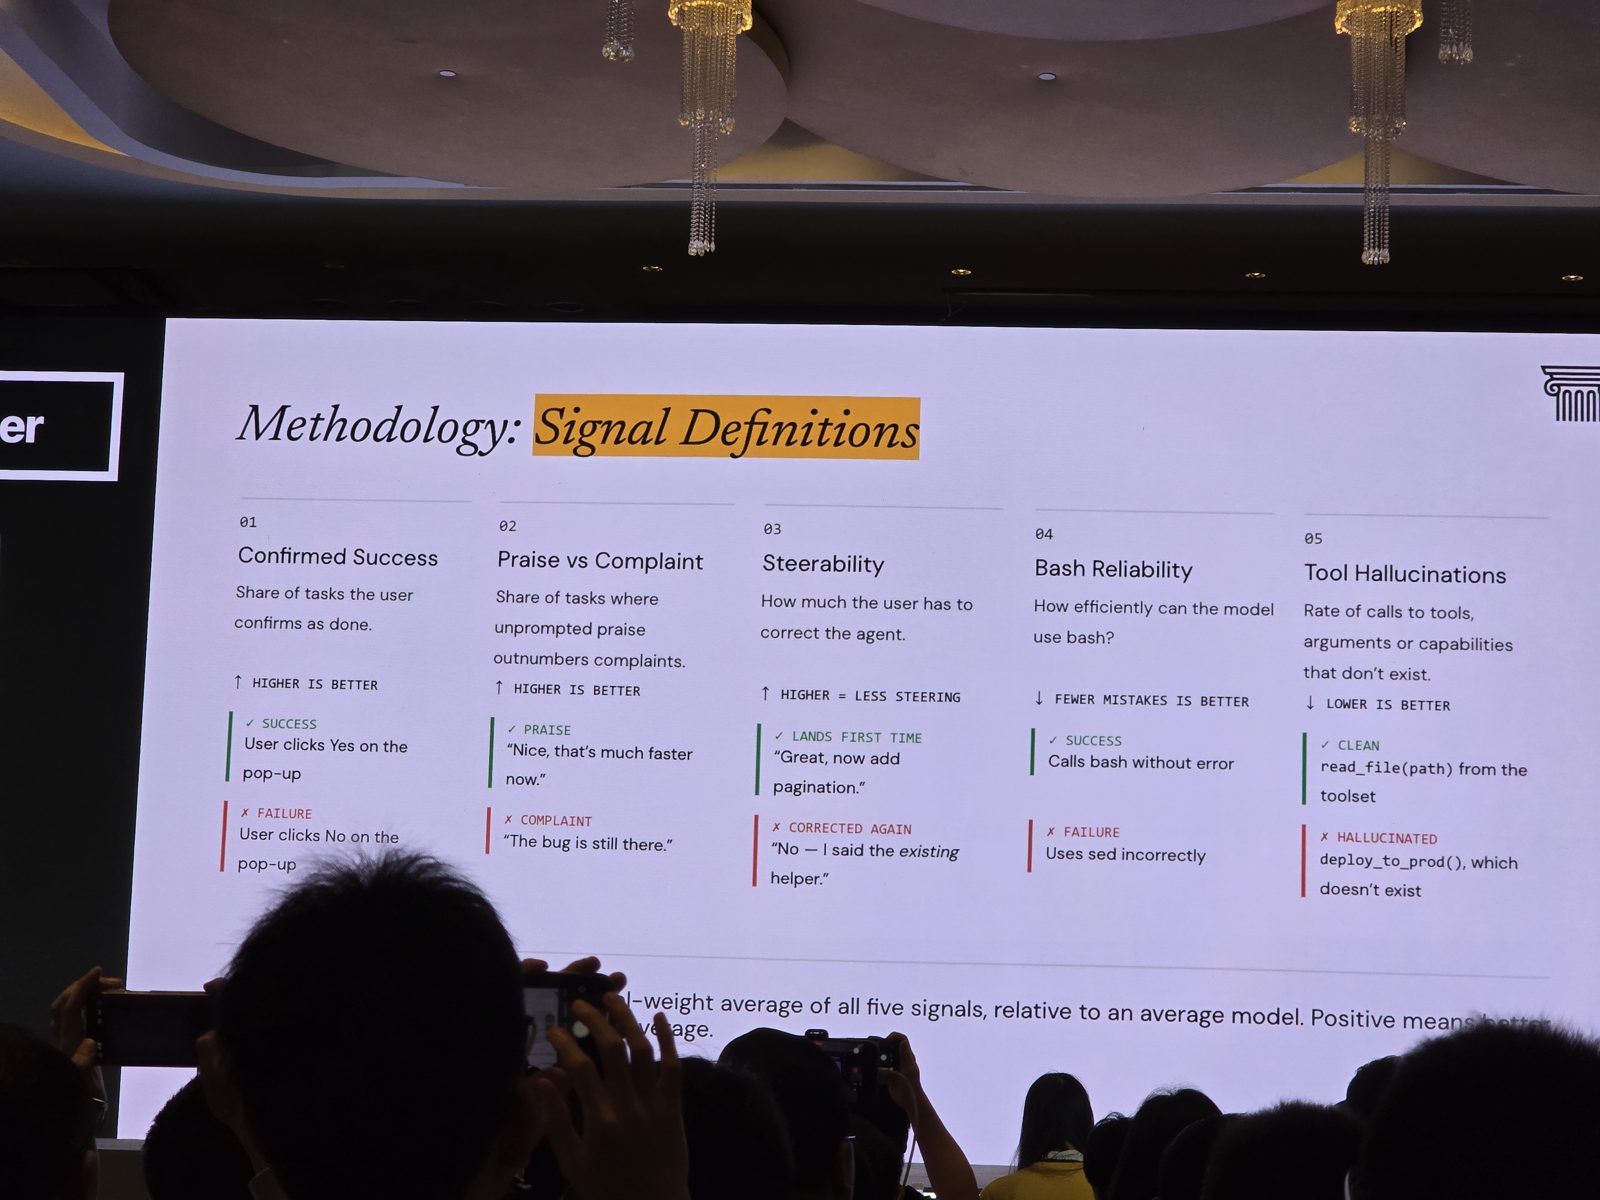
agent 排行榜背后的五个信号:confirmed success、praise vs complaint、steerability、bash reliability 与 tool hallucination,每个都附一个通过和失败的例子。
在最后的排行榜上(超过 500 万个 agentic session),Claude Opus 5.5 以 +20.94% 的净改善排第一,Gemini 4 Carbon 以 +16.04% 排第二。每一列都有 ± 区间和名次范围。第一名的范围是 1→1,但第 3 到第 8 名的范围都是 2→8、3→9 这种。
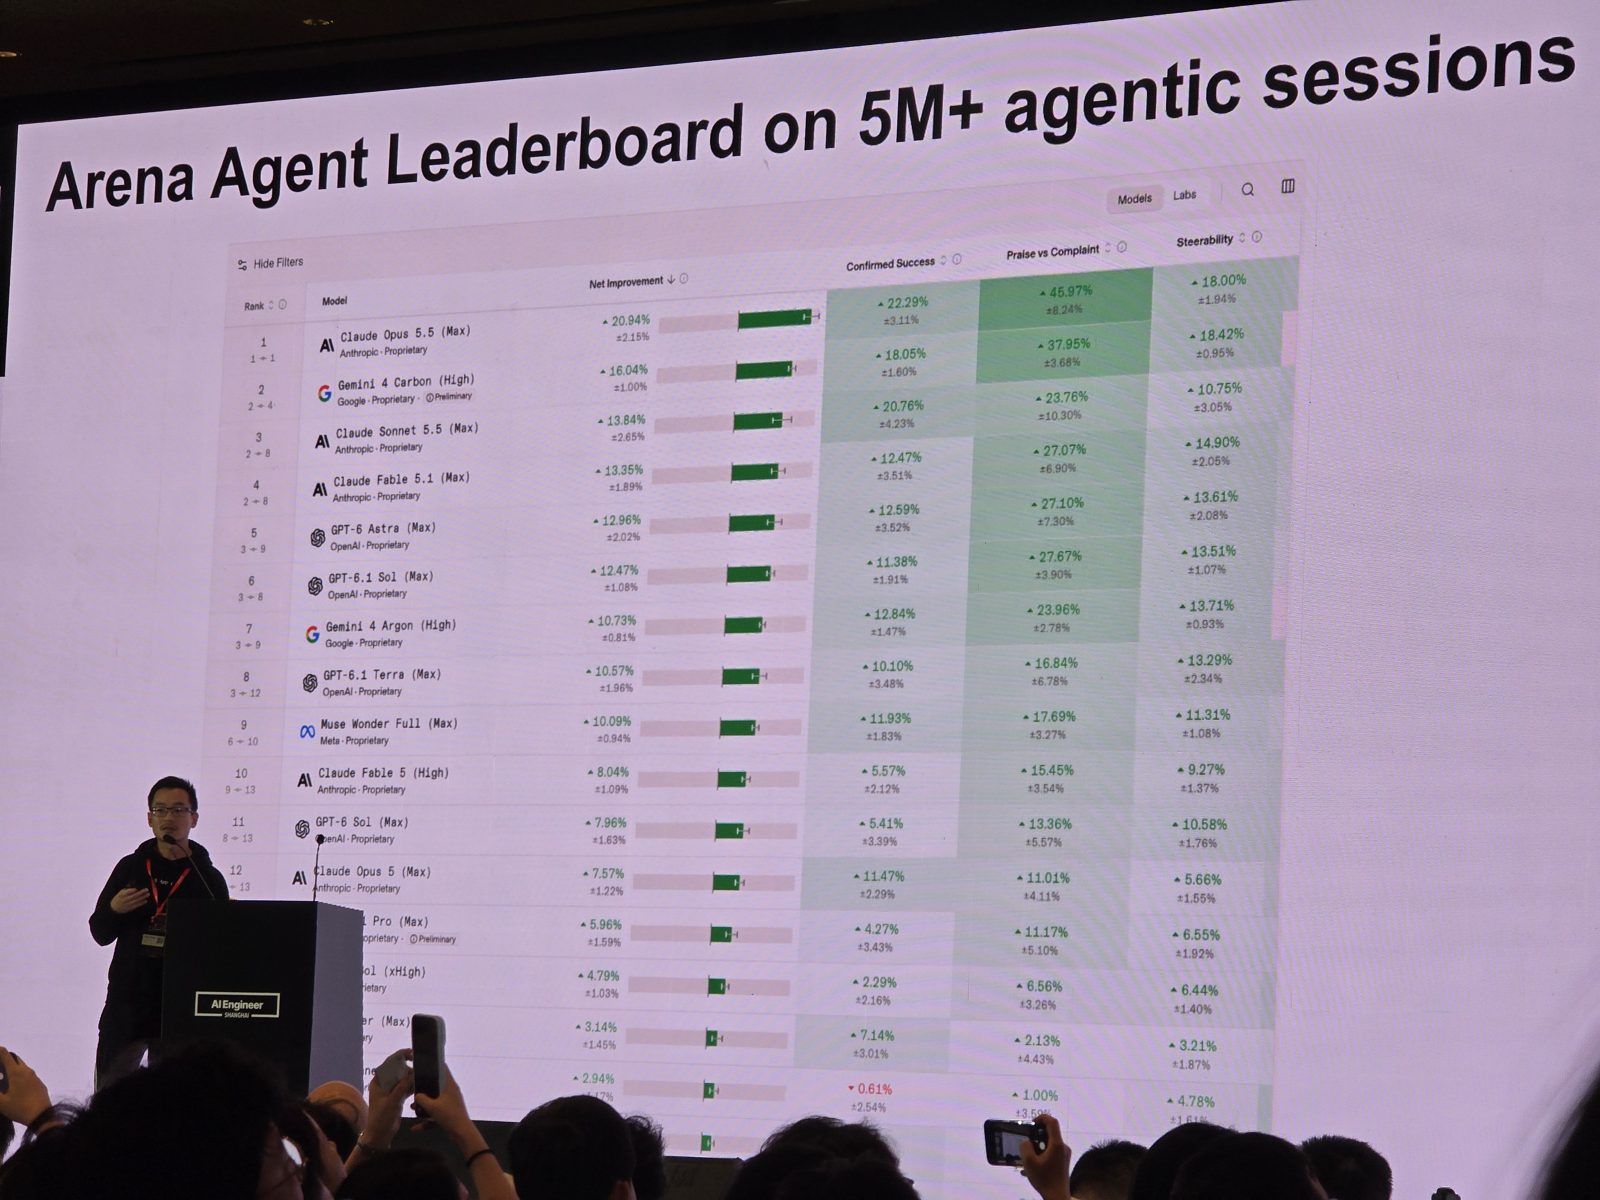
Arena Agent Leaderboard:各模型的净改善、信赖区间与名次范围,加上各信号的字段。
接着他把成本和表现放在一起看。在净改善对每个任务成本中位数的 Pareto 前缘上,中国的开放权重模型(腾讯的 Hy4、小米的 MiMo-V2.6-Pro、DeepSeek-V4.1-Flash)虽然原始分数落后美国模型,还是落在曲在线。他自己的总结是:美国模型领先,中国开放权重模型是第二梯队,差距是真的存在,所以要依任务的价值从前缘上挑模型。
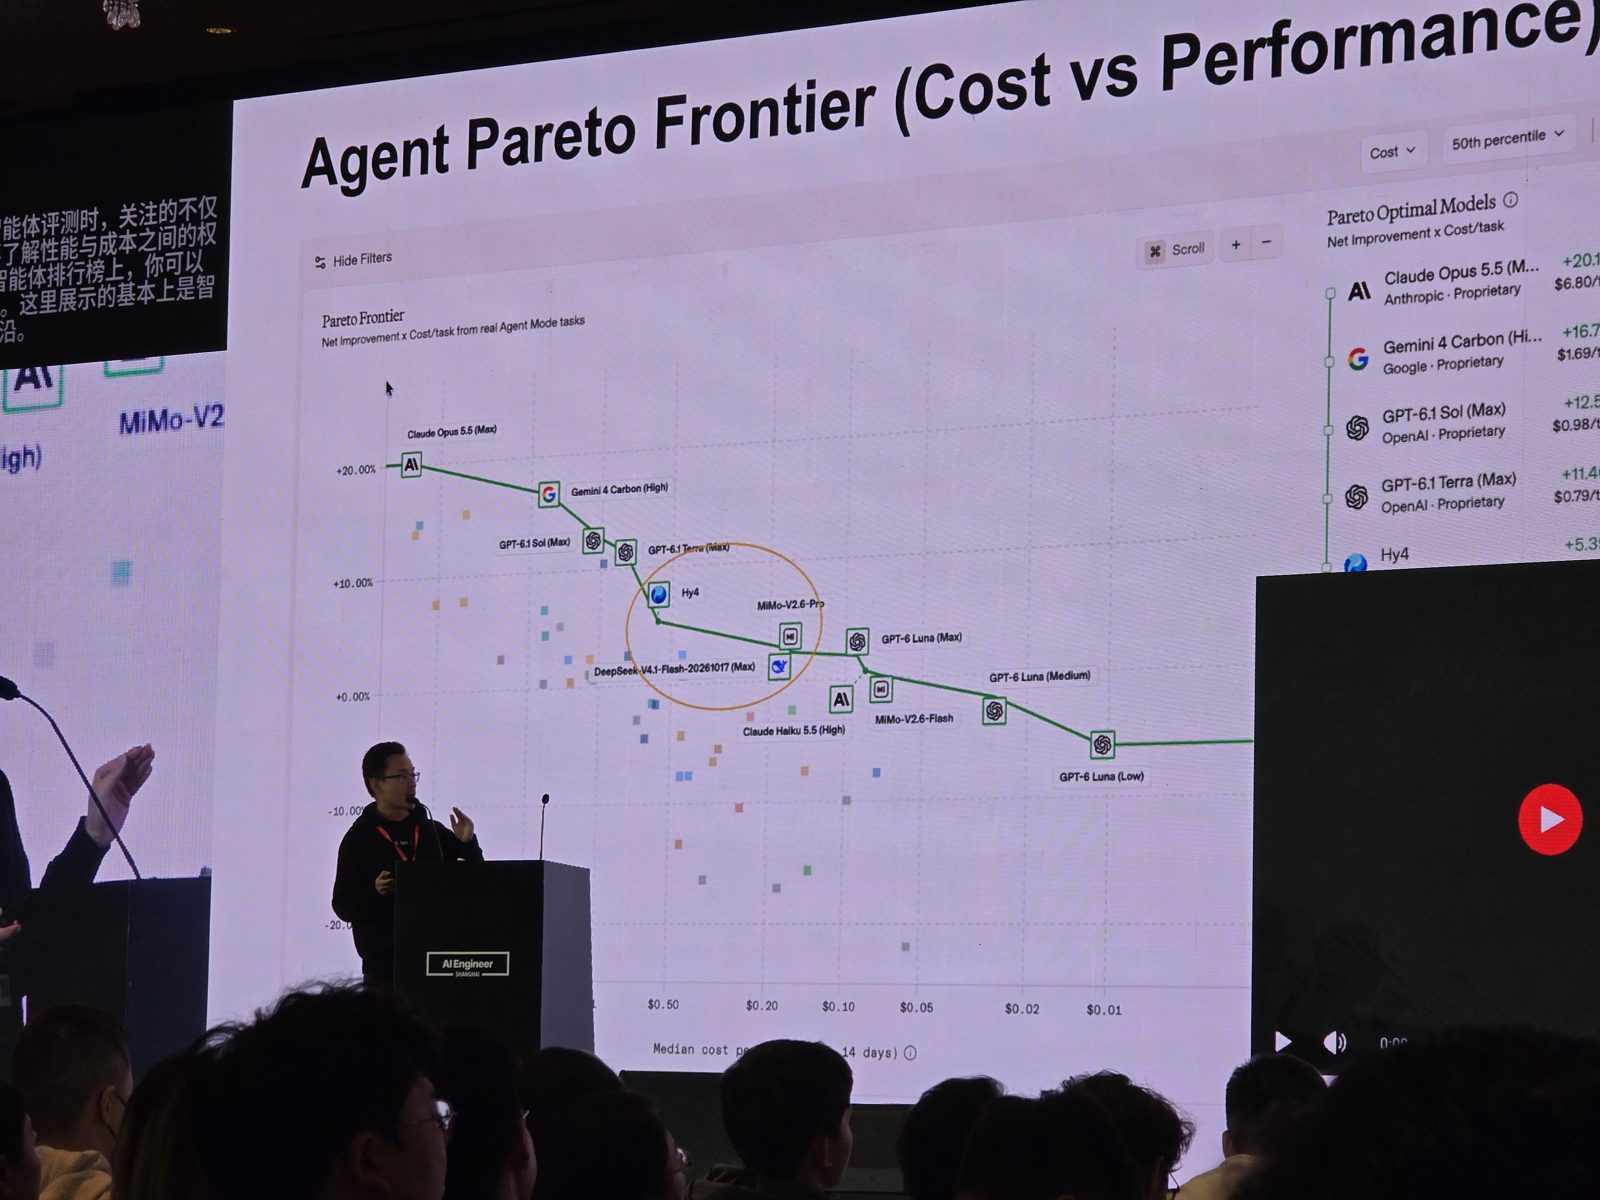
Agent Pareto 前缘:净改善对每个任务成本中位数,Hy4、MiMo-V2.6-Pro 与 DeepSeek-V4.1-Flash 被圈在前缘上。
剩下的是 roadmap:一个月前推出的 Alignment Index(未经授权的动作、把用户没有的意图安到用户头上、任务没做完却说做完了);随机化 harness,并让各实验室带自己的 harness 来;用 agent mode 的 session 训练一个用户仿真器,让一次 eval 从几周缩短到几小时;以及用 trace 建 RL 环境。最后变成是对现场模型实验室的推销。
午休与展区
午餐自理,时间是 11:40 到 13:00,午休的后半段我都在摊位逛。大多数摊位在展示 agent 产品。其中一个是 Raytone 的 AI Box,一台用来在本地跑模型和 coding agent 的小型桌上机。规格表上写:最高 2070 TFLOPS 的 FP4 算力、CPU 和 GPU 共用 128 GB 内存、预装 Omarchy OS 和 Raytone 的模型管理工具,还有一个兼容 OpenAI/Anthropic 的 endpoint,可以让包括 OpenCode、Claude Code 和 Codex 在内的九种 coding agent 接上去。尺寸 160 × 146.4 × 60 mm,重 1.1 kg。
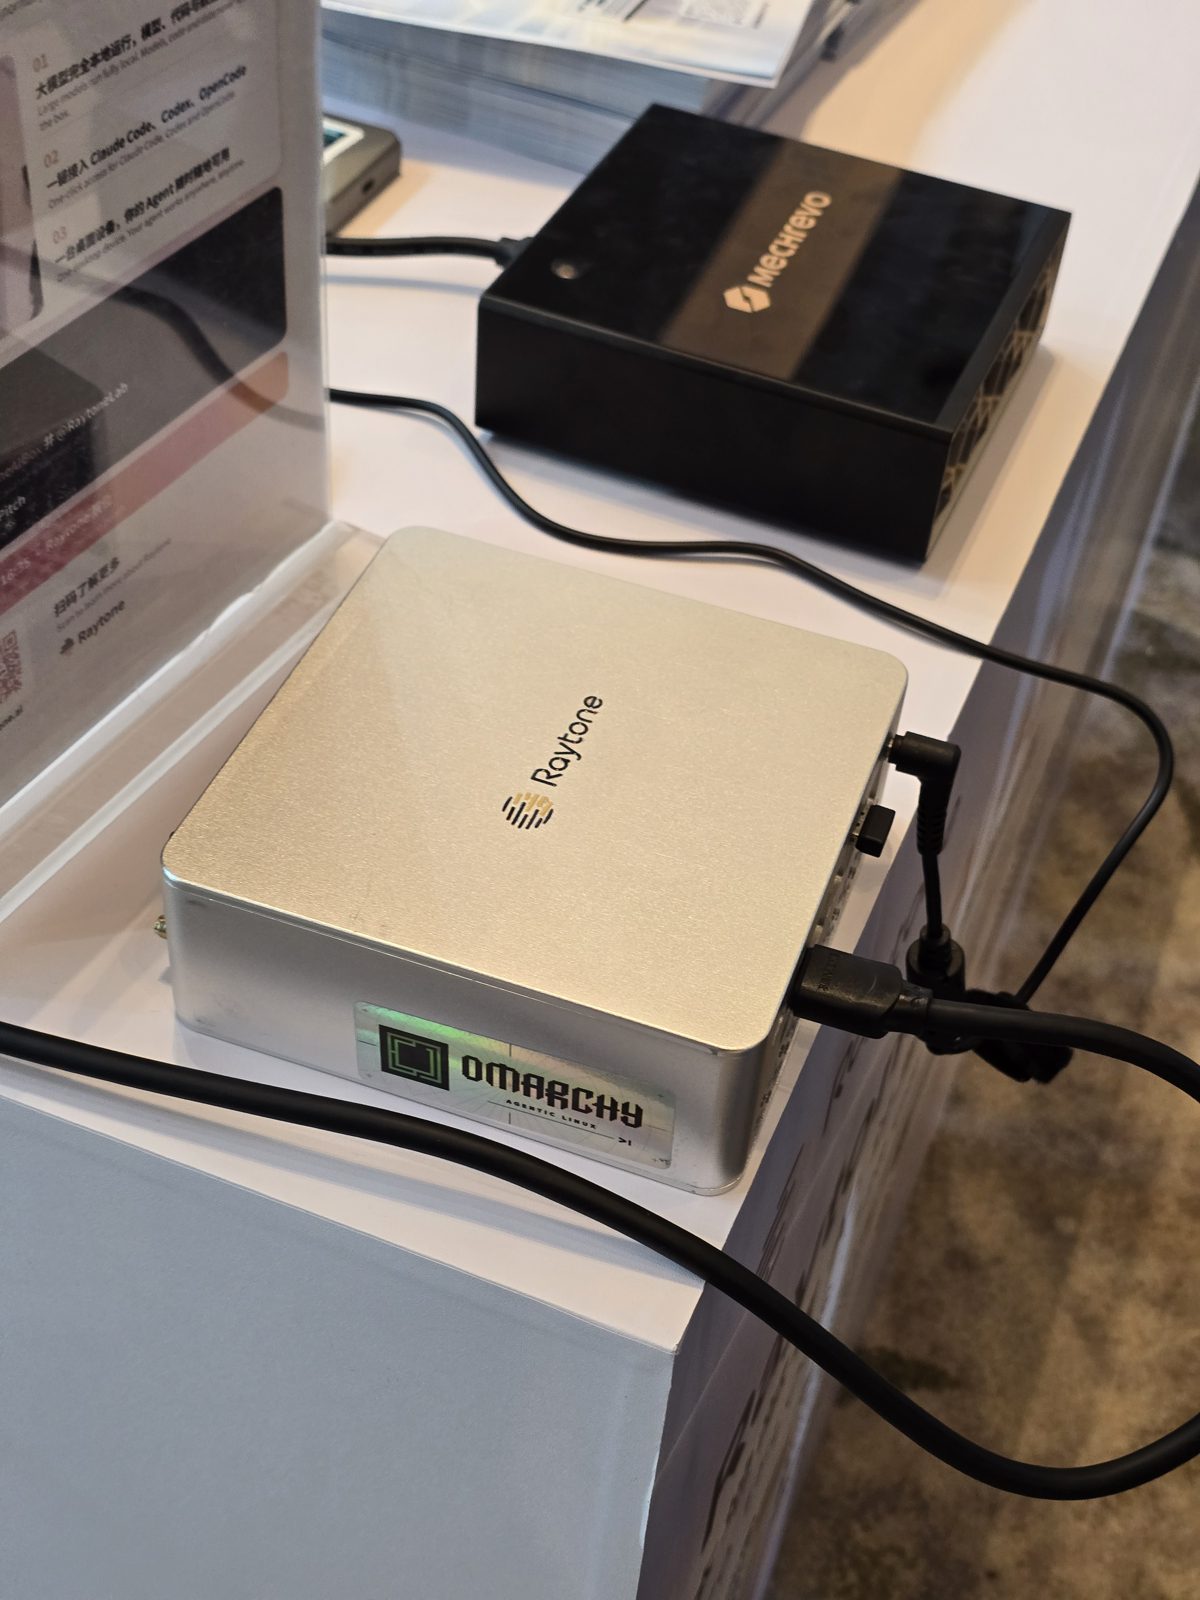
展示架上的 Raytone AI Box,正面贴着 Omarchy 贴纸。
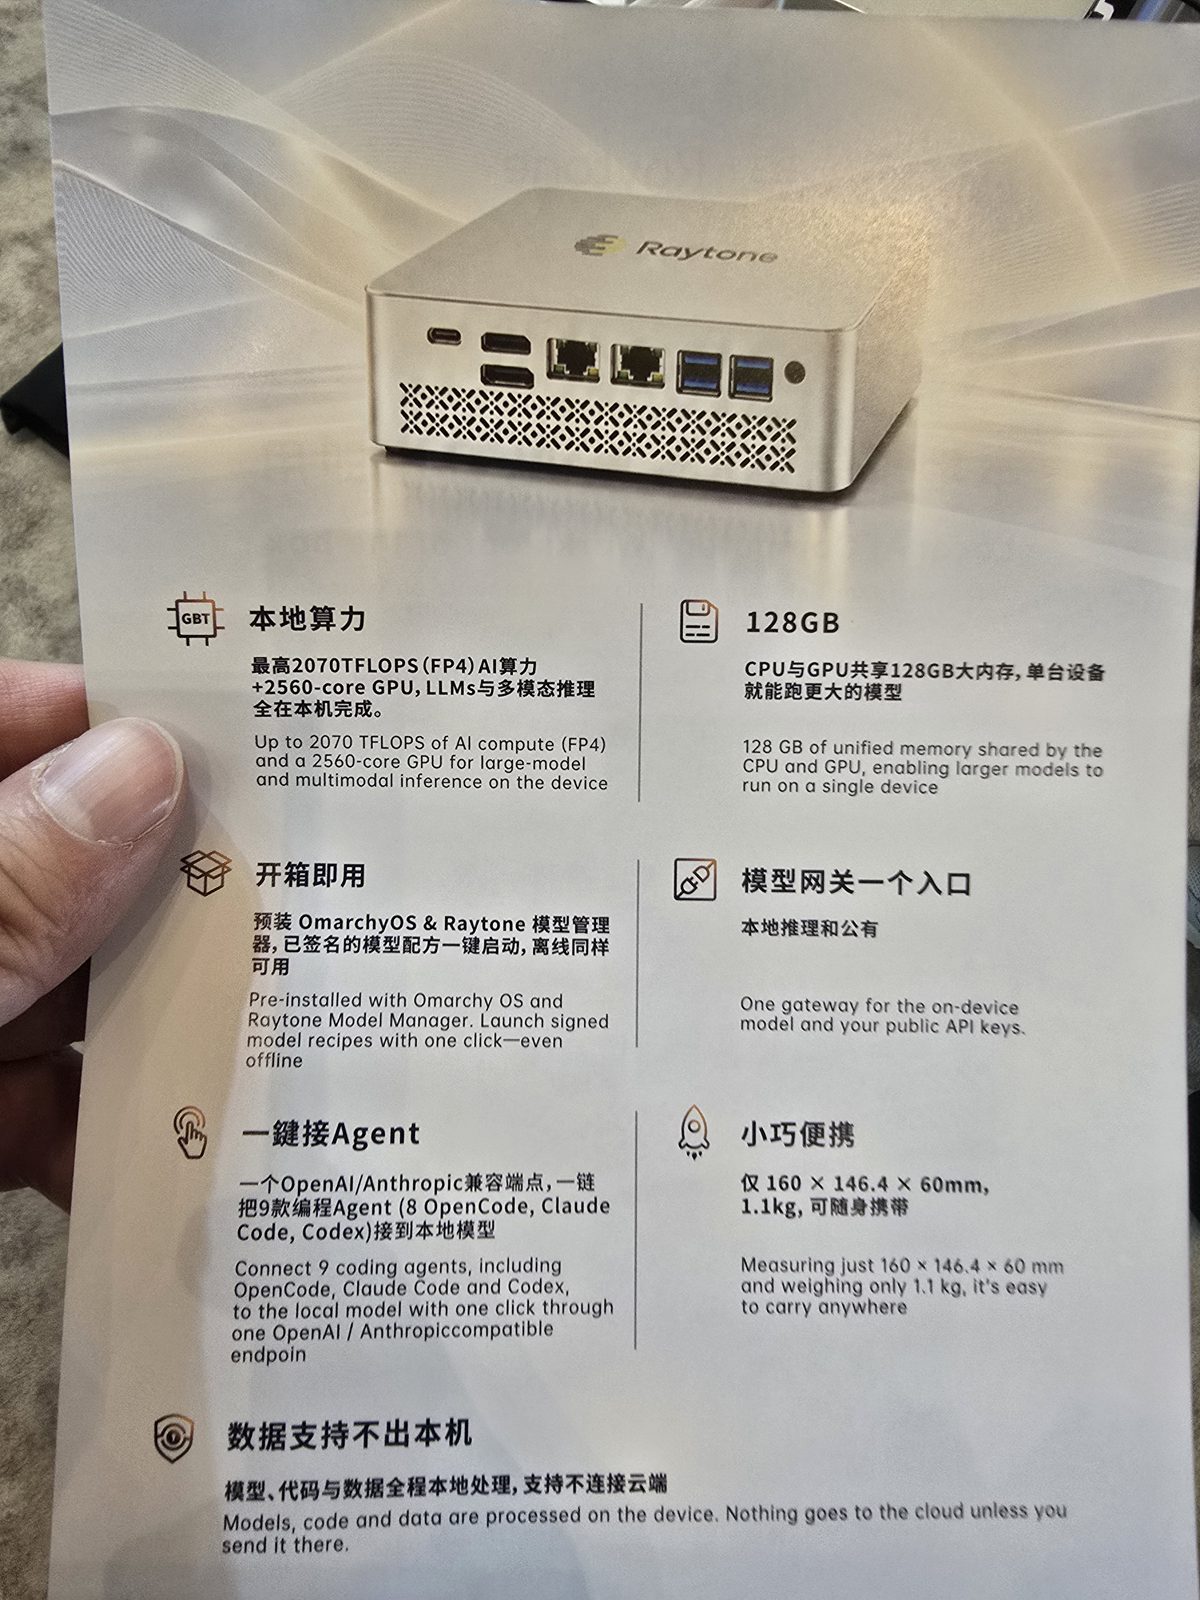
Raytone 的规格表:2070 TFLOPS FP4、2560 内核 GPU、128 GB 统一内存、一个闸道同时接本地与公开模型、九种 coding agent 通过同一个 endpoint 使用,数据留在设备上。
当天早上我在 Zilliz 的摊位拿了一张 Vector Lakebase 的传单,下午 Rentong Guo 就讲了这个。传单上写的是 S3 上只放一份 Vortex 栏式格式的数据,矢量索引直接建在 Lance 和 Iceberg 数据表上。
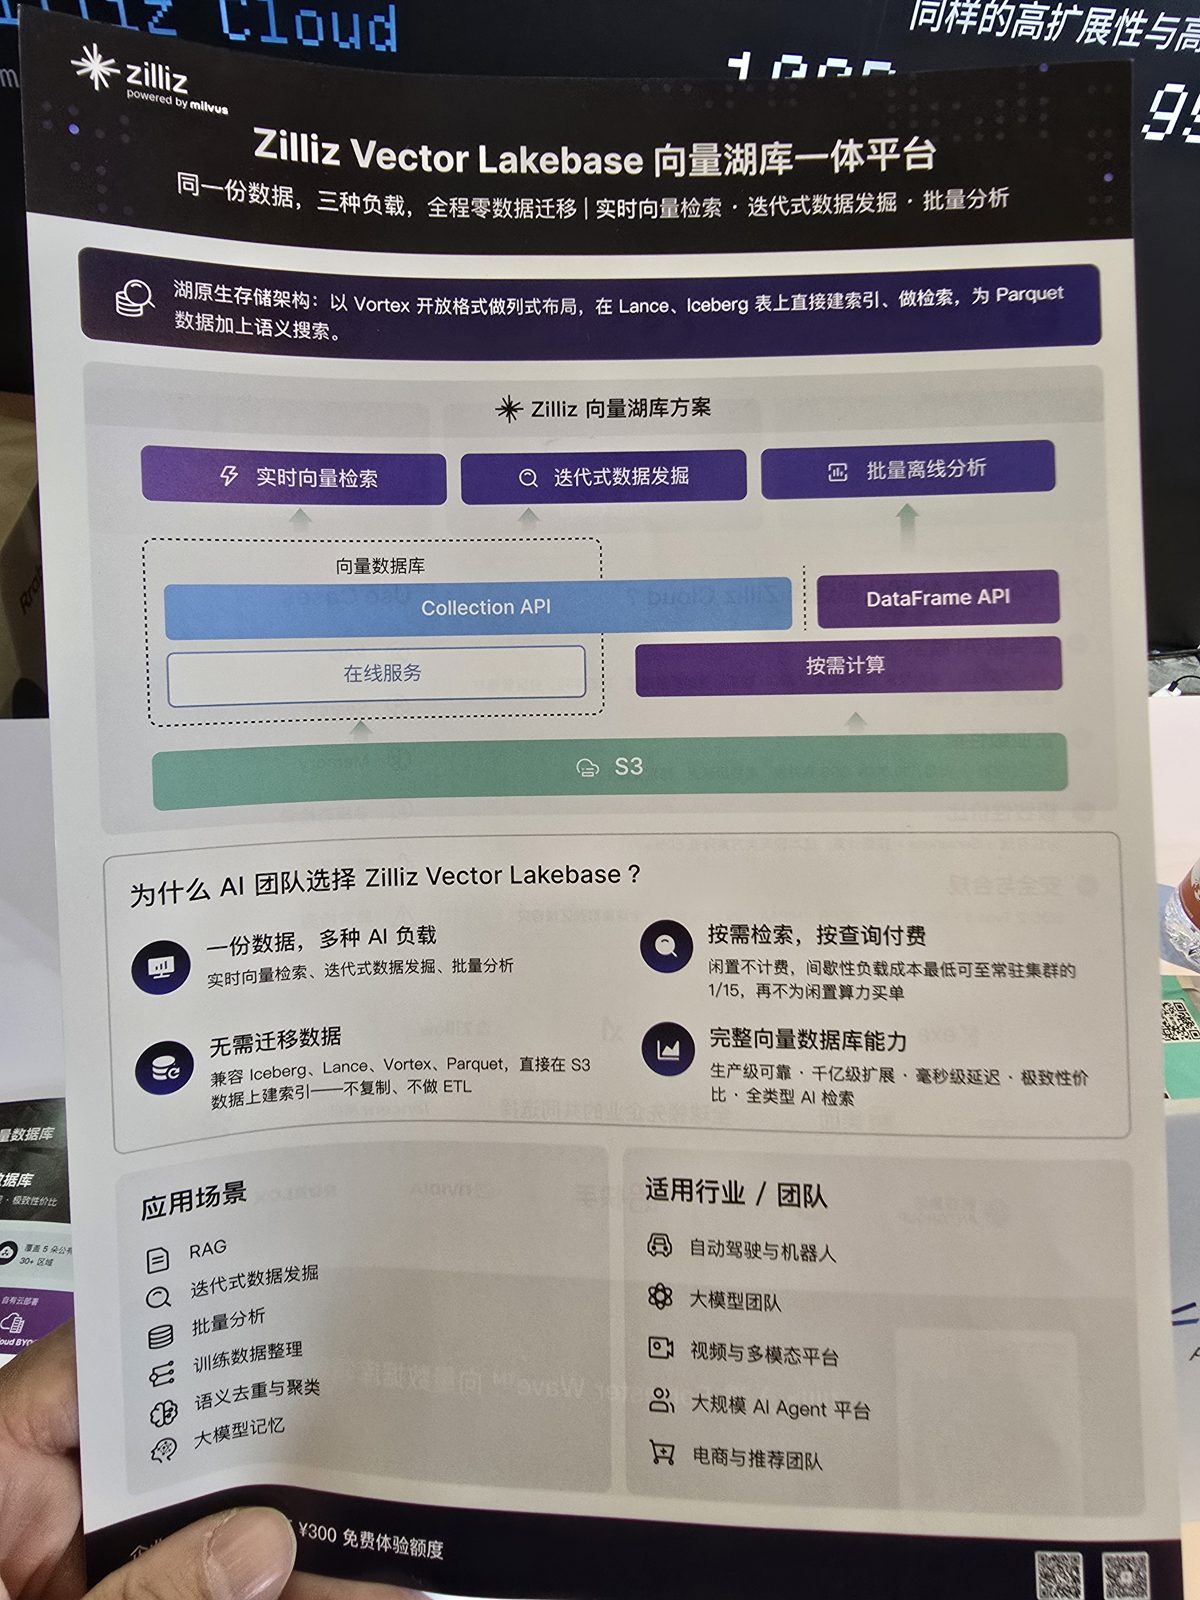
Zilliz 的 Vector Lakebase 传单:在 S3 上同一份数据上做即时矢量搜索、反复的数据探索与批量分析。
AI 时代的社群 — AJ (WaytoAGI), Koji (Crossing), Kai Qu (42 Chapters)
下午由一场 40 分钟的座谈开场,与谈人都在经营中国的 AI 社群。AJ 创办了 WaytoAGI,它一开始只是一份共享文档。Koji 主持 podcast《十字路口》(Crossing),在上海经营 AI Hacker House,也是真格基金的投资合伙人。Kai Qu 经营 42章经,这是一个给创业者和投资人的 podcast 和微信公众号。主持人是 Linkloud 的高宁,Linkloud 是一个做海外市场的中国创业者社群。
Koji 用两个故事说明社群为什么重要。2010 年左右,他还是北航的学生,同学的目标都是微软亚洲研究院或美国的研究所,他却跑去五道口的饭否实习,酷讯和早期的快手就在几栋楼外。只有在那里,他的选择才显得正常。第二个故事发生在 2016 年。后来创办 Manus 的肖弘,当时花完了真格基金人民币 100 万元的天使投资,却一直没做出起色,差点就要放弃。真格的刘元叫他来北京找创业者聊聊,Koji 也是其中之一。肖弘和两位共同创办人从武汉飞来待了一个下午,回去之后决定继续做下去。Koji 的结论是“人需要同类”。
大约十年来,Kai Qu 试过几千人的社群、昂贵的商学院、饭局和各种活动,最后的结论是:你做出来的东西,是由你的商业模式决定的。媒体和社群赚钱靠的不是广告就是交易,广告跟着流量走,交易跟着社群走。42章经大约有 50 万粉丝,但大部分的工作是社群活动、财务顾问和自己的投资。它放弃了广告,改做高价、有筛选的服务。他说,没有这种诱因的社群起得很快,一两年内就消失了。
AJ 讲的是规模的另一端。WaytoAGI 从那份文档开始,长到微信群和飞书群,然后是直播连接,再来是线下聚会,从一个城市到五个,现在是 52 个。运作的机制是线下创建起来的信任。见过几次面的成员知道彼此的人品和“交付能力”,所以擅长销售的成员接了单,可以把工作转给其他成员,不用自己雇人。有个成员在社群直播上推出一个短剧工具,当天就拿到 200 个用户。今年的重点是楼:AJ 介绍了北京亦庄一栋八层楼,里面有一百多家一人公司(OPC),还有成都的一个新空间,以及一个跟红杉等伙伴合作的育成计划。
讲到 2026 年,大家的心情不太一样。AJ 看到成员从玩 AI 转向创业,大多是辞职出来做 OPC,赚跟以前一样多的钱,但更自由。AJ 说投资人对 agent 新创越来越谨慎,“因为现在谁都能做”。Koji 把基础模型比喻成一辆从马路正中间开过来的坦克。站在它前进路在线的应用层创业者,今年过得最辛苦。务实的人往下挖,去做 forward-deployed engineering、数据、基础设施、芯片、推论加速和 API 中转服务,或是往上飞,去做 AI for Science、生物和 AI EDA。Kai Qu 说他接触的每个人都很焦虑,现在的 pitch 都是从最新的模型能做什么出发,而不是从用户需要什么出发。
他们对多常公开发声意见不同。Kai Qu 说要保护好你的势能。每周都在讲话的创办人,会开始重复自己。他的很多来宾累积了十年的功夫,才有一集很棒的内容可以讲,下一集要再等三到五年。他补充说,大部分来宾上节目是为了招人,不是为了曝光。AJ 的看法相反:信息落差已经消失,AI 生成的内容把所有人都淹没了,大公司又在送 token,所以创办人应该拿出更多实质的内容,也要更会表达。AJ 认为中国创办人在台上的表现不如 OpenAI 和 YC pitch 活动上的创办人,并引用了 Manus 张涛的一篇贴文:他的团队在写 PRD 之前,会先做一支“PRV”,也就是功能的视频。Koji 的回答是把公关(PR)当产品来做:先把叙事灰度发布给几个朋友,对目标受众做调查,再找做过的人请教。
从模型智能到 Agent Harness:让长时程 agent 跑得起来 — Ailing Teng (StepFun)
Ailing Teng 是 StepFun 的模型产品、平台与生态总经理,StepFun 是上海的一家模型实验室。她的问题是:交给 agent 好几个小时的工作,它要怎么记住目标、根据回馈调整,最后交出你信得过的东西。她的答案分成两半。模型可以容纳更多信息,但记住一个长任务进行到哪里,是 harness 的工作。
她用四个特性来介绍九月发布的 Step 5 Preview,这也是你拿任何模型来做 agent 时都该检查的四件事。它每个 token 激活 27B 参数,这点很重要,因为长任务会把同一个步骤重复几千次,你付的钱就是每一步的成本。1M 的 context 主要用在代码、长文档和任务纪录上,她说除此之外,更长的 context window 帮助不大。原生的视觉能力让 agent 能看截屏、设计稿和渲染出来的结果,检查自己的成果。tool calling 则是回馈能够成立的前提。
她的证据是三次长时间的运行。一个 agent 针对单张 H100 反复优化一个 kernel,跑了超过 22 小时。一个 post-training 数据 pipeline 的实验,准确率从 53.3% 提升到 60%。一次宝可梦的游玩,没有针对游戏做任何调整,花了超过 3,000 轮和 6M 个 token,打完大约三分之二的主线剧情。她也谈到训练。StepFun 自己建了 Step Code Bench,repository、编程语言和任务都是他们挑的,现在开发者说这个模型很擅长修 bug 和重构。她的心得是“做了就有,没做就没有”,意思是不是所有东西都能等泛化来解决。
harness 这一半点出了四个缺口:忘记需求、一再重走失败过的路,log 太多,缺少验收标准,以及云端的工作必须在 client 断线后继续跑下去。Step Code 是 StepFun 开源的 harness,它把进度放在 context window 之外的四个地方:记录目标和步骤的任务树、包含进度和下一步的计划、session 历史,以及放代码、log 和输出的文件系统。每一步都会从目前的目标、相关的文件和最新的工具回馈,重新组出工作用的 context。log 和截屏会先经过一个预算阶段,把文本截短、把图片压缩,旧的 log 留在外面,需要时才拿进来,subagent 只交回结论。验证方面,她希望在运行之前就把验收标准定好。以网页来说,能编译只是其中一步,它到底有没有做到用户要的,得由用户和 harness 一起定义。
她描述的运行架构是大脑和手:云端的 harness 负责规划和检查,目标、计划和 session 历史放在中间,手则是本机或远程的 sandbox。stepfun.com 上的 Studio 就是那个云端 harness,桌面版 app 预计在十一月推出。效率的部分她跳过了,相关问题请大家去摊位问。
从 Dark Factory 到 Lobsterville:持续运作的多人 agent 的意图工程 — Vincent Koc (OpenClaw Foundation)
Vincent Koc 是基金会的首席架构师。摘要里写了“Lobsterville”、多人 steering 和意图交接,二十分钟里大部分讲的是 OpenClaw 的 CI 帐单。
他从四月在伦敦的演讲讲起,当时的主张是工程师已经变成工厂经理,瓶颈在工程师的品味。从那之后,他自己的配置从 10 到 15 个 agent 长到 60 个,他说现在平行跑的超过 300 个。他说演讲前一天他出了大约 1,000 到 1,500 个 PR,再前一天将近 2,000 个,都是在中国的饭店房间里,其中一半是用手机通过 Telegram 做的。他的限制是 token rate limit、内存、运算资源、CI,还有“你想得到的每一家公司、每一个供应商的每一个 rate limit”。
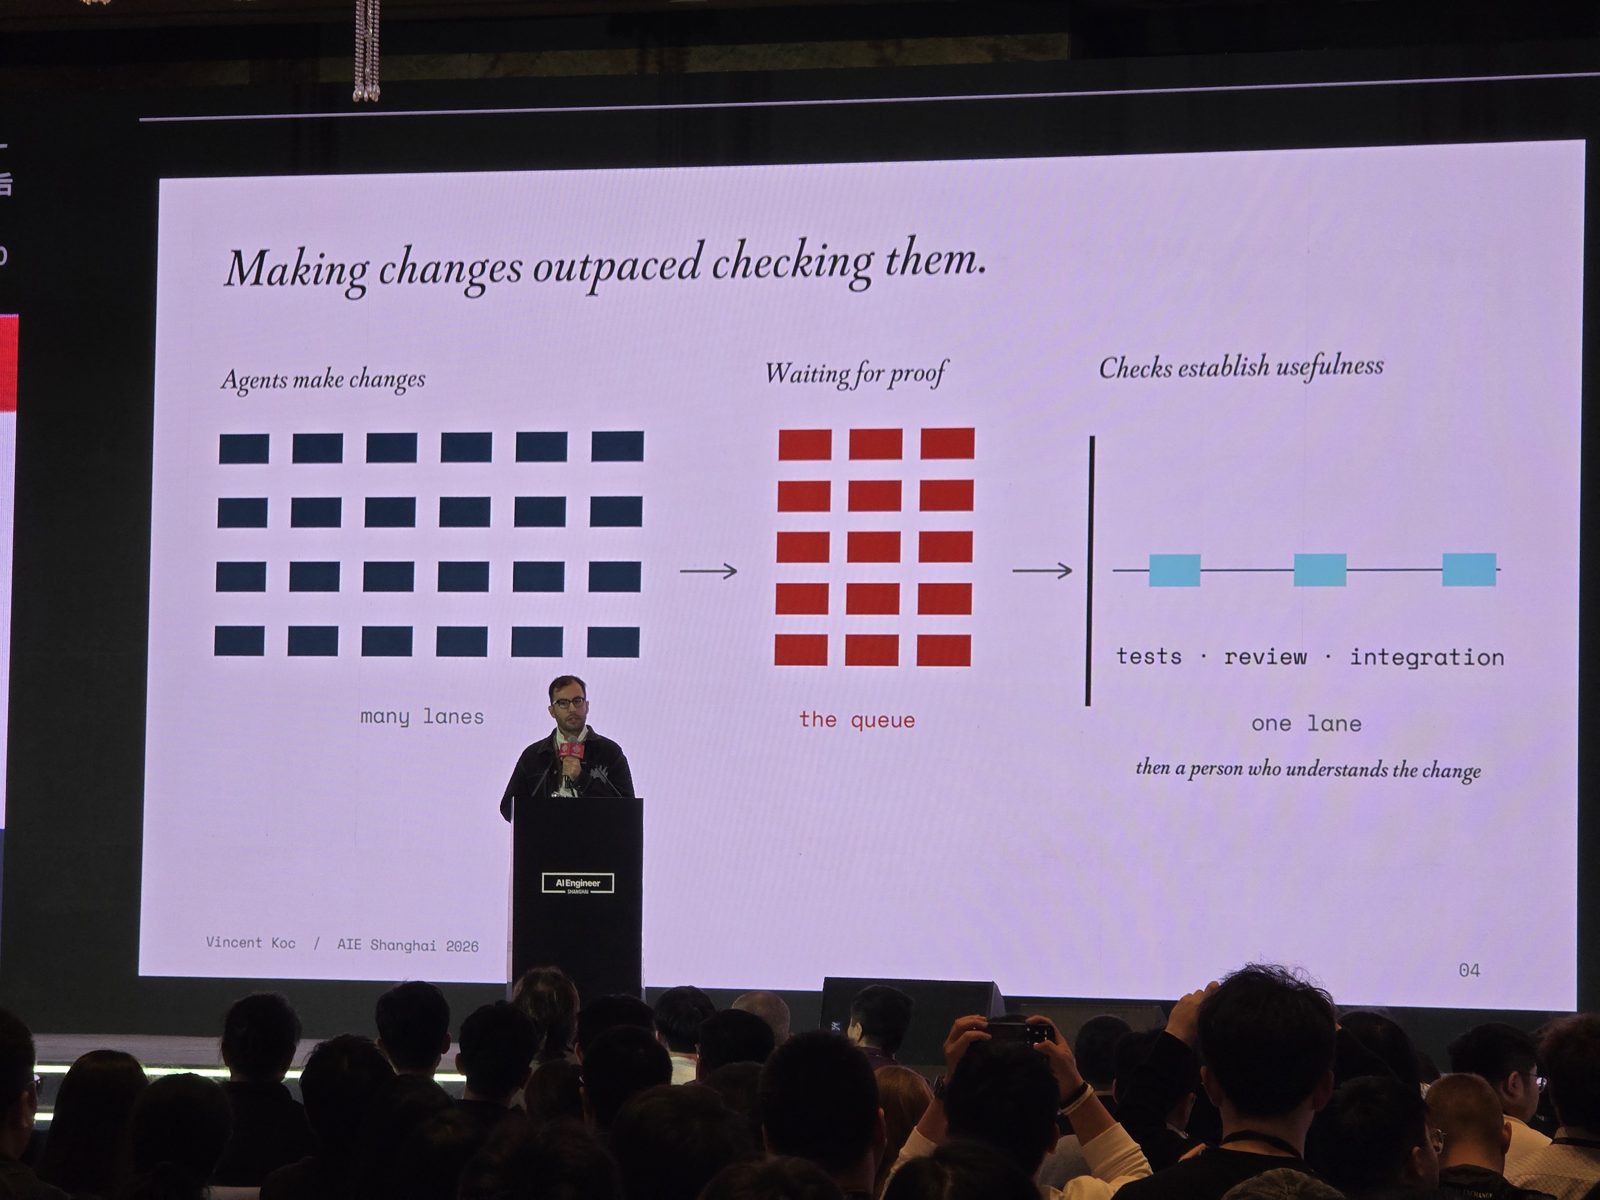
第 04 张投视频“改动的速度超过了检查的速度”:许多条 agent 改动的车道导入一个等待证明的队列,队列只能经由一条测试、审查与集成的车道消化,最后还要一个真正理解这个改动的人。
他现在的论点是瓶颈已经移到“证明”:在合并之前你怎么知道一个改动是对的。他把工作分成背景循环(尝试、检查、改进),这只在回馈明确的地方有效;以及前景工作,由人来选择结果、查看证据。他把这个新工作叫做“proof engineering”,形容自己是“proof engineer,或者说基本上是个 vibe eval guy”。其中一个例子是 OpenClaw 的 computer-use 功能:他们把 Doom 放进去,让一个 agent 每次找到慢的地方就把游戏循环改快一点。
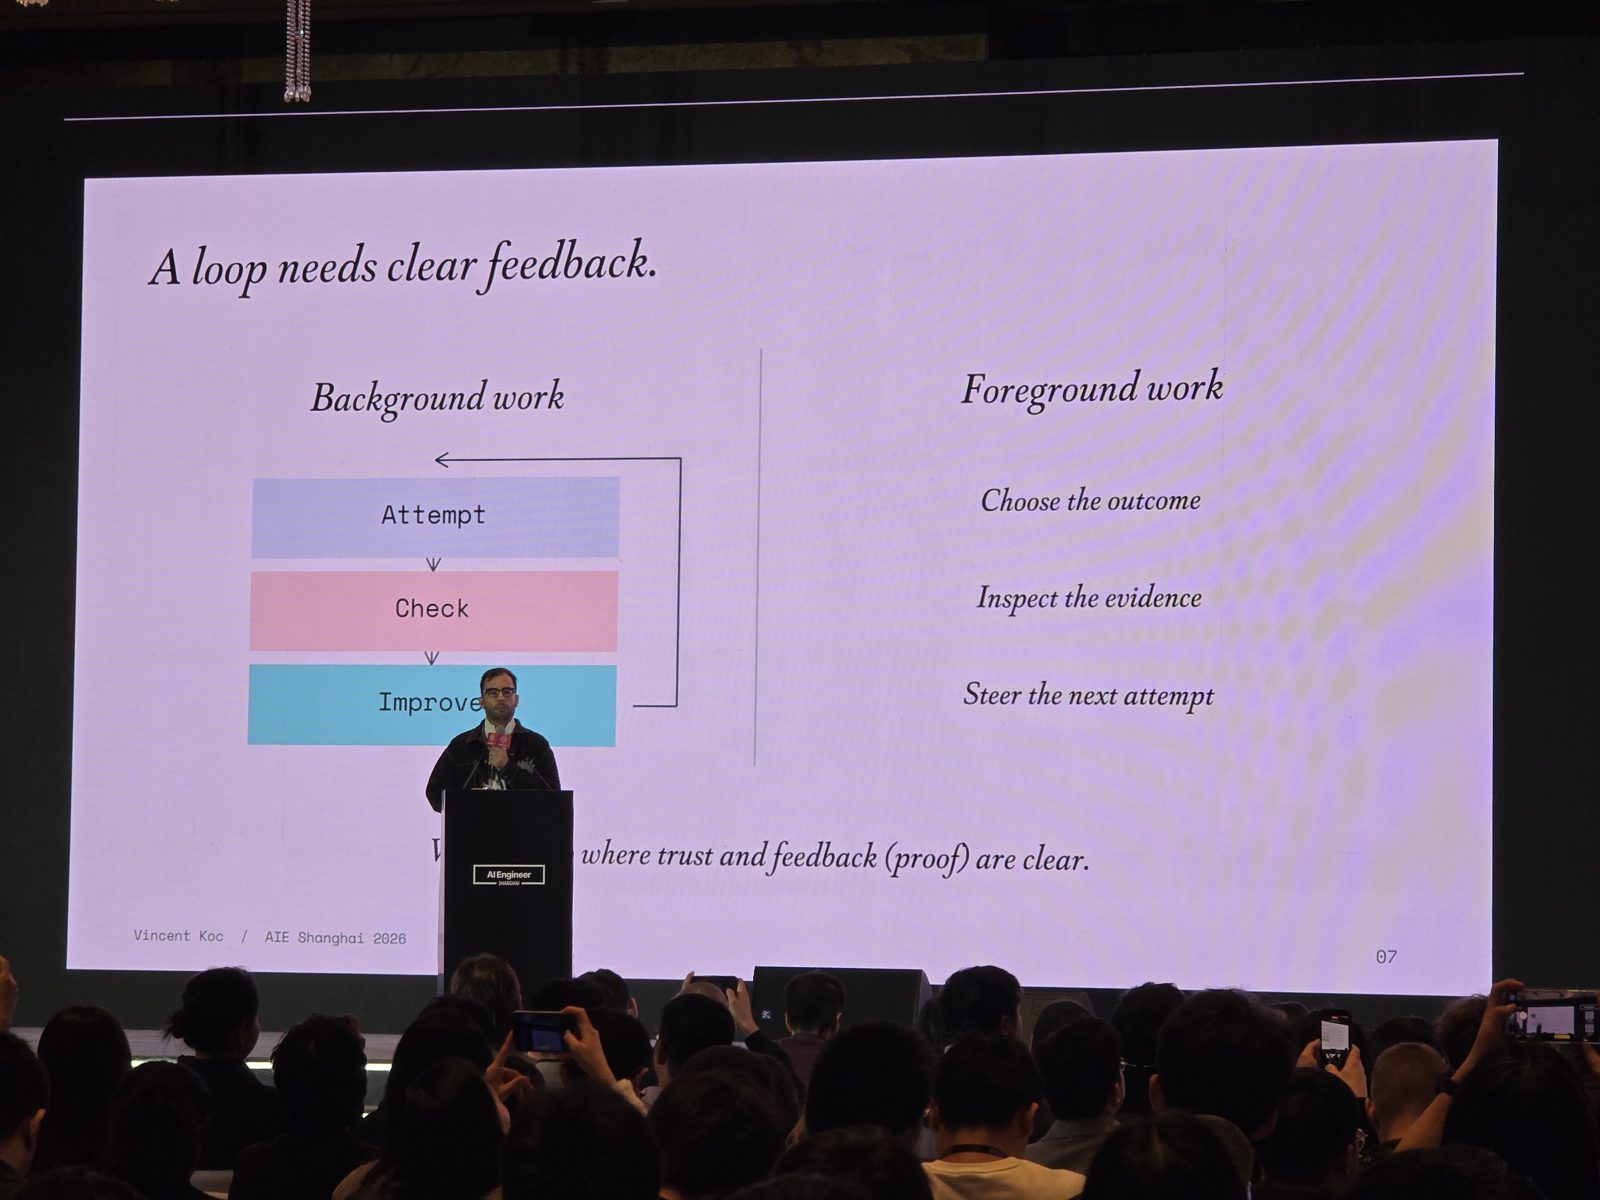
第 07 张投视频“循环需要明确的回馈”:背景工作是尝试、检查、改进的循环,前景工作是选择结果、查看证据、引导下一次尝试。
接着是数字。九月中,OpenClaw 的 CI 以 Blacksmith runner 的牌价计算,每月会烧到 127 万美元。对一个他形容为“五、六个工程师”的非营利组织来说,这是很大的数字,即使大部分运算资源是赞助的。agent 不断添加测试,而你又不能直接删掉,因为测试是证明 agent 有做事的唯一依据。他们的做法是把 main 上的 CI 整个关掉。现在 PR 只跑有限的检查加上 agent 审查,完整的测试每 30 到 60 分钟跑一次,发版时也跑。
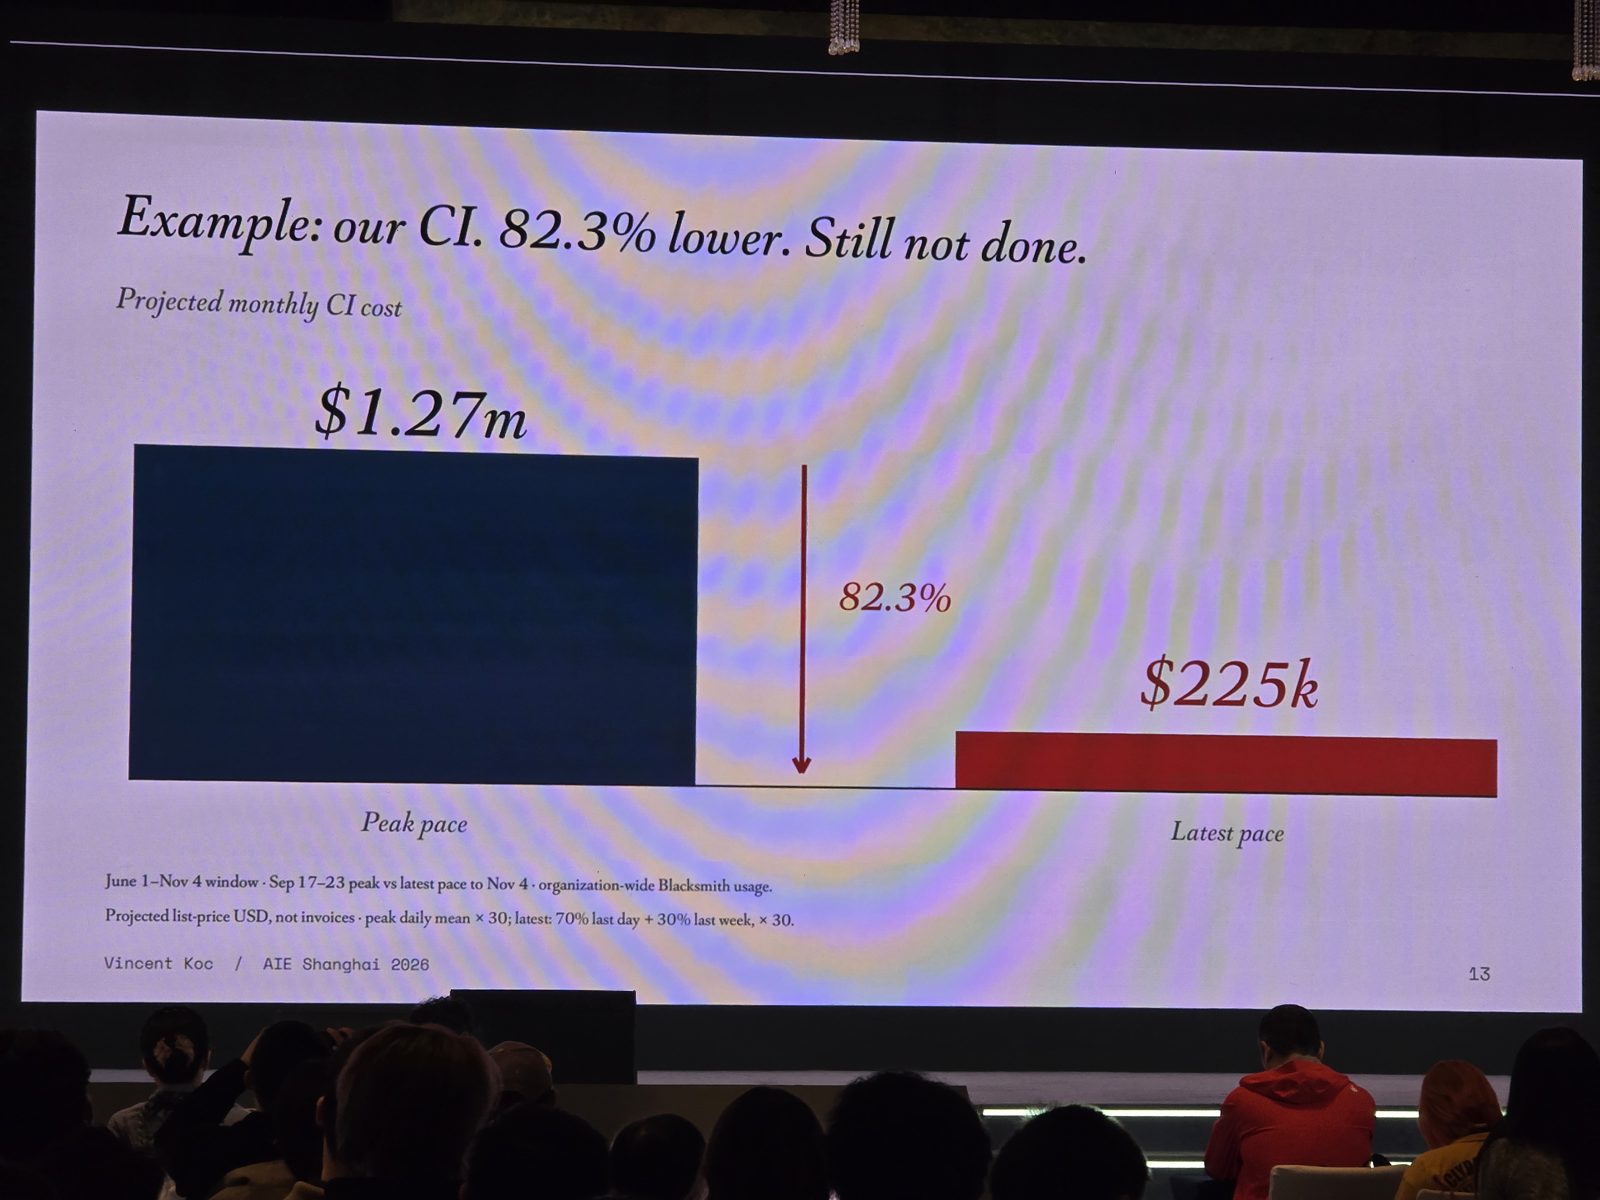
第 13 张投视频:预估每月 CI 成本降了 82.3%,从九月高峰时的 127 万美元降到最近的 22.5 万美元。标题还加了一句“还没结束”。
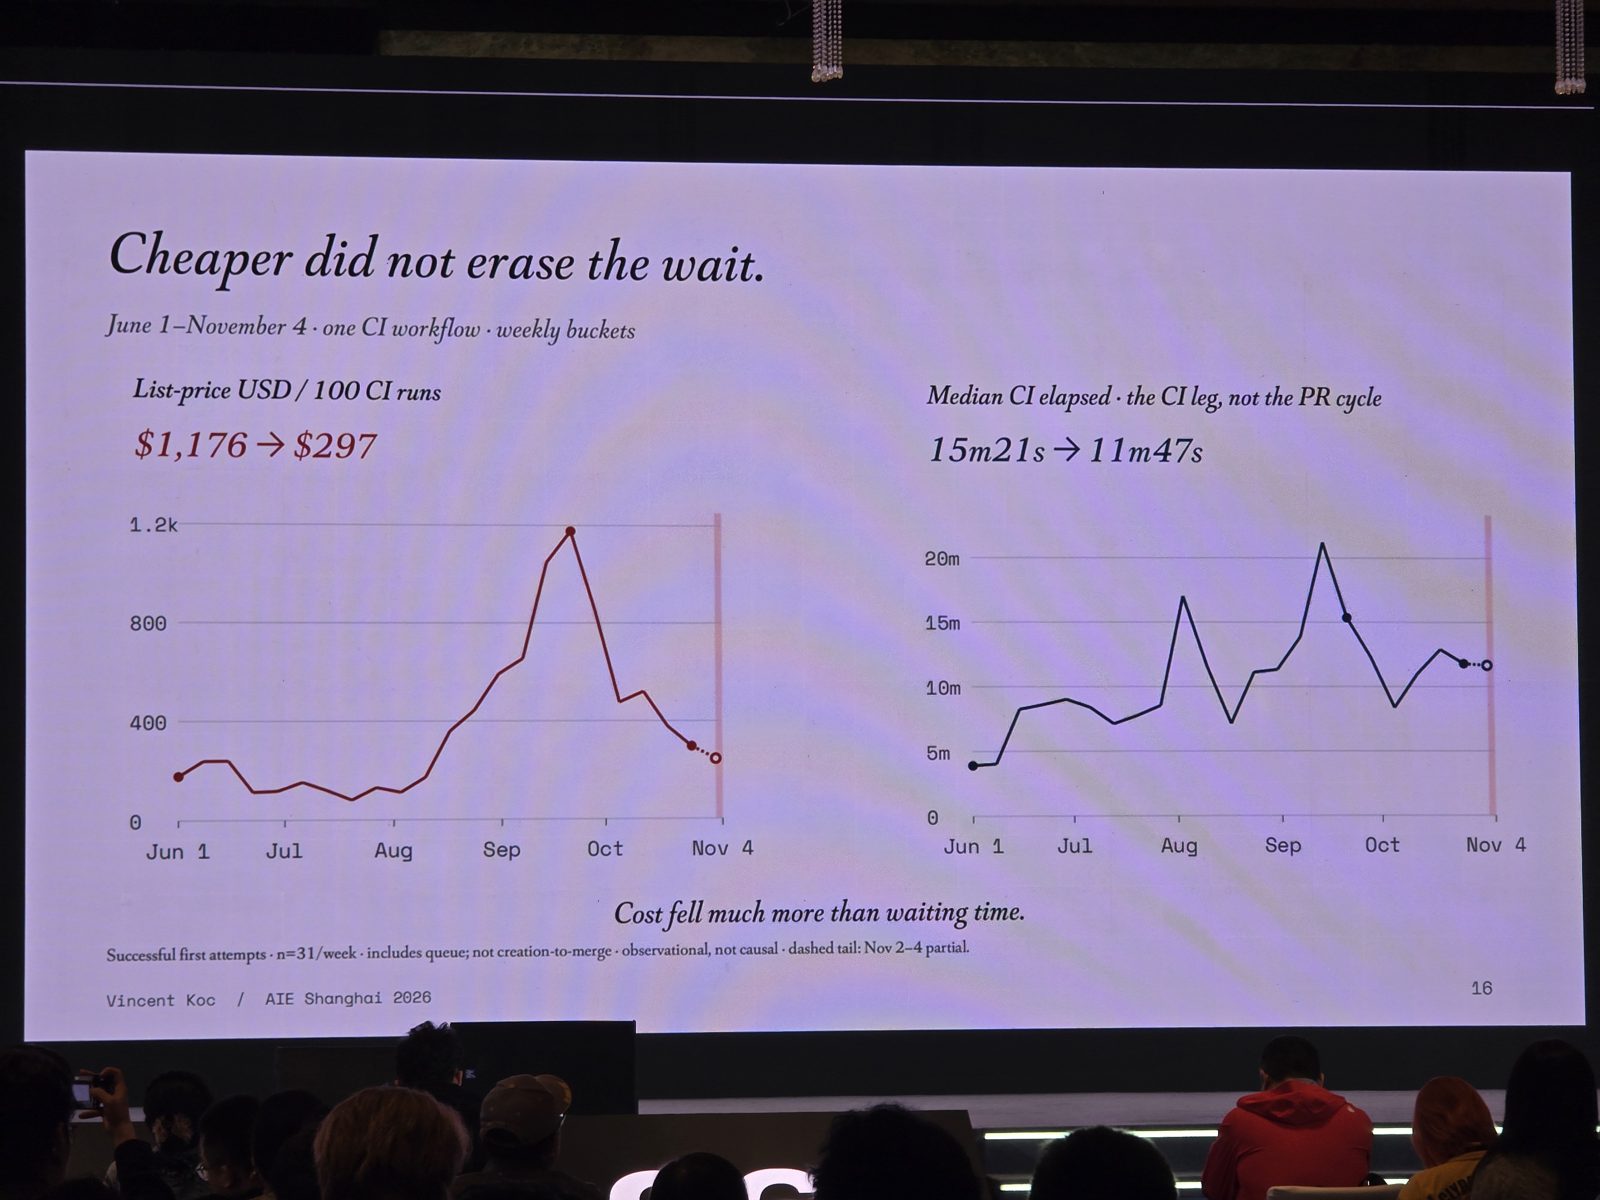
第 16 张投视频“变便宜并没有消除等待”:每 100 次 CI 的牌价从 1,176 美元降到 297 美元,但 CI 时间中位数只从 15 分 21 秒降到 11 分 47 秒。
每 100 次的成本降了四分之三,但 CI 时间中位数降不到四分之一。他追踪的是 agent 的周期时间,也就是 PR 开出到 PR 合并,他的说法是“如果工厂慢下来,工厂就没办法修好自己”。下一步是 adaptive testing,几天前才合并:一个分类器看改动到和运行到的代码,预测哪些测试可能会 regress,只跑那些。他预期这会让 CI 总成本再大幅下降。
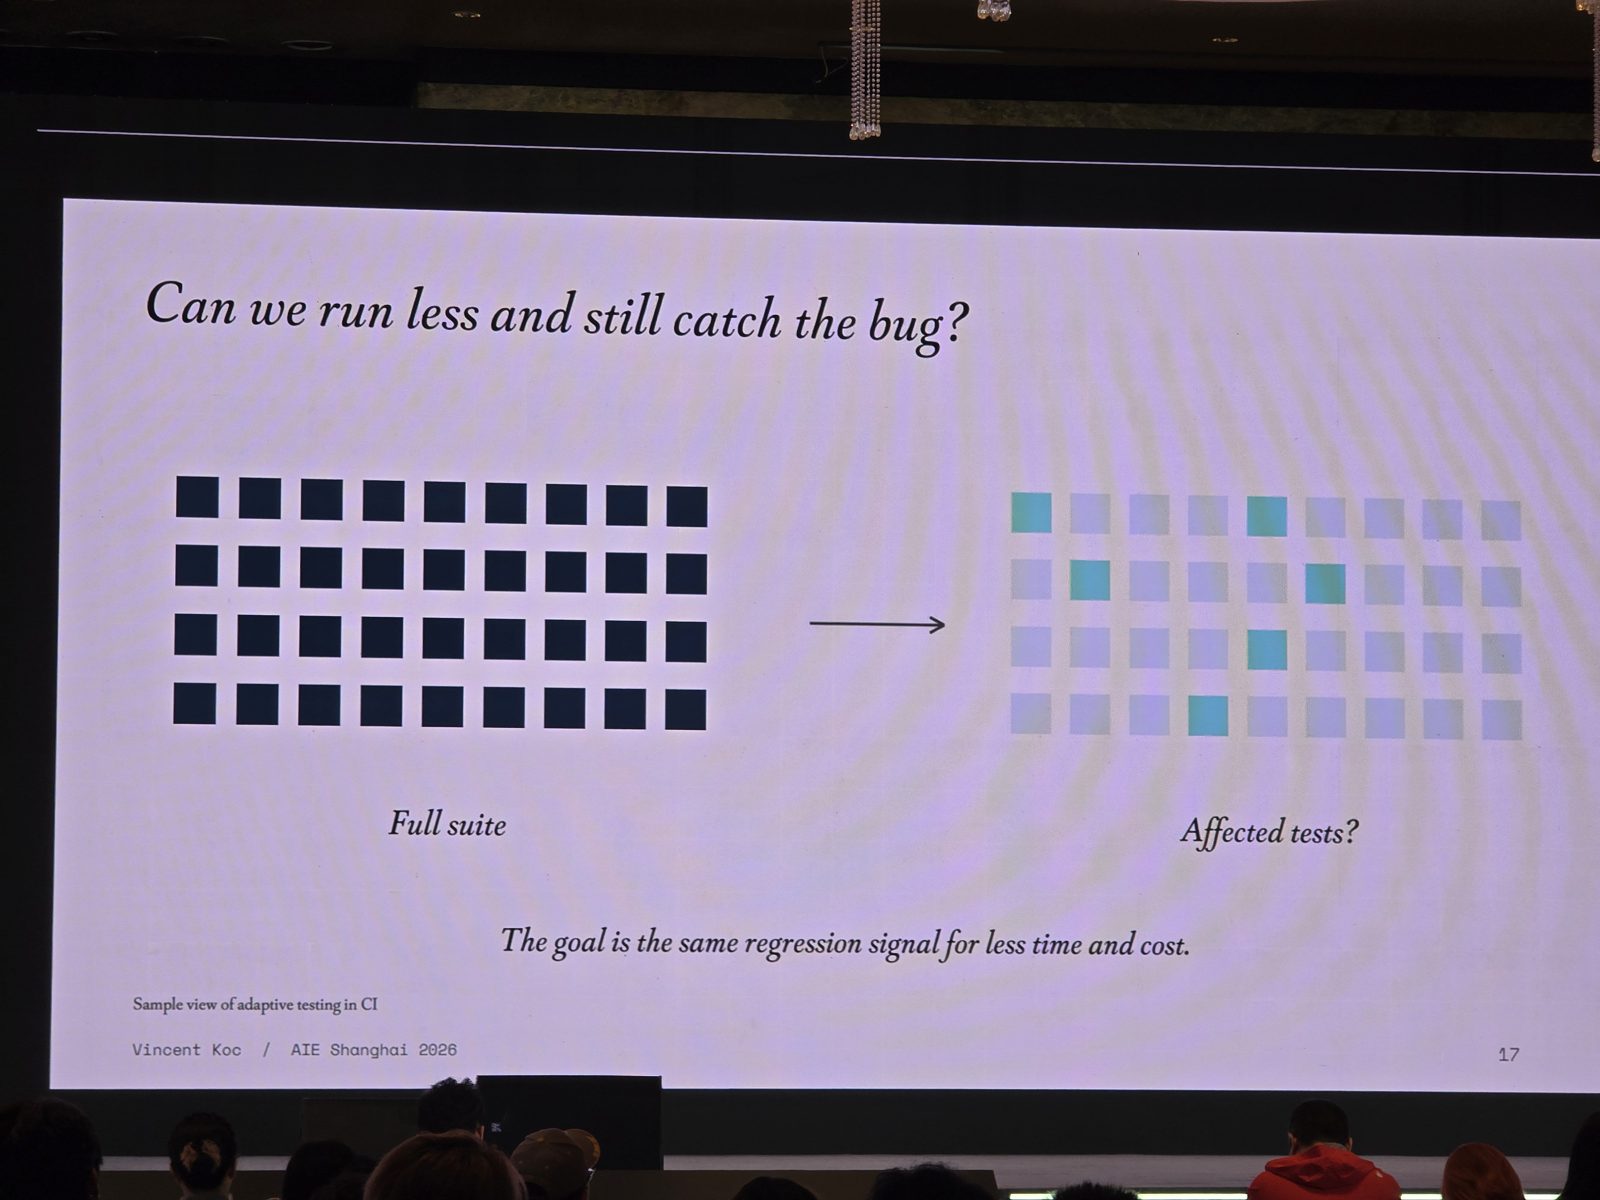
第 17 张投视频“能不能跑得更少,还是抓得到 bug?”:完整测试对上只跑受影响的测试,目标是用更少的时间和成本拿到同样的 regression 信号。
最后他介绍了一个针对个人 agent 的 benchmark,有 135 个任务,和合作伙伴花了两三个月建的,几天内会公开一小部分。任务刻意设计得很模糊,例如报税,或是两个人对结果有不同意见。
设备端 AI:让智能更贴近每个人 — Alex (AutoArk)
Alex 是 AutoArk(无界方舟)的 CTO,这家公司做的是在设备本身上跑的模型。前三分之一在讲为什么硬件不该依赖云端 API。他举的例子是一年卖一百万台的设备,每个用户一天跟它讲话超过 20 次。用公开 API 的价格算,token 帐单一年大约人民币 10 亿元,所以产品卖得越好,赔得越多。另外两个理由是常见的那些:在飞机上或电梯里没有网络,以及医疗、法律或投资工作的录音和文件最后会跑到模型供应商那里。
他也列出了代价。设备的内存、电池和续航都有限,不能直接把最大的模型塞进去,而且每个平台(FreeRTOS、Arm Linux、ESP32、iOS、Android)都需要各自的部署代码。
AutoArk 把硬件分成三层。给眼镜、耳机和小型陪伴机器人用的,是小到 0.1B 参数的 ASR 和 TTS 模型,demo 播了很快的语音转写和相当自然的情感语音合成。模型外面包着 EVA SDK,处理音频前端和全双工、可打断的对话。
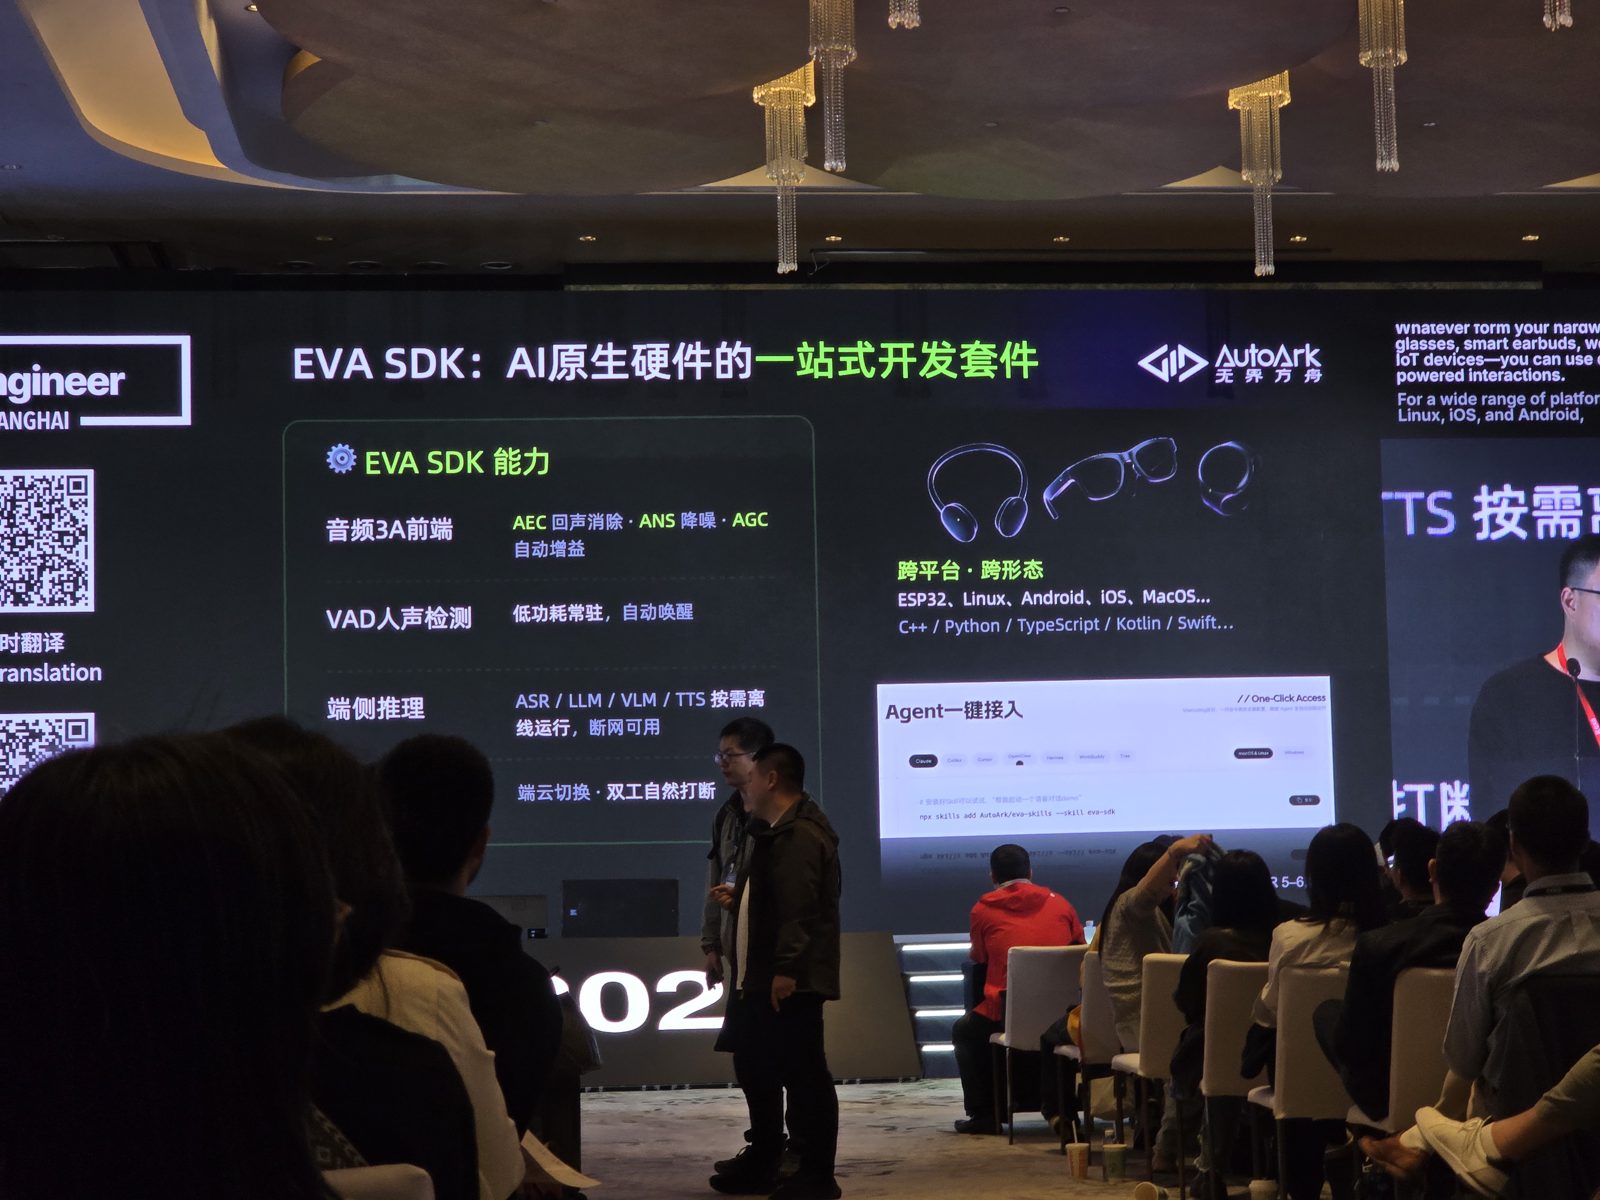
EVA SDK 投视频:音频 3A 前端(AEC、ANS、AGC)、低功耗 VAD 唤醒、可脱机运作的设备端 ASR/LLM/VLM/TTS、端云切换与全双工打断,支持 ESP32、Linux、Android、iOS 和 macOS,另外可以用一行指令装进 coding agent。
demo 是一个 35B 的 MoE 模型跑在 iPhone 16 Pro 上,内存最多用 2 GB,开着飞行模式,他说屏幕录像没有加速。说明很短但很具体。MoE 每个 token 只有 3% 到 10% 的参数是活跃的,所以完整模型放在 flash 上,只把活跃的 expert 加载 RAM。问题是连续的 token 可能需要完全不同的 expert,如果用到才从保存设备加载,每个 token 会花好几秒。他们的解法是训练一个“pre-router”,预测下一个 token、再下一个以及后面几个 token 会用到哪些 expert,然后由背景的 planner 异步加载,等 decode 走到那里时 expert 已经在内存里了。他宣称这让 decode 快了一个数量级。
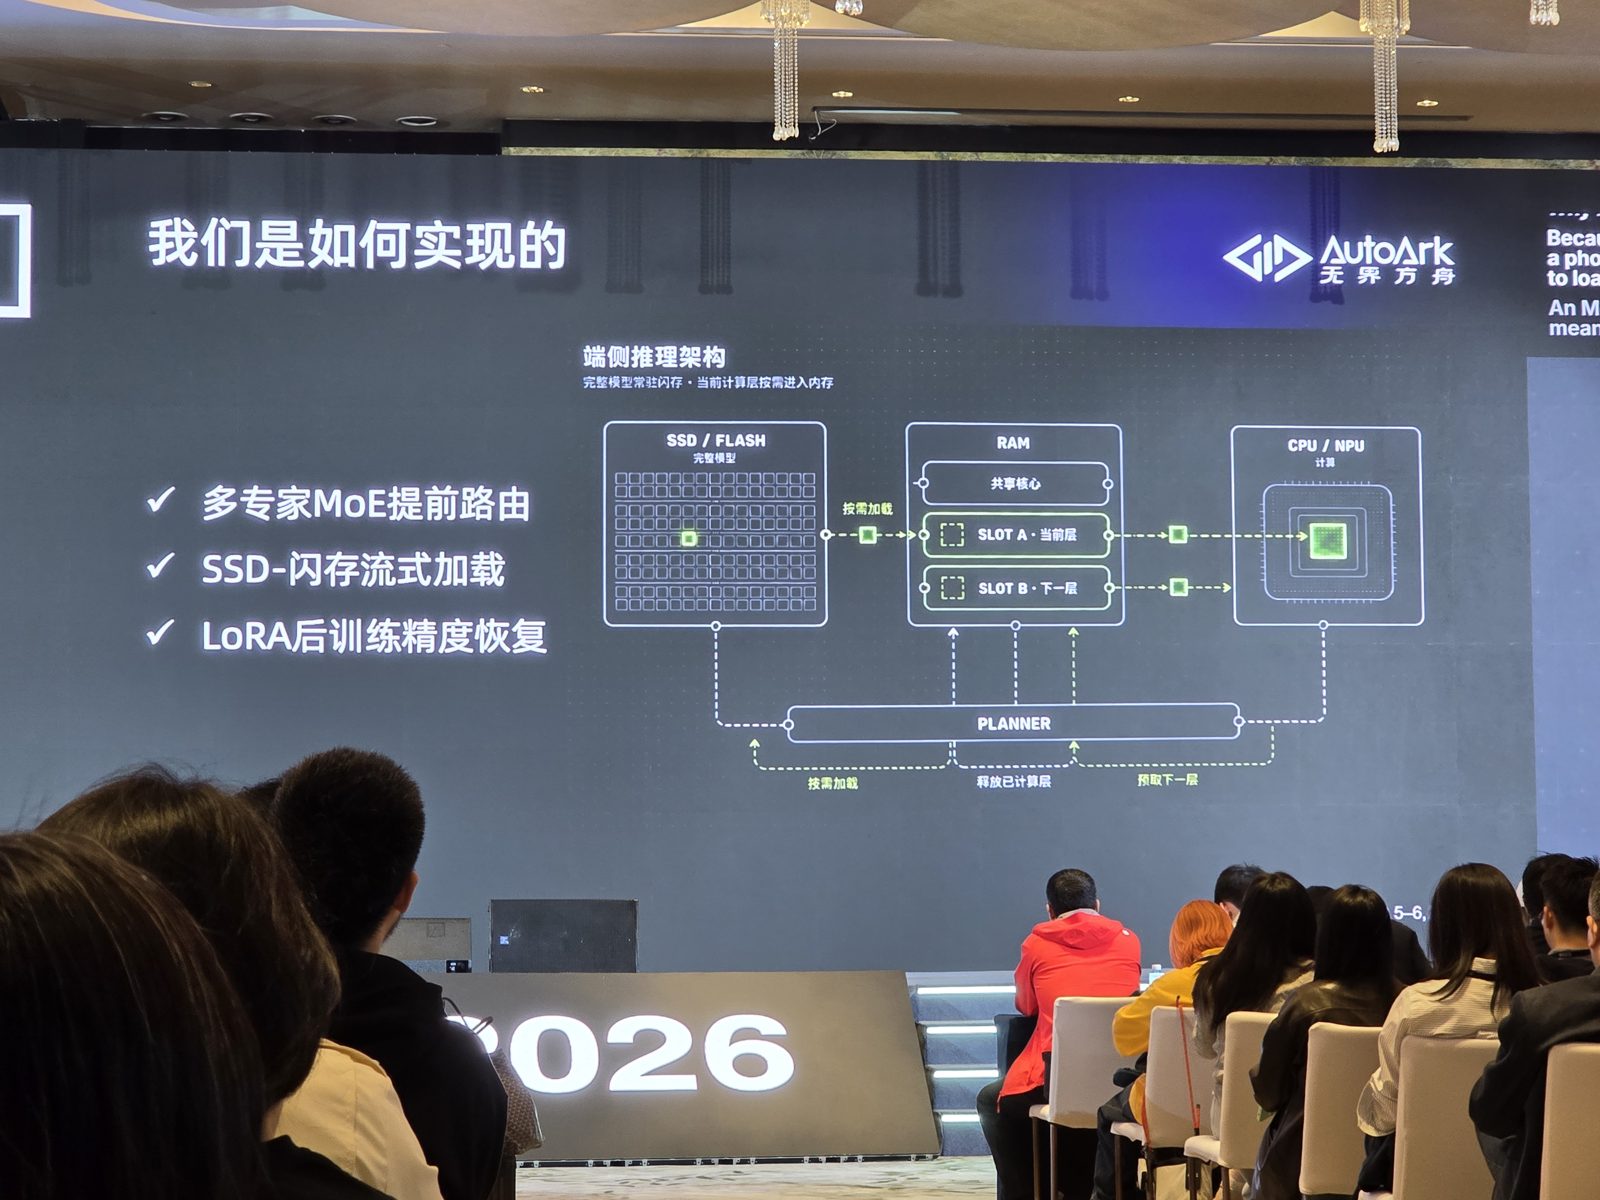
35B 模型怎么塞进去:完整模型放在 SSD/flash,RAM 区有一个共用内核和两个槽位(目前这层和下一层),CPU/NPU 负责运算,planner 负责预测并提前加载。左边三点是提前做 MoE expert routing、SSD/flash 串流,以及用 LoRA post-training 把准确度拉回来。
笔电和桌机这层,他预告了一个之后会开源的 150B MoE 多模态模型。他说它需要 18 到 24 GB 内存,prefill 超过 1,000 tokens/s,decode 超过 100 tokens/s。他们所有的模型和推论引擎都以 Edge0 的名义开源。
最后的案例是和 Shokz 合作的运动耳机。用户对耳机说的大多是切歌、音量、心率和步频。这些由设备端的 ASR 模型和意图分类器脱机处理,只有开放式的问题才送到云端。他说这让 token 成本降了超过 92%。
Kubernetes 不是你的 sandbox — Mislav Ivanda (Daytona)
Mislav Ivanda 在 Daytona 负责开发者体验,Daytona 卖的就是给 AI agent 用的 sandbox。他的论点很简单:如果你的团队需要给 agent 用的隔离环境,不要去跟 infra 团队要一座 Kubernetes cluster。Daytona 自己的 control plane 就跑在 Kubernetes 上,所以他不是在否定 Kubernetes 本身。他的意思是,Kubernetes 是为长时间运行、无状态、要能撑过故障和滚动更新的服务设计的,而 agent 的 sandbox 需要的刚好相反。它们生命周期很短,而且 agent 暂停之后就算两天后才恢复,状态也得保留下来。
Mislav Ivanda 在主舞台:sandbox 没有一个定论的定义,因为用法一直在变。
他花了几分钟讲 sandbox 这个词的意思怎么一路漂移。一开始指的是运行模型生成的 Python 的地方,后来变成给模型用的 shell。再后来,连 agent 本身都搬进了 sandbox 里。过去半年,大家为了 RL 相关的工作(eval、benchmark、post-training)同时跑上千到上万个 sandbox。现在,给没有 API 的企业应用程序用的 computer-use agent 也走上同一条路。
接着是 Daytona 眼中的 Kubernetes 数字。一个 pod 在真正跑起来之前要经过一连串固定步骤,所以最快 1 到 2 秒,通常是几十秒;大约每秒 100 个 pod;每个 node 默认上限 110 个 pod。状态的部分更糟。pod 没有自己的持久化磁盘,所以要挂外部 volume,结果所有 I/O 都要走网络。他引用的数字是 Daytona 本机磁盘大约 500K IOPS,EBS 则是 50 到 60K。挂载一个 volume 要几十秒,挂载失败的话要等六分钟才能重试。一个 node 只能挂 25 到 39 个 volume,所以真正决定一个 node 能放多少 sandbox 的是 volume 上限,而不是那 110 个 pod。
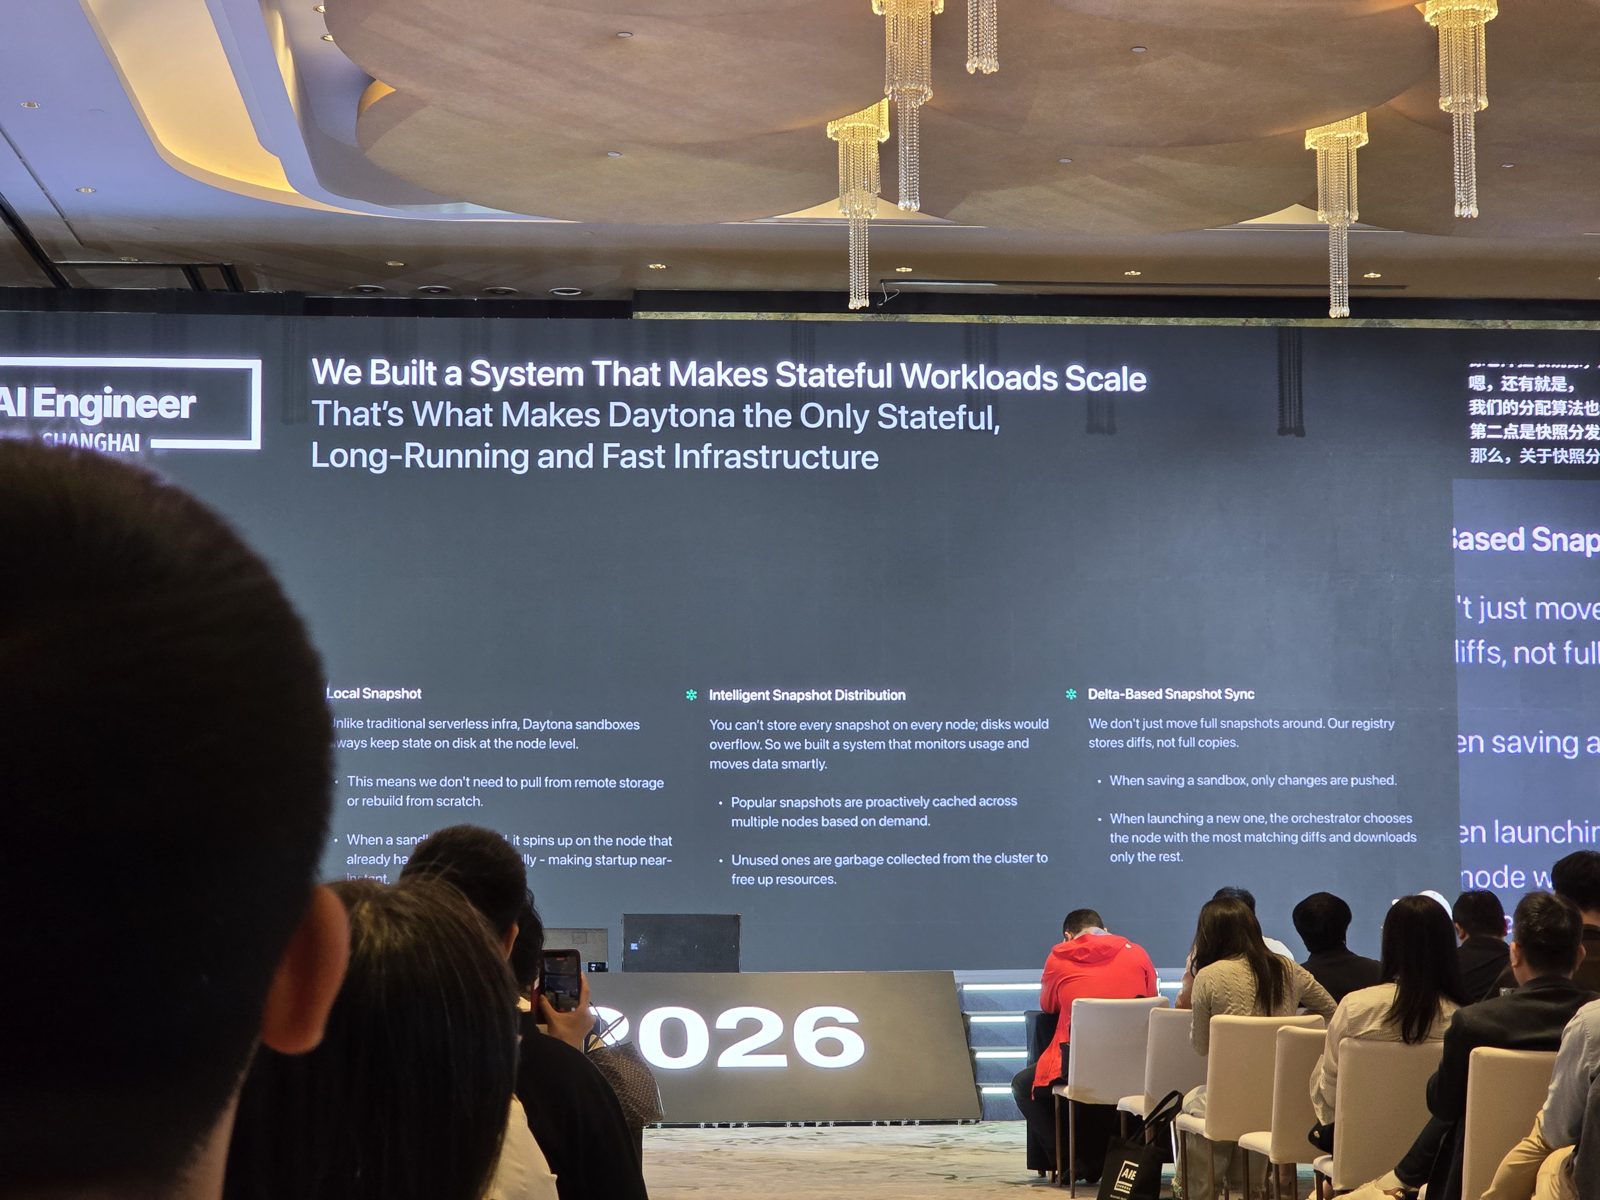
Daytona 的三个机制:snapshot 保留在 runner 的本机磁盘、热门 snapshot 缓存到更多 node 上,以及 registry 和 runner 之间只传差异。
Daytona 的做法是把状态留在 sandbox 运行的地方。停掉的 sandbox 留在 runner 的磁盘上,所以恢复就只是启动一个 container,调度时也会优先挑已经有 image 的 node。热门的 snapshot 会拷贝到更多 runner,没人用的会被 garbage collect,registry 存的是差异,所以就算是 cold start 也只需要拉缺少的部分。
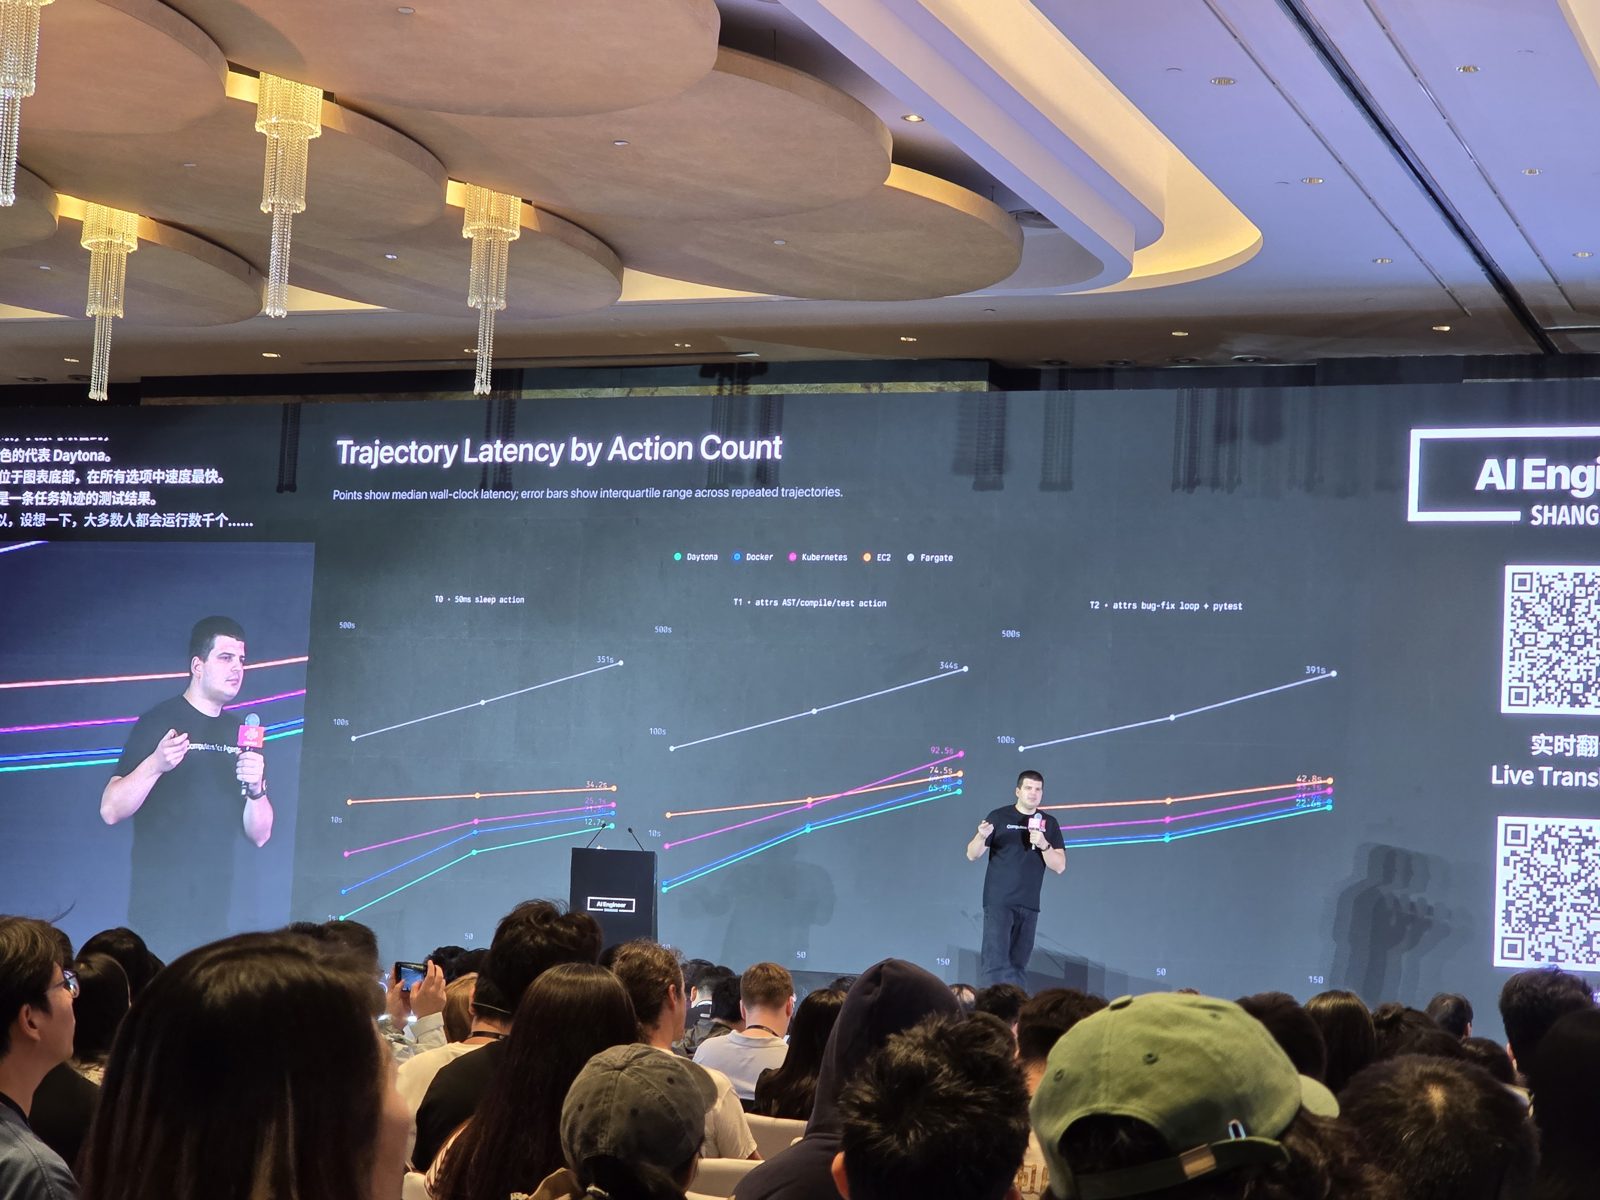
Daytona、Docker、Kubernetes、EC2 和 Fargate 依 action 数量的 trajectory latency,分成三个等级,从 50 ms 的 sleep action 到用 pytest 跑的 attrs bug 修复循环。
这个 benchmark 跑了三个等级的 agent trajectory:一个只做 50 ms sleep 的 sandbox、轻量的编译加测试,以及真正的 bug 修复循环。三个等级里 Daytona 的线都是最低的。Fargate 远远高出其他人,150 个 action 要 340 到 390 秒;在只有 sleep 的等级里,Daytona 是 12.7 s,Kubernetes 大约 25 s,EC2 大约 34 s。他还给了一个成本模型:1,000 个 sandbox 跑 176 小时,也就是一个月的朝九晚五,比自己管理的 Kubernetes cluster 便宜 2.7 倍,主要原因是 cluster 在两波尖峰之间都闲着。这些都是 Daytona 自己的数字。
Manus 的 AI-Native 工作方式:一个 monorepo,公开的任务 — Fan Bin (Manus AI)
Fan Bin 在 Manus 带 agent 工程,也负责它的 agent harness。他一开场引用了 Manus 共同创办人张涛一篇文章里的场景:PM 在 Slack 贴出一个需求,工程师把它一字不改地贴进一排 Codex 或 Manus session 中的一个,由它从头到尾把事情做完。他的主张是 agent 已经够强了,挡住它们的是信息和访问权限。一个任务的 context 散在私讯和每个人的脑袋里。工具则分散在将近 30 个 repository,加上测试环境、log、数据库和发布系统,每个都有自己的入口和权限。
第一个解法是 manus-mono:一个 workspace 里放了 28 个 repository、分层的 AGENTS.md 规则、39 个共用 skill、43 笔知识条目和 10 份 runbook,以及 22 个本机工具,让一个 agent 可以从写程序、测试、发布一路做到 debug 和数据分析。设置 mono 时也会一并接上 Slack 和 Notion。给 agent 一个 Slack 链接,它会读完讨论串,到 Notion 找规格,读现有的代码,把功能做出来,部署到测试环境,然后在同一个频道 @ PM 来试用。log 用 OpenTelemetry 做端到端的追踪,所以 agent 可以顺着一个 trace ID 找到对应的 repository、改动和作者,通常在 20 分钟内就能找到。遇到紧急事故时还有一个快速模式,五分钟内给出问题位置和建议的修法。
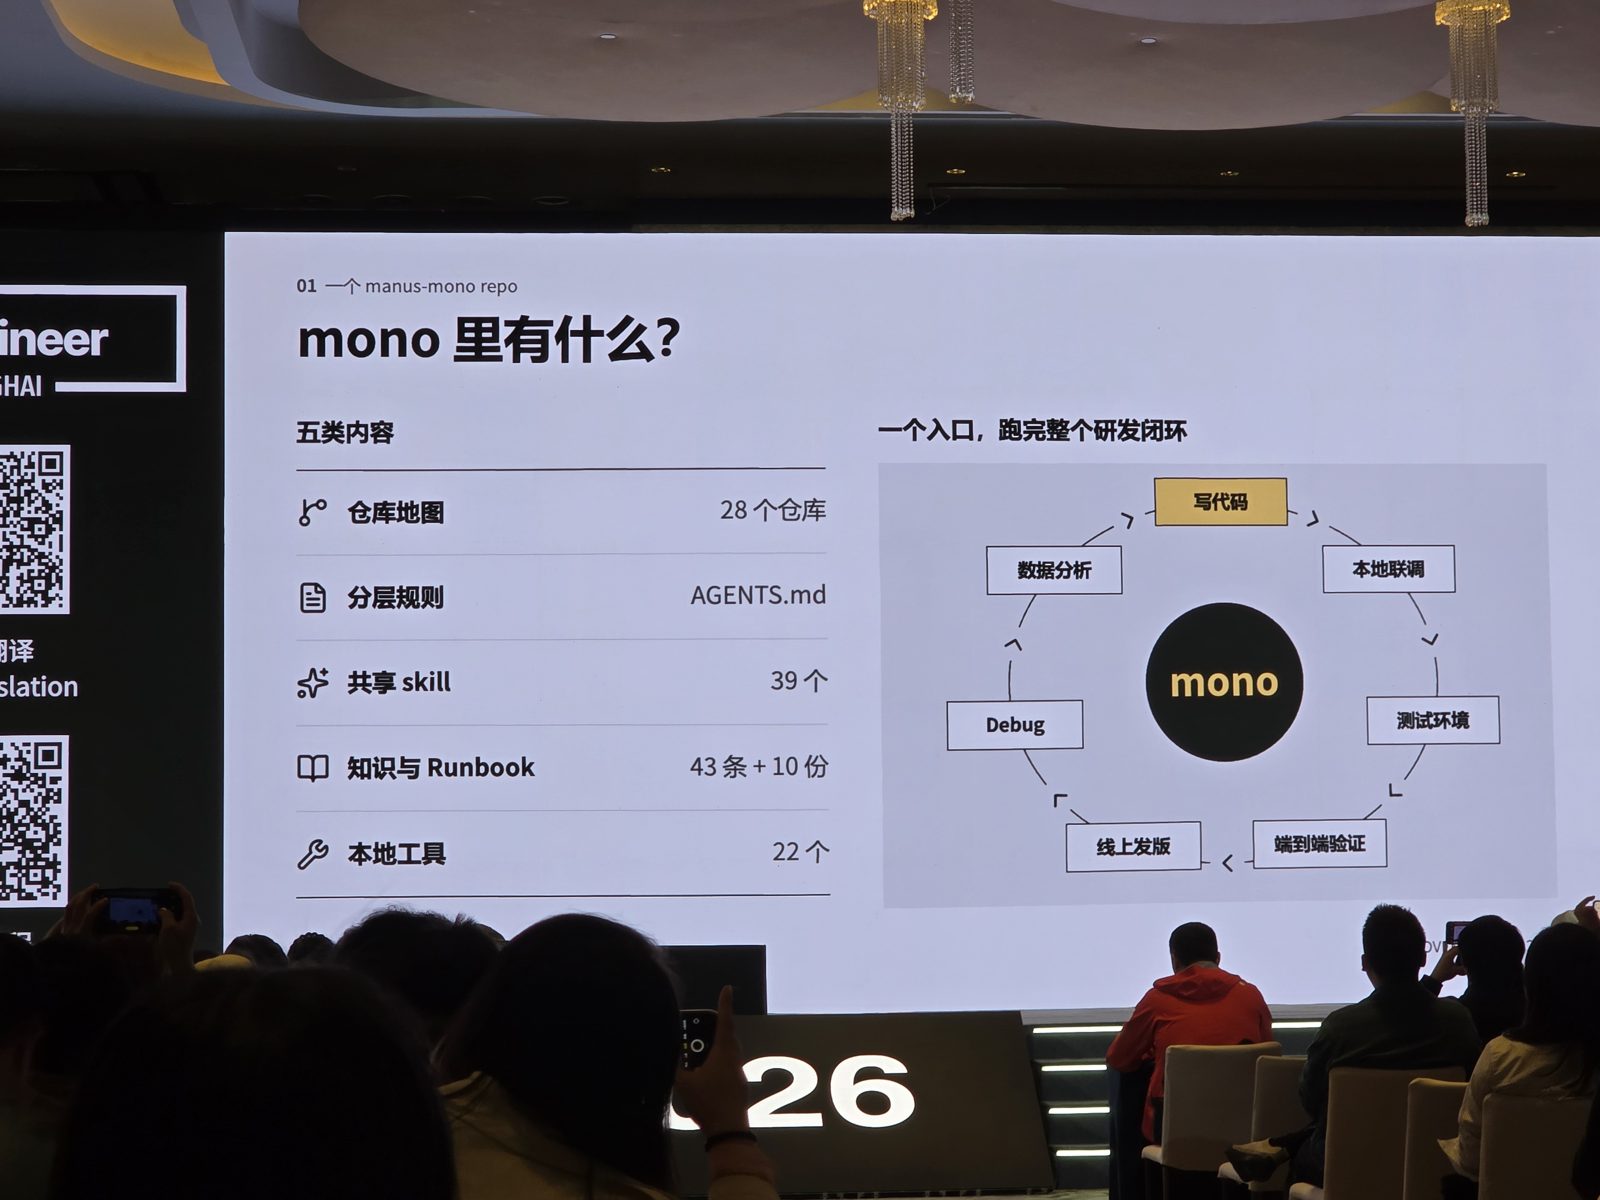
mono 里有什么:28 个 repository、AGENTS.md 规则、39 个共用 skill、43 笔知识条目加 10 份 runbook、22 个本机工具,以及一个入口涵盖从写程序到发布、debug 和数据分析的整个循环。
有了这个之后,工程部门以外的人也开始发 PR。从 2026 年 6 月起,三位 PM 和两位设计师送了 297 个 PR,其中 248 个(约 84%)被 merge。有一位 PM 让 Manus 测了十几个语音模型,用真正的前端代码做了 demo,最后上线了一个语音输入功能。品质靠的是 review bot 在每个 PR 上跑最强的模型,再加上动到付款、计费、模型和内核 prompt 的改动要由 owner 签核。他说到目前为止,还没有任何一次正式环境的事故是代码品质造成的。
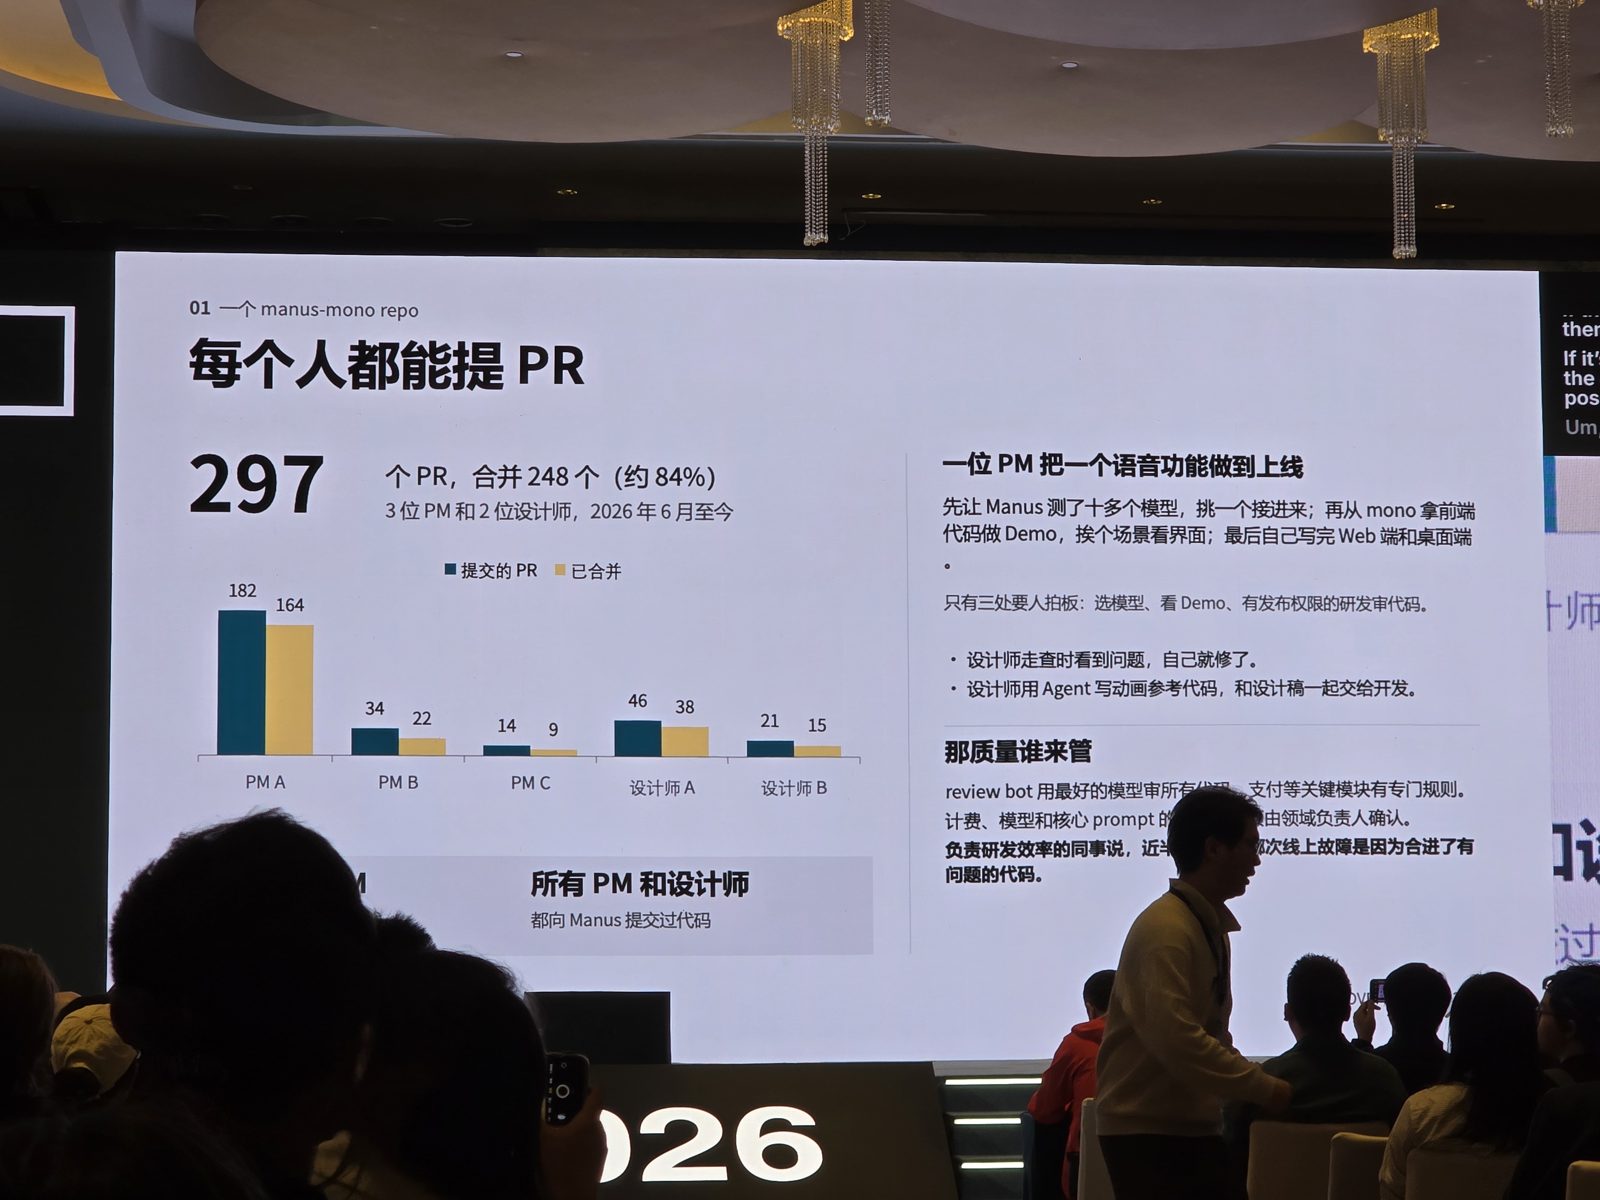
人人都能发 PR:3 位 PM 和 2 位设计师共 297 个 PR,248 个被 merge,附每个人的长条图(光 PM A 一个人就送了 182 个,merge 了 164 个)。
产品本身也是同样的切法:一个小小的 kernel,包含 agent loop、session 和基础工具;投视频、网页开发、视频剪辑这类 plugin 各自有自己的 repository,按自己的节奏发布。他给的理由是站在 agent 的角度:plugin 够内聚,每次改动需要跨 repository 的工作就少,出事的影响范围也小。每个模块由一到三个人负责,他说有时候感觉像在维护一个开源项目。
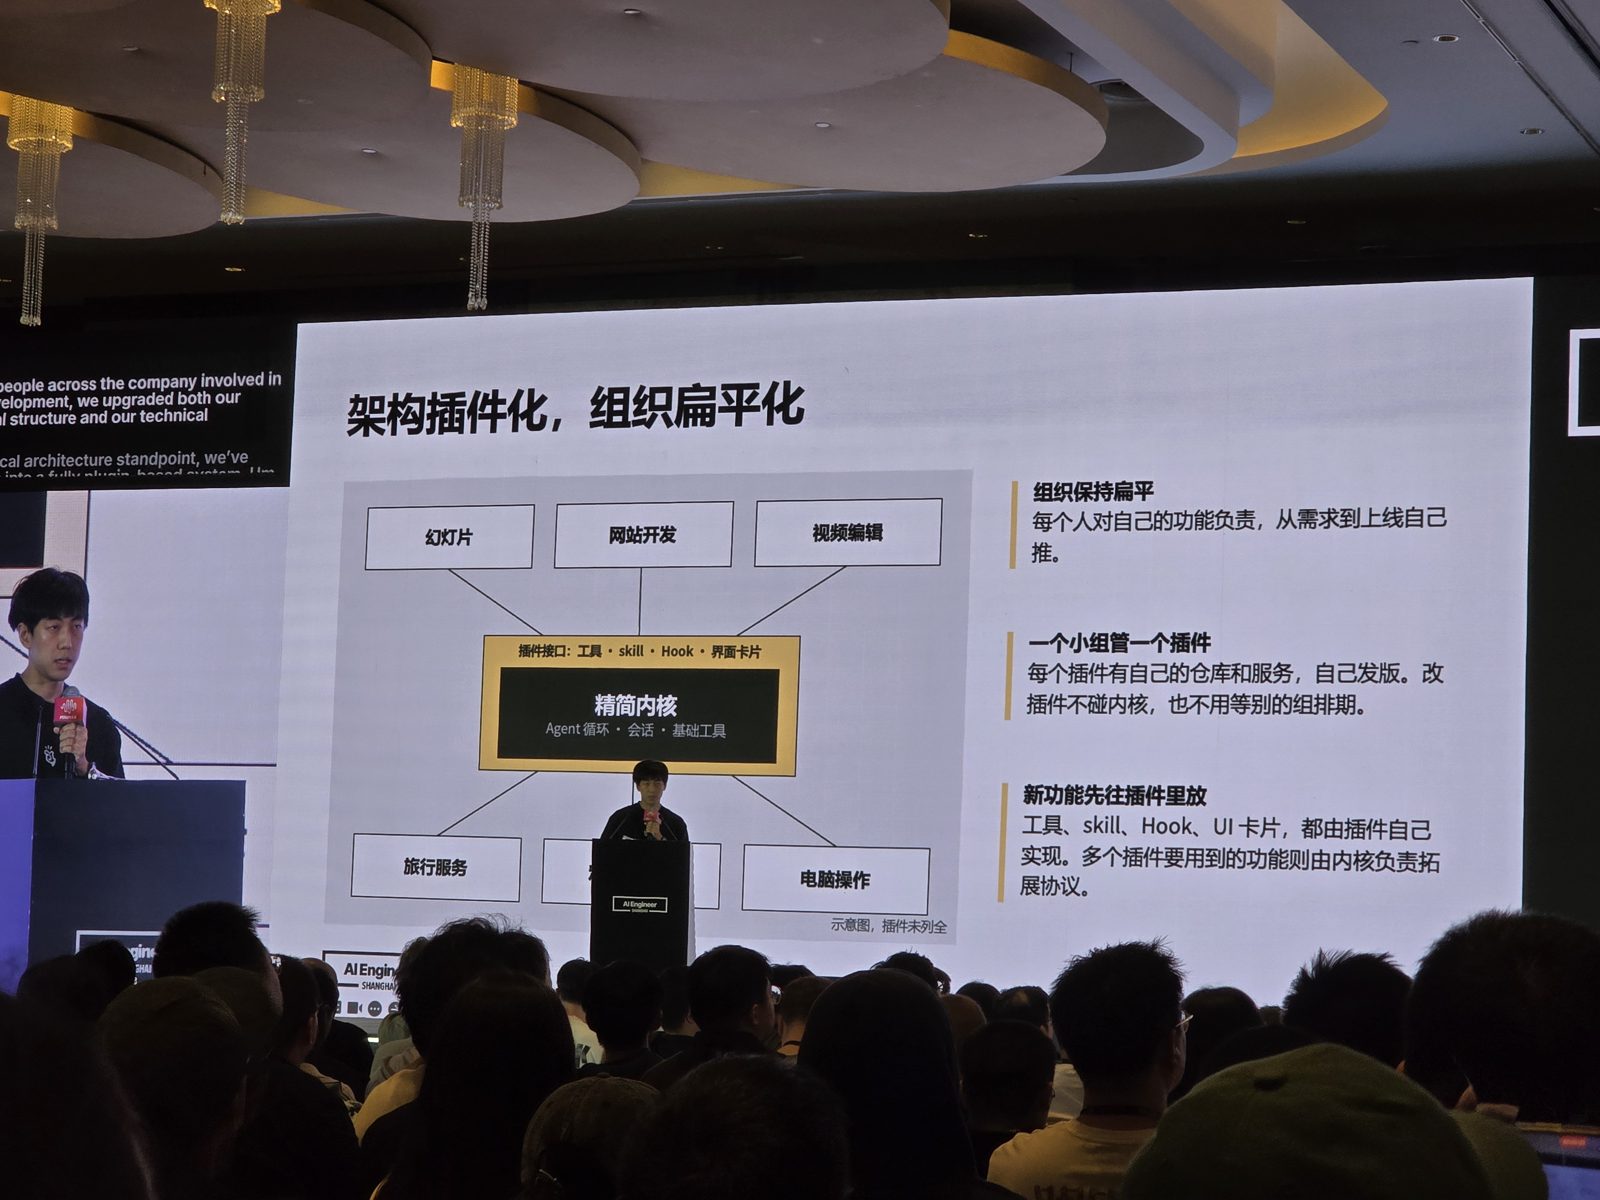
Plugin 架构:精简的 kernel(agent loop、session、基础工具)后面接一个统一接口,给 tool、skill、hook 和 UI 卡片用,plugin 各自独立发布。
第二个解法是所有任务都公开。起因是他们看不到同事怎么用 AI,也没办法帮那些用得不好的人。实际上,这让任务跟负责的人脱钩。如果一个任务卡在某个决定上,就把链接丢给能做决定的人,对方直接在任务里回答,agent 再接着做下去。PR 会连到它的任务,所以 reviewer 可以看到这个改动是怎么 prompt 出来的。他的总结是:mono 解决的是 agent 看不到完整的 context,公开任务解决的是人看不到。
再下一步是让 agent 自己行动。同事们已经把 agent 分身拉进了 Slack。其中一个会在每次发布前后比对 pod、重启次数和错误率,有一次还比他们的监控更早发现事故。一套受 loop engineering 启发的自动接单系统,会在 10 分钟内认领 issue,经过 coordinator、worker 和 review bot,最后交给人 merge。完成的任务从第一天的 13 个增加到第二天的 38 个。但这不是他的重点。bot 开 PR 的速度远远超过有人去 merge 的速度,几天内就有几十个 PR 摆着没人碰,也没有人知道它们的优先级。他说,没有人来设置优先级,自动化开发就只是在烧 token。
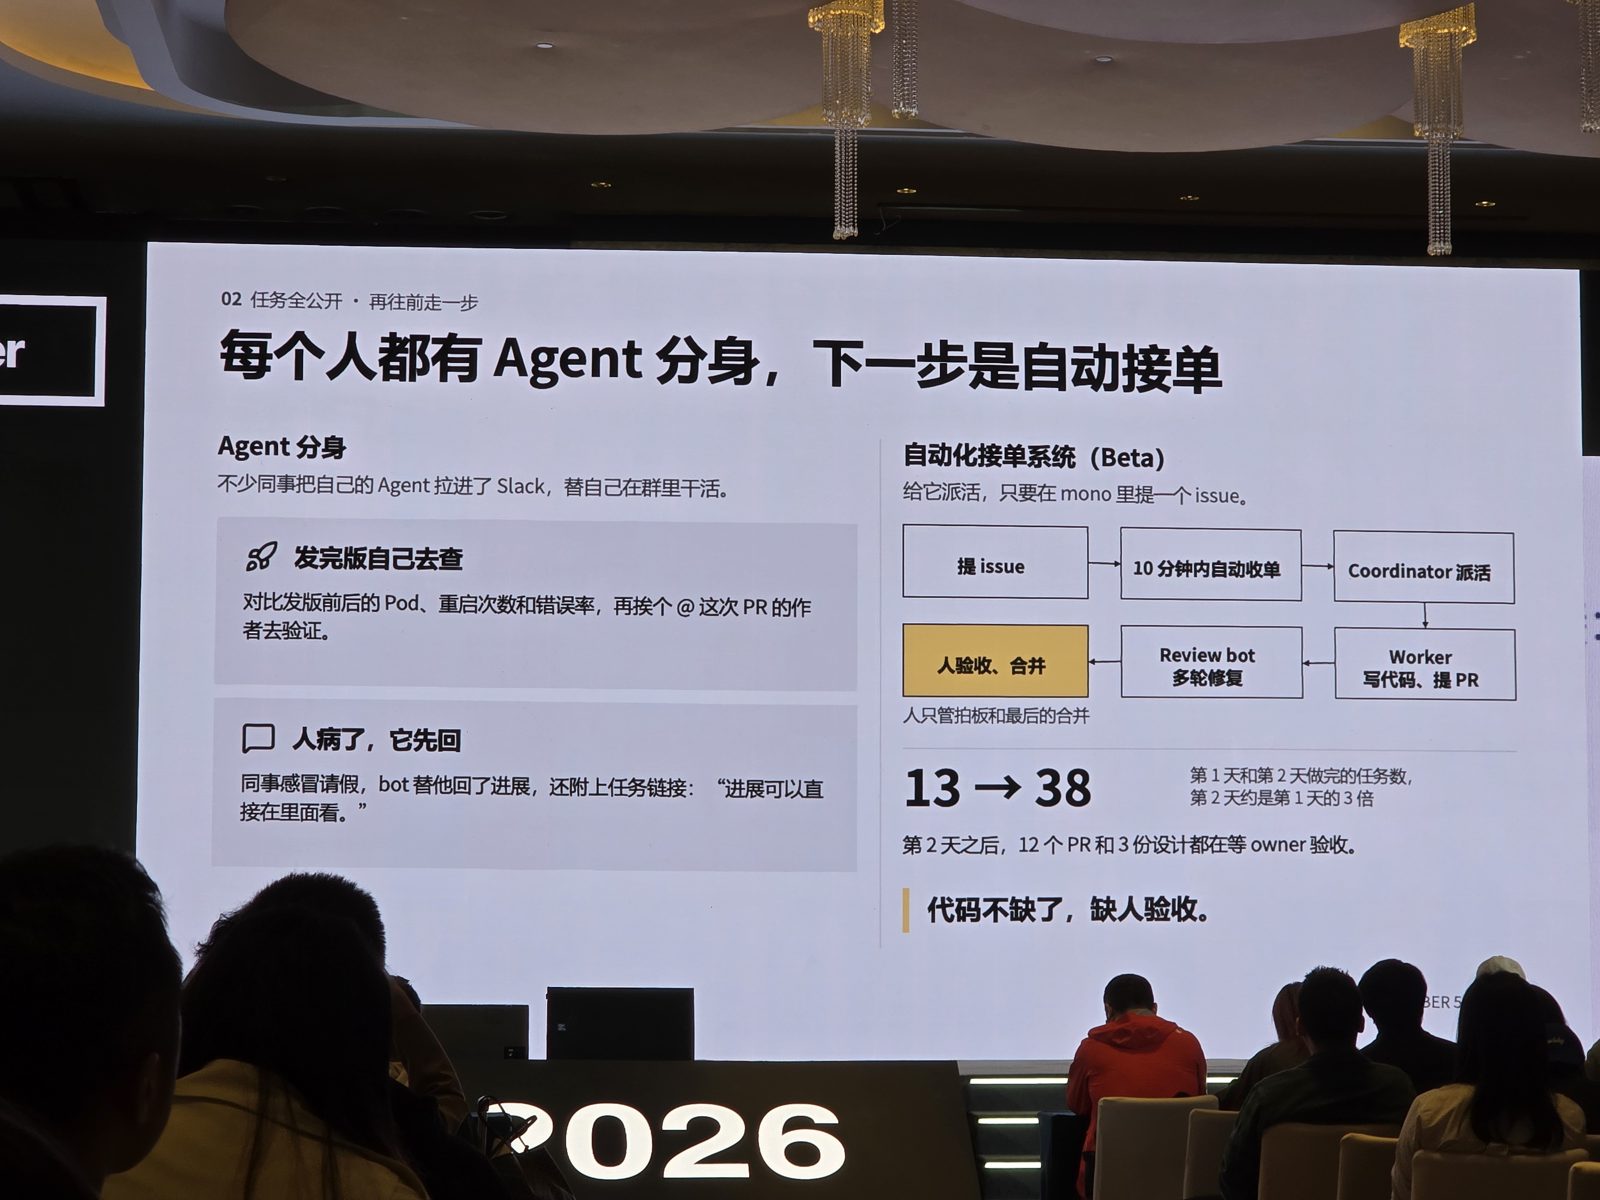
自动任务系统(beta):issue、10 分钟内接单、coordinator、worker、review bot、人工验收。第一天 13 个任务,第二天 38 个,第二天结束后有十二个 PR 和三份设计在等 owner。投视频最后一行:代码不再稀缺,稀缺的是验收。
踩坑的那张投视频列了:人又变回瓶颈、agent 做了一整天之后丢出来的核准请求没人看得懂,还有一位同事一个月花了 $100,000 的 token。最后这个他称为 autopilot:把任务丢出去,对什么都回“你说得对,继续”。解法是做好设计、拆分任务和分阶段检查,因为钱可以再赚回来,浪费掉的时间不行。讲到核准,他的说法是 token 可以再生,人的注意力不行。
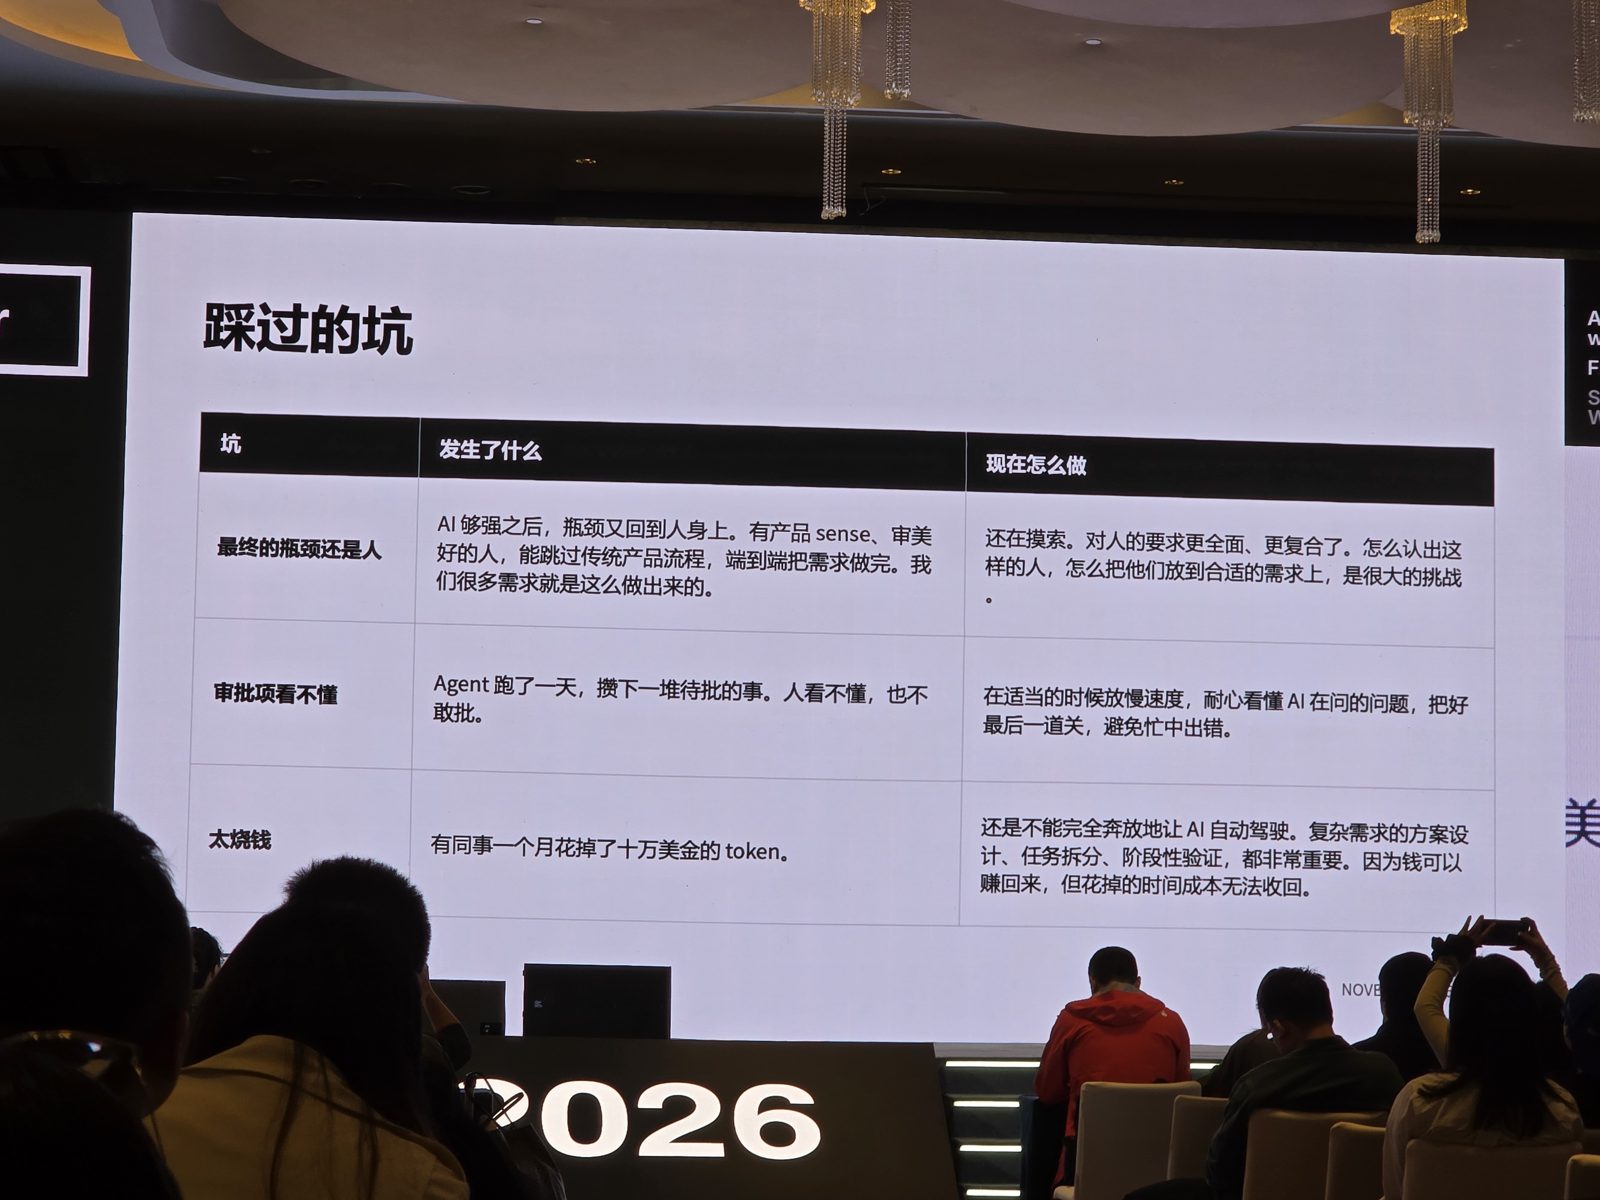
踩过的坑:人又成了瓶颈、堆积一堆没人看得懂的核准请求,还有一位同事一个月烧掉 $100k 的 token。
用 Exa search 驱动开源个人 agent — Jakub Hojsan (Exa)
Jakub Hojsan 在 Exa 带 forward-deployed engineering,整场就是一个 demo:一个用开源组件加上 Exa API 组起来的个人 agent,帮忙规划在上海的一个晚上。他的切入点是个人 agent 让多次请求之间有了连续性,也让主动提供协助变得可能:“一个能接着我们上次停下的地方继续、并帮忙处理接下来的事的 agent”。
这个 agent 在外滩找到一间餐厅,先从 Exa 的图片结果抓照片,再通过浏览器从店家网站抓,然后依照气氛、景观和每人预算缩小选项。他展示了他们怎么把整个网页挡在 prompt 外面。Exa 的 highlights 功能可以只回传跟查找相关的段落,直接从网页截取、不改写。如果这些段落够用,agent 就直接回答;如果用户想看照片或缺了某个细节,才升级到别的工具。他也列了 Exa 除了网页之外还索引了什么:大约 15 分钟内的新闻、公开申报文档、podcast、活动、地点和天气。天气在 demo 里真的派上用场。他问晚餐后要不要去外滩散步,agent 说不要,因为预报会下雨。
记忆的部分,偏好是按“人”存,而不是按“用户”存。demo 里他朋友不吃辣,他自己超爱辣椒,所以“我朋友偏好比较不辣的食物”是记在朋友身上。主动协助的例子是 Jazz at Lincoln Center Shanghai 寄来一封 email,有两个位子。agent 只有在三个条件都成立时才会打扰他:他的行事历有空、价格在他的票券预算内、而且真的有两个位子。底层要嘛是 Exa 的 Monitors 产品,要嘛就是单纯的定期搜索加上 browser use,他说那些闭源的供应商其实也都是这样做。
他的建议是从一个重复性的任务开始,再决定 agent 该记住什么、该查什么,以及聊天结束后有哪些东西要留下来。
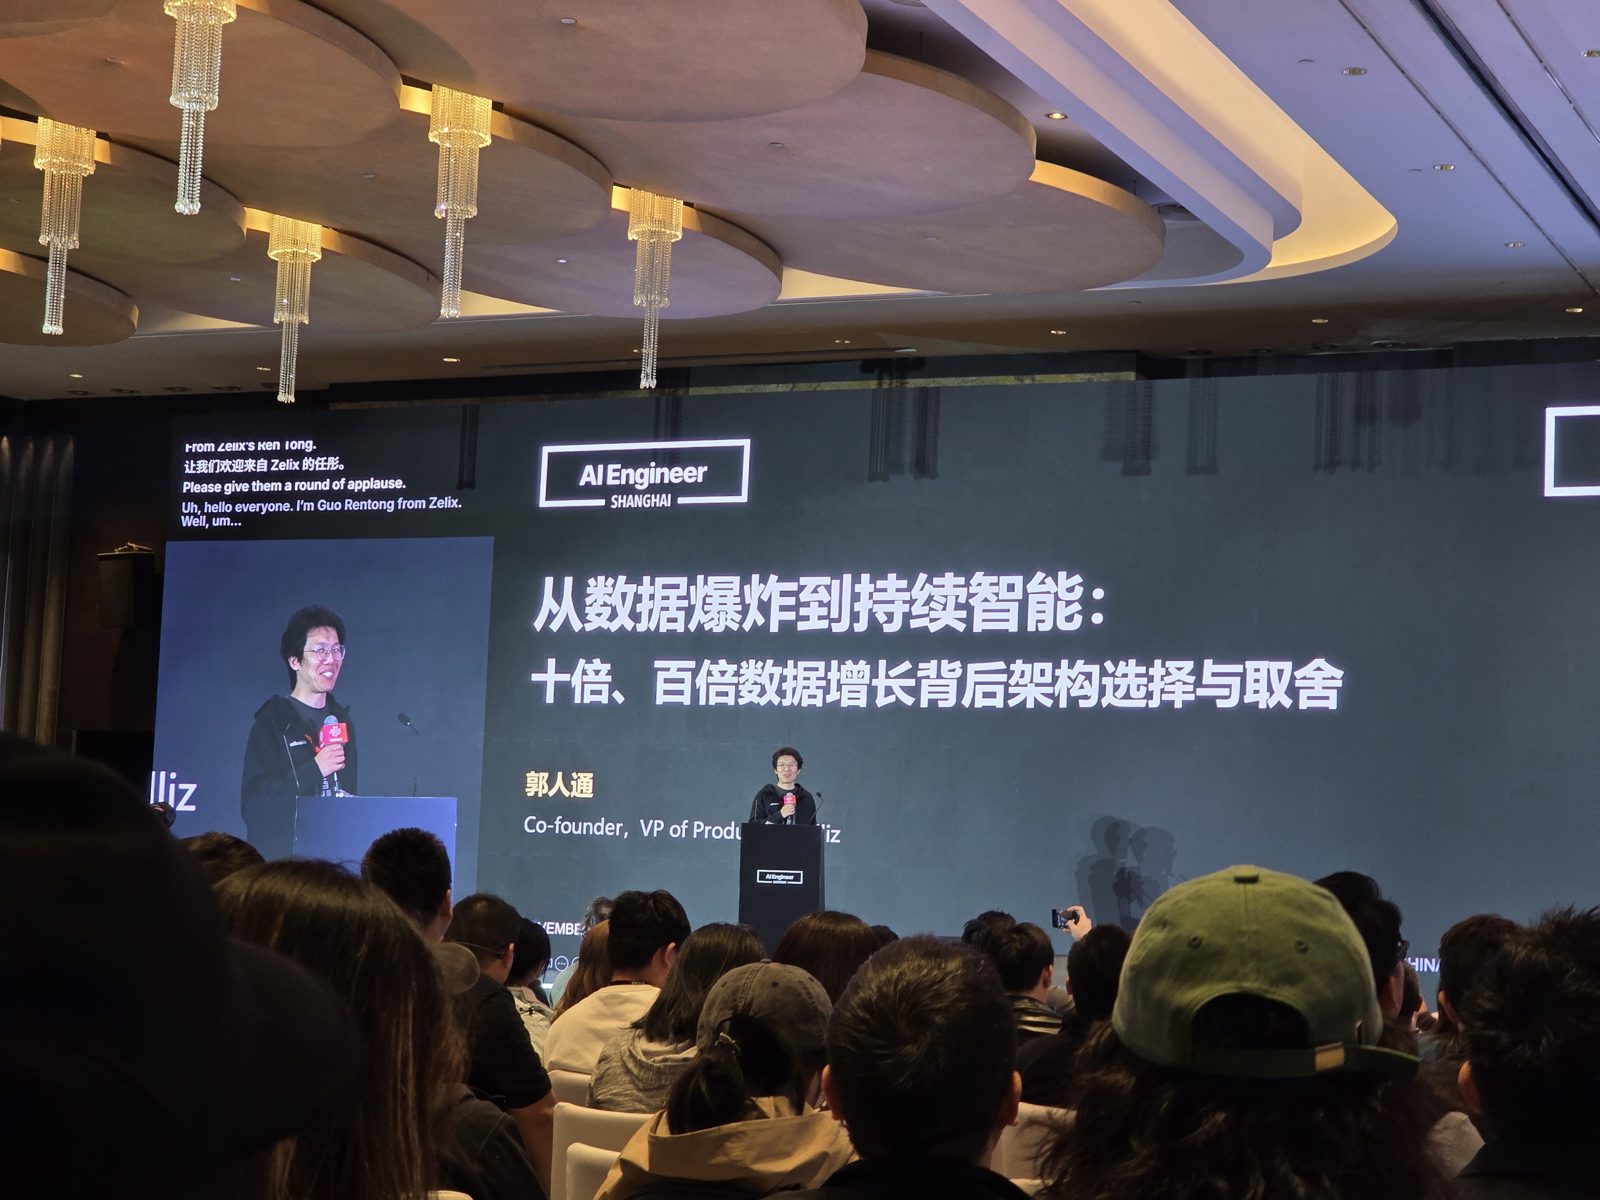
Jakub 那场结束后的交接:Zilliz 的 Rentong Guo 上台,标题投视频讲的是在 10 倍和 100 倍数据成长下的架构选择。Exa 的投视频我没拍到能用的照片。
你的 agent 的记忆就是下一季的训练数据 — Rentong Guo (Zilliz)
Rentong Guo 是 Zilliz 的共同创办人,Zilliz 就是做 Milvus 矢量数据库的公司。摘要写的是 agent trace 怎么变成训练数据,但实际内容大多在讲另一件事:为什么 Zilliz 把 Milvus 围绕对象保存重新设计,现在称为“Vector Lakebase”。agent 和训练只在最后几分钟提到。
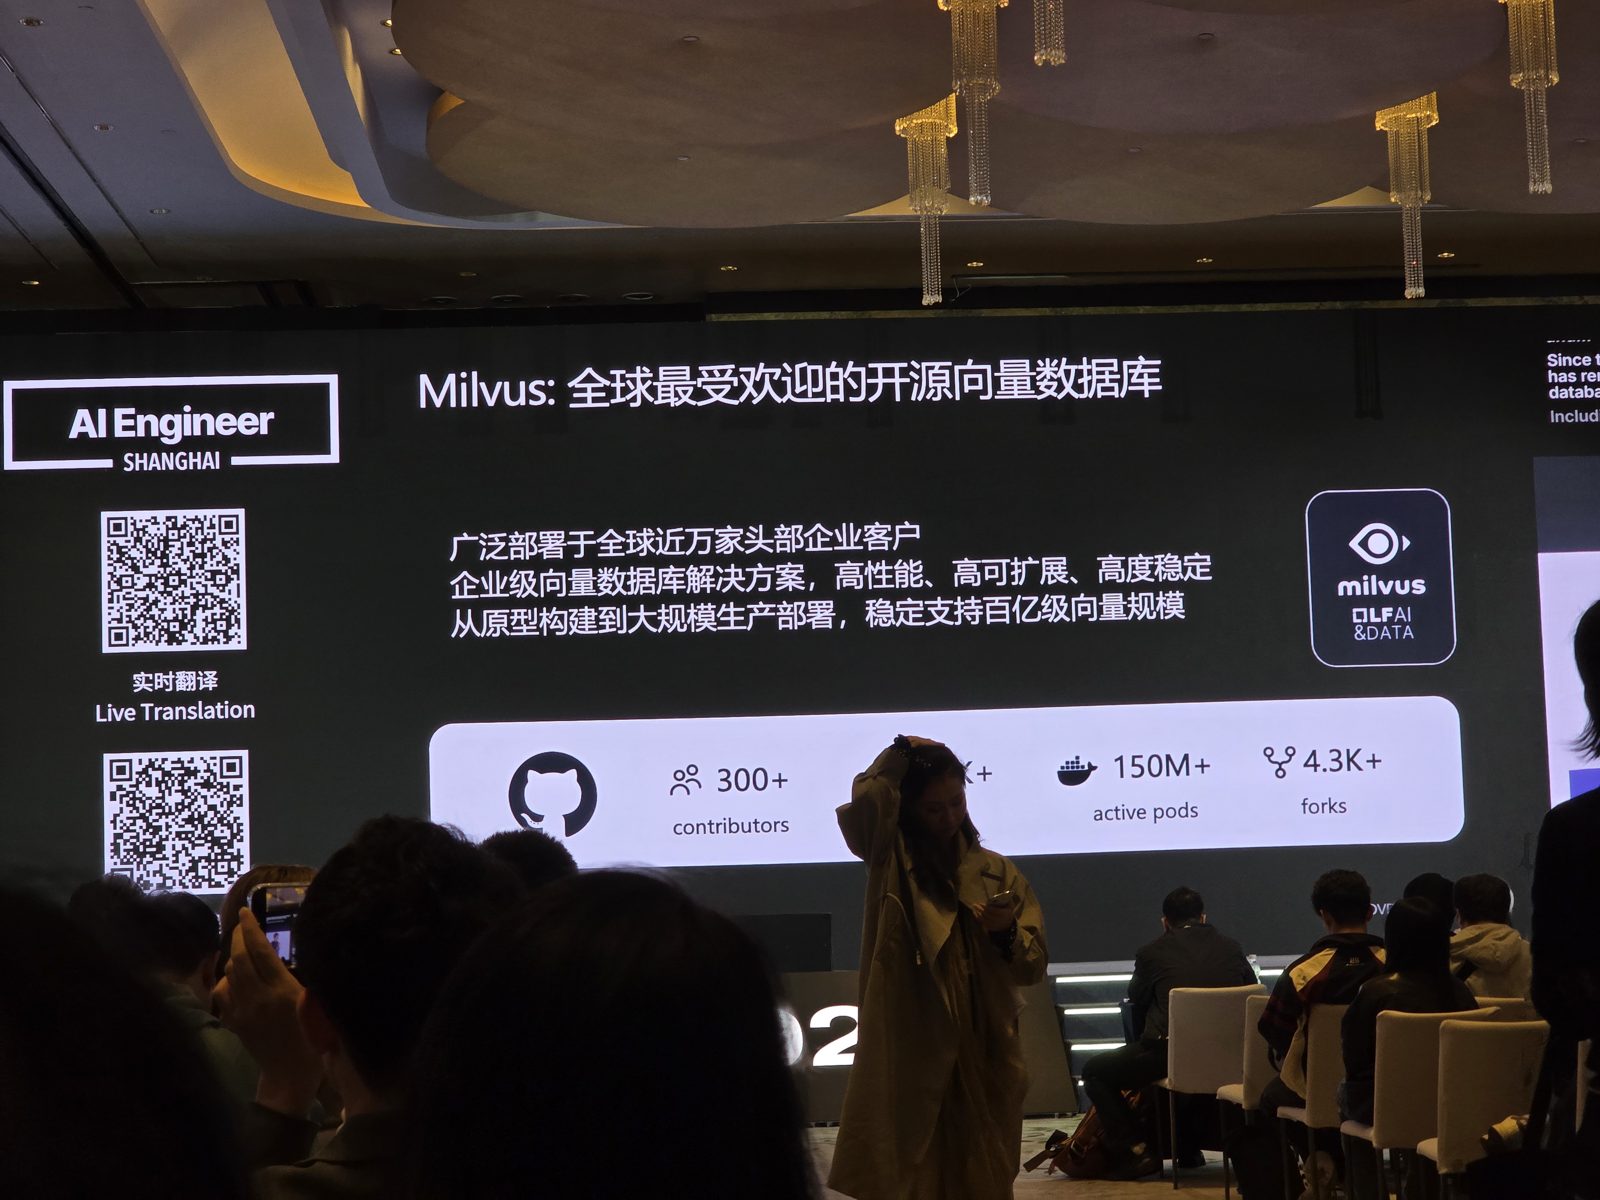
Milvus 介绍投视频:部署在将近 10,000 家企业、300+ 位贡献者、Docker 计数 150M+、4.3K+ fork。
他从两条成长曲线讲起。同一个任务消耗的 token,从文本补全、聊天、推理到 agent,每往前一步大约多十倍。第二条曲线是 Zilliz 自己观察到的:他们某个客户背后最大的单一业务,2023 年有几亿笔数据,2024 年几十亿,2025 年几百亿,今年大约一千亿。这是单一 workload,不是总量。他预期 2027 和 2028 年会成长得更快,因为会有更多数据是生成或仿真出来的(world model、自动驾驶、AI 做的短剧),所以会跟着算力支出一起成长。
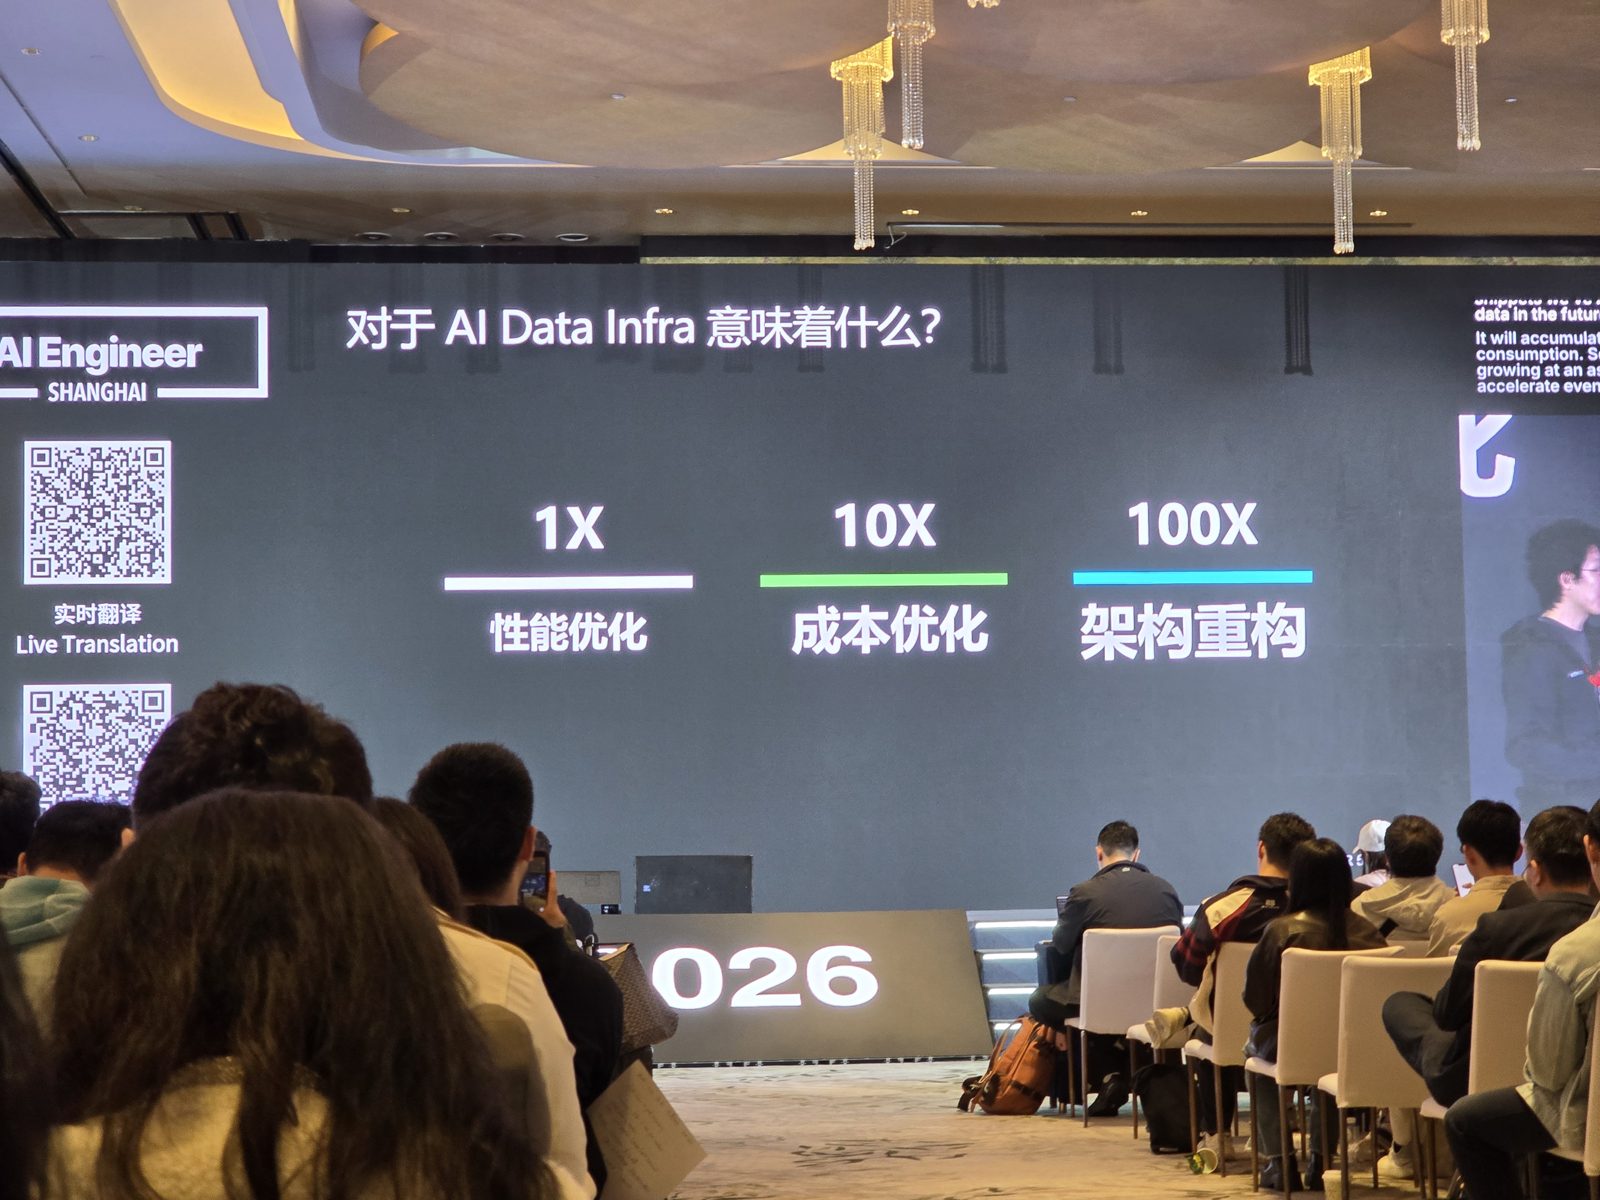
1X / 10X / 100X 投视频:先做性能调校,再做成本调校,最后重新设计架构。
他的框架是 1x、10x、100x。性能调校让你撑过第一步,成本调校撑过第二步:性能型和容量型 instance 的选择、算法上的改进、同一台服务器里 DRAM 和 NVMe 的搭配。他说过了 100x,服务器里已经没有空间可以挤了,只能重新设计架构。
为了解释原因,他用了一个啤酒馆的比喻。工程师就像服务生,端着一叠越来越高、装满啤酒的杯子(服务器),旁边有人一直往里面倒更多啤酒(数据),而且一滴都不能洒出来。在正式环境里,洒出来就是一级事故。他的投视频列了 OOM、在高水位时扩容、resharding、数据 rebalance 风暴,以及故障的影响范围。他还提到一家知名的 AI coding 公司,根据他看过的一场演讲,那家公司在 2024 到 25 年的爆发成长期,几个月内换了四次数据库,最后是改用以对象保存为基础的设计才稳定下来。
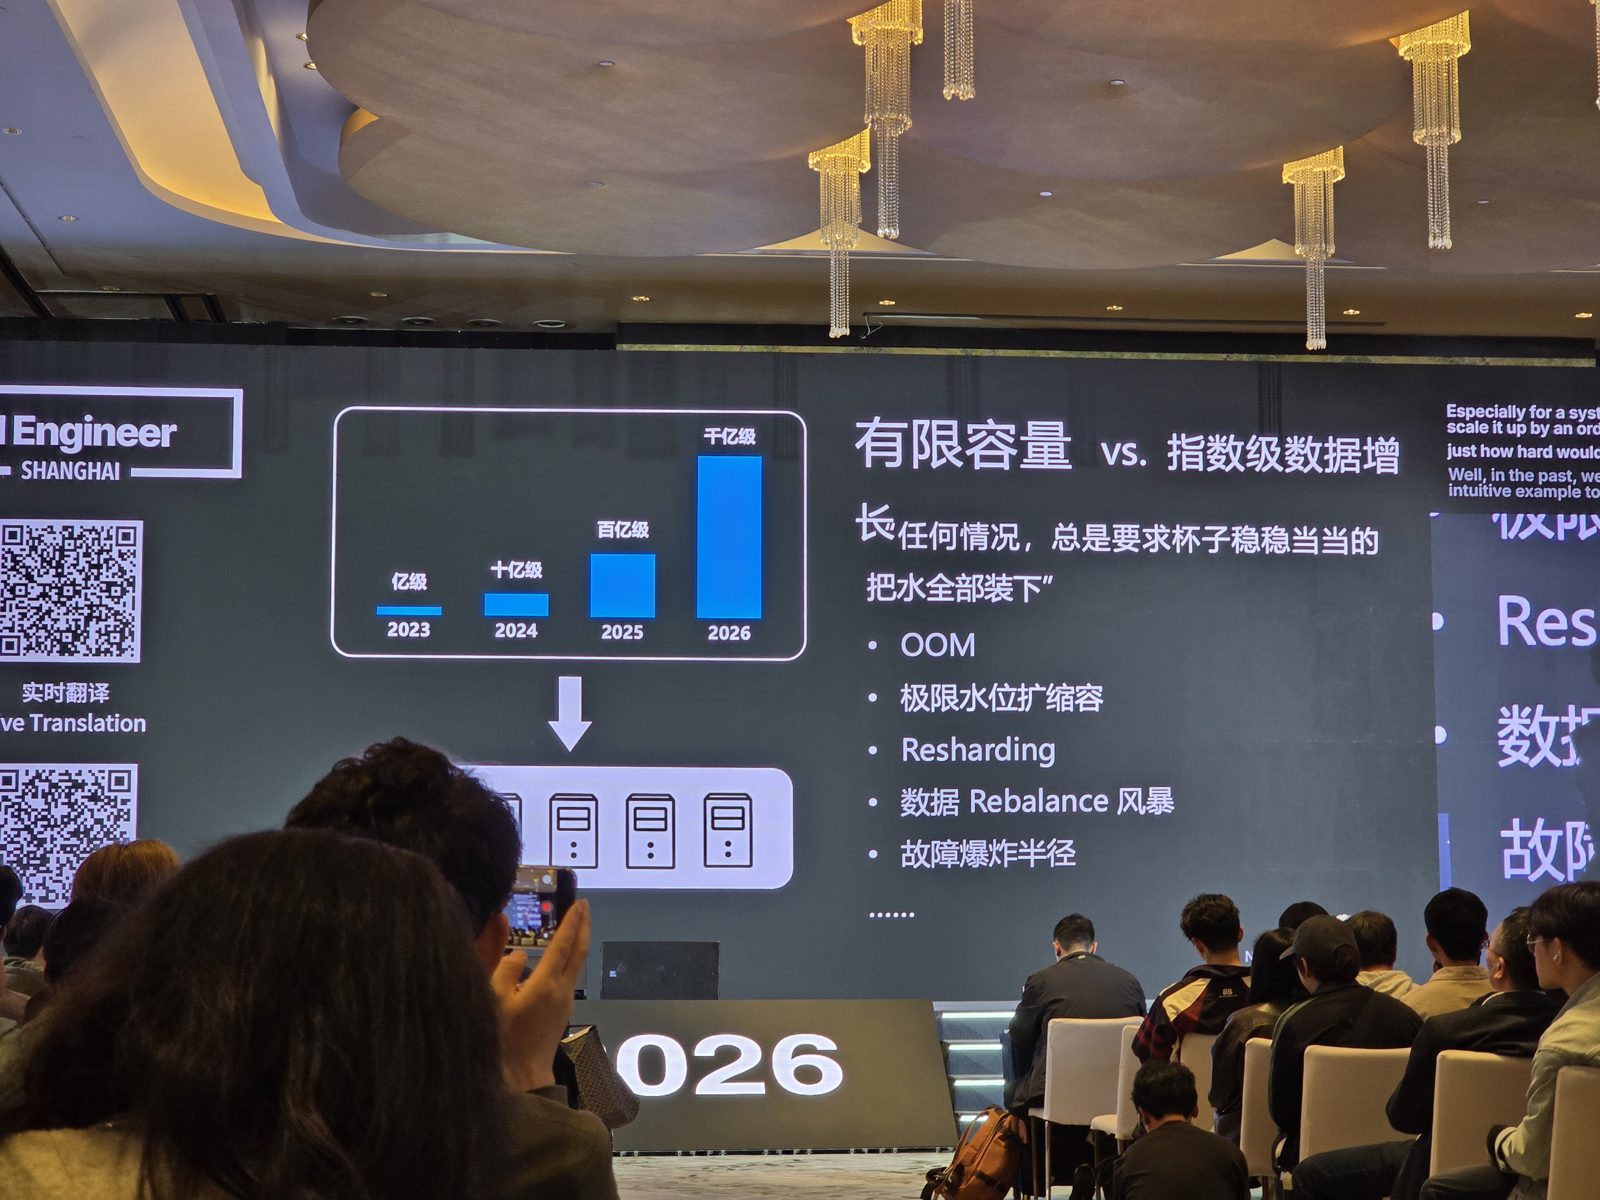
有限的容量对上指数成长的数据:2023 到 2026 年最大单一 workload 的数据笔数,以及固定大小 cluster 的各种故障模式。
他对 Lakebase 的定义是:数据库的使用体验、大致相当于数据库的性能,加上数据湖的容量和成本。底层分三层:查找服务器上的本机缓存、服务器和对象保存之间的远程缓存,以及 S3。投视频上的价格大约是每 GB 每月 $3、$0.3 和 $0.03。每一层都能回应查找,所以问题就变成数据要放在哪一层。他举的 agent 应用例子是:所有注册用户放在对象保存,周活跃用户(8–30%)放中间层,日活跃用户(3–15%)放本机缓存。当一个沉寂的用户登录时,应用程序会通知数据层把这个用户的数据往上提,这只要几秒,所以通常第一次查找时数据就已经是热的。
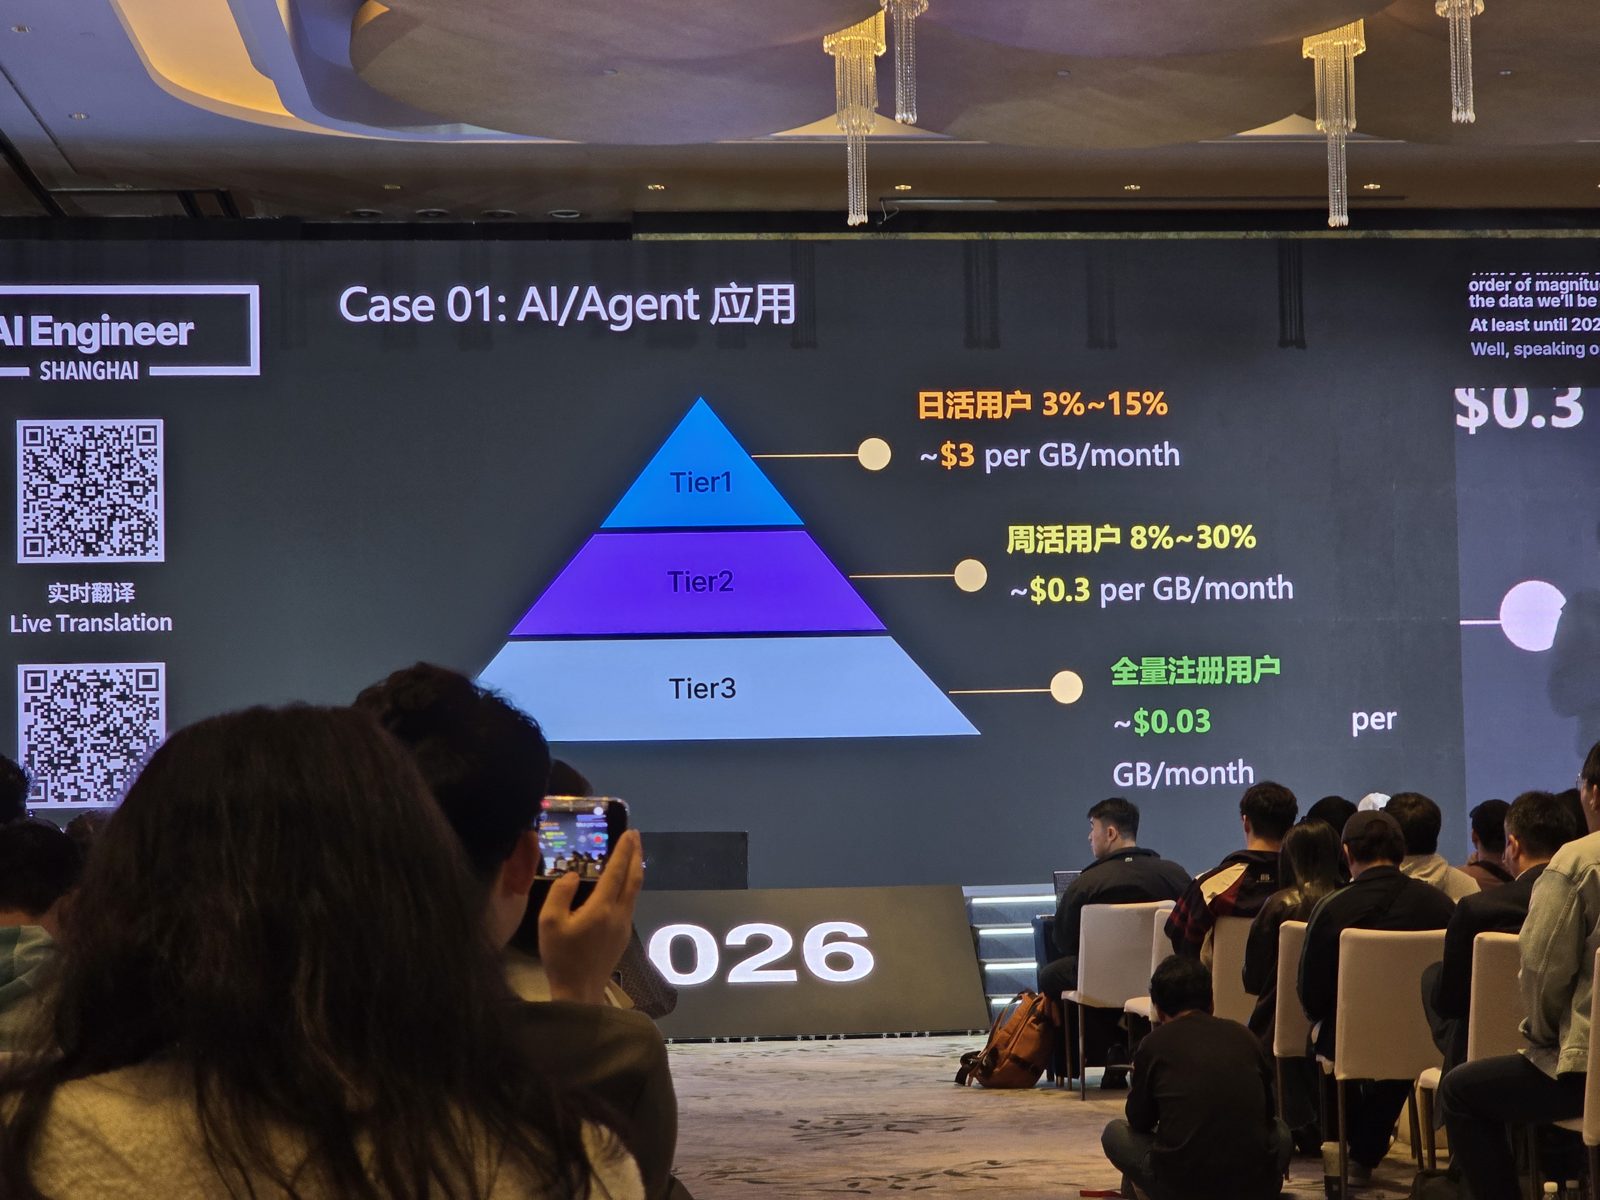
Case 01,一个 AI/agent 应用:日活跃用户放 Tier 1,约 $3/GB-月;周活跃用户放 Tier 2,约 $0.3;所有注册用户放 Tier 3,约 $0.03。
训练数据的部分出现在后面一张画成循环的投视频上。agent 从保存层读数据做即时检索,它的行为、回馈和笔记写回同一个 bucket,再对这些数据做交互式探索和批量分析,喂给下一轮的训练数据和 agent 策略。
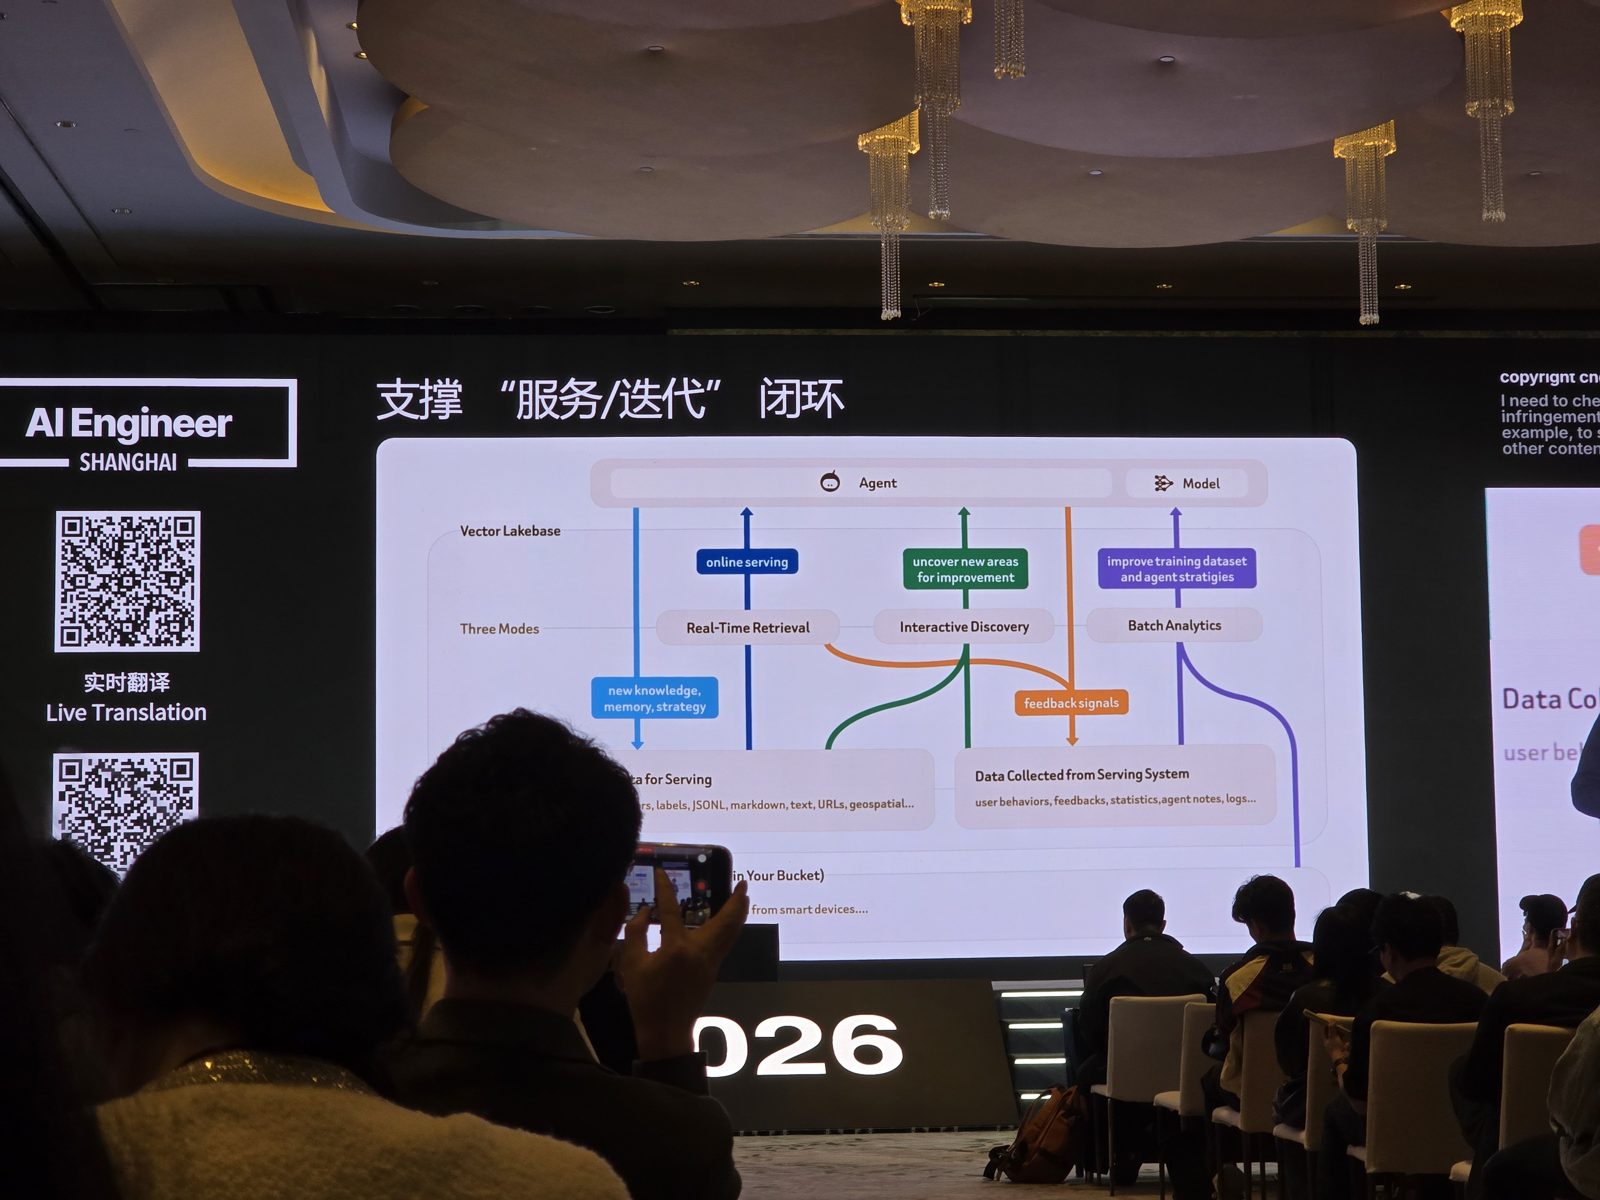
服务与迭代循环:agent 从 Vector Lakebase 读数据做即时检索,它的行为、回馈和笔记回到同一个 bucket,交互式探索和批量分析再产出新的知识、训练数据和 agent 策略。
至于 Lakebase 之后的下一步,他提到要像 LLM serving 缓存 KV state 那样缓存查找结果,让重复的多轮查找不用再算一次。
建构可靠的多区域 LLM gateway — Xinghong Fang (Optiver)
Xinghong Fang 是 Optiver 的 AI 工程师,Optiver 的开发者、研究员和业务人员发出的每一个模型调用,都会经过他们团队的 gateway。他给的规模是:每天大约 300 万个请求,分布在四个数据中心,约 22 个模型承载了 95% 的流量,还有好几家 provider,各自讲自己的协定。上游 provider 大约有 0.4% 的请求会失败。在这种量级下,这代表很多坏掉的 session。
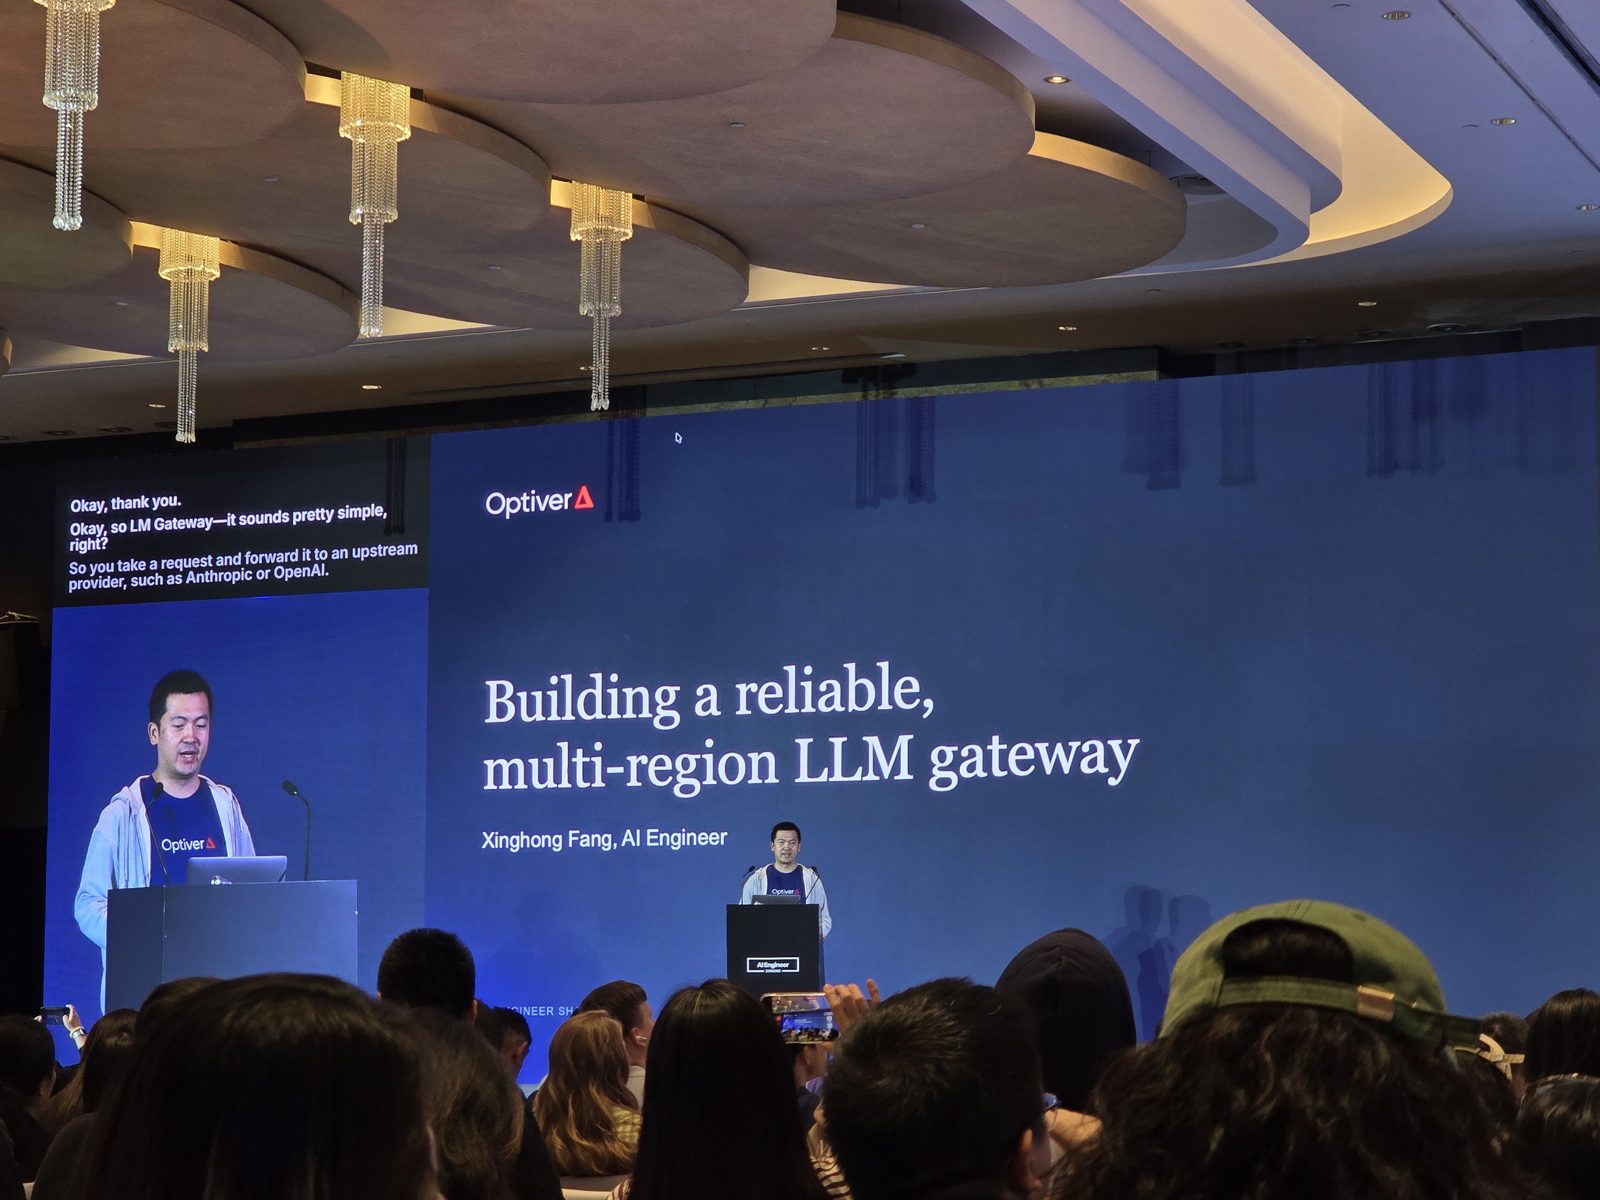
标题投视频,侧边屏幕的即时字幕抓到他的开场白:LLM gateway 听起来很简单,就是接一个请求,转给 Anthropic 或 OpenAI 这类上游 provider。
他们一开始用的是一套开源 gateway(他没说是哪一套),负责在各家 provider 的协定之间转换。一直用得好好的,直到 Slack 消息开始出现:“gateway 是不是变慢了?”,然后 +1 一路冲到 30 甚至 100。他的重点是,gateway 现在是基础设施,服务一挂,用户会比你的监控更早发现。第一个教训是 HTTP 200 不代表成功。串流会卡在一半,而协定转换会让 prompt caching 失效,这很要紧,因为缓存的输入成本大约只有十分之一。最麻烦的状况是无声无息的那种。通过 OpenAI 兼容协定调用 Anthropic 模型时,回应里的 thinking block 被丢掉了。用户还是拿到答案,但下一轮得重新思考一次,所以 latency 和成本都上升,监控上却什么都看不到。最后是一位用户发现的。
每个重要模型至少有两家 provider。只有在用户还没看到任何输出时才 failover,例如遇到 429 或 529。一旦串流已经开始,就直接把错误丢出来,让用户自己重试。他知道有些 gateway 可以把串流接到第二家 provider 继续,但他们判断不值得那个复杂度。circuit breaker 依不同错误设门槛,会把某家 provider 暂时拿掉。session 是 sticky 的,所以一段对话永远留在同一家 provider 和它的缓存上,而且在共用的 model ID 底下只开放两家 provider 都支持的功能。另外因为“备援总是在你需要的时候坏掉”,固定有 10% 的 session 会送到次要 provider。
多区域的故事让台下不少人露出心照不宣的笑。他们想要一把在每个区域都能用的 API key,所以认证放在一个中央的 PostgreSQL。法遵要求记录每一个 prompt 和回应,而 gateway 把这些也存在同一个 Postgres。结果就是每天有超过 200 GB 的数据横跨大西洋,每次调用还多了大约两秒的认证 overhead。解法是各区域直接把内容 log 写到 S3,认证改从本地 replica 做,接受权限变更会延迟几秒生效。这让 overhead 降了很多。花费上限是 eventually consistent,所以超出上限几分钟是可以接受的。
就算做了这么多,用户还是说很慢。其中一个抱怨靠 distributed tracing 找到答案:推论花了 17 秒,这没问题,但一次 tool call 就花了三分多钟。最后 Optiver 围绕自己真正用到的那一小组功能,自己写了一套 gateway。他说这不适合每个人,如果开源方案合用,他们会回去用。
没人规划过的 AI Infra:AI builder 如何把数据库推到数据库之外 — Lux Li (TiDB / PingCAP)
Lux Li 负责 TiDB 的 AI 业务,整场就是一个长故事,起点是 agent 公司天天会听到的一种需求:“把这些数据做成审阅工作台,团队明天要用,之后我们还会一直改。”他的重点是,这一句话其实默认了工作成果要活得比 agent、比 sandbox、比这一天都久。每次撑不住,就有 TiDB 的客户提出新需求,产品线就是这样长出来的。
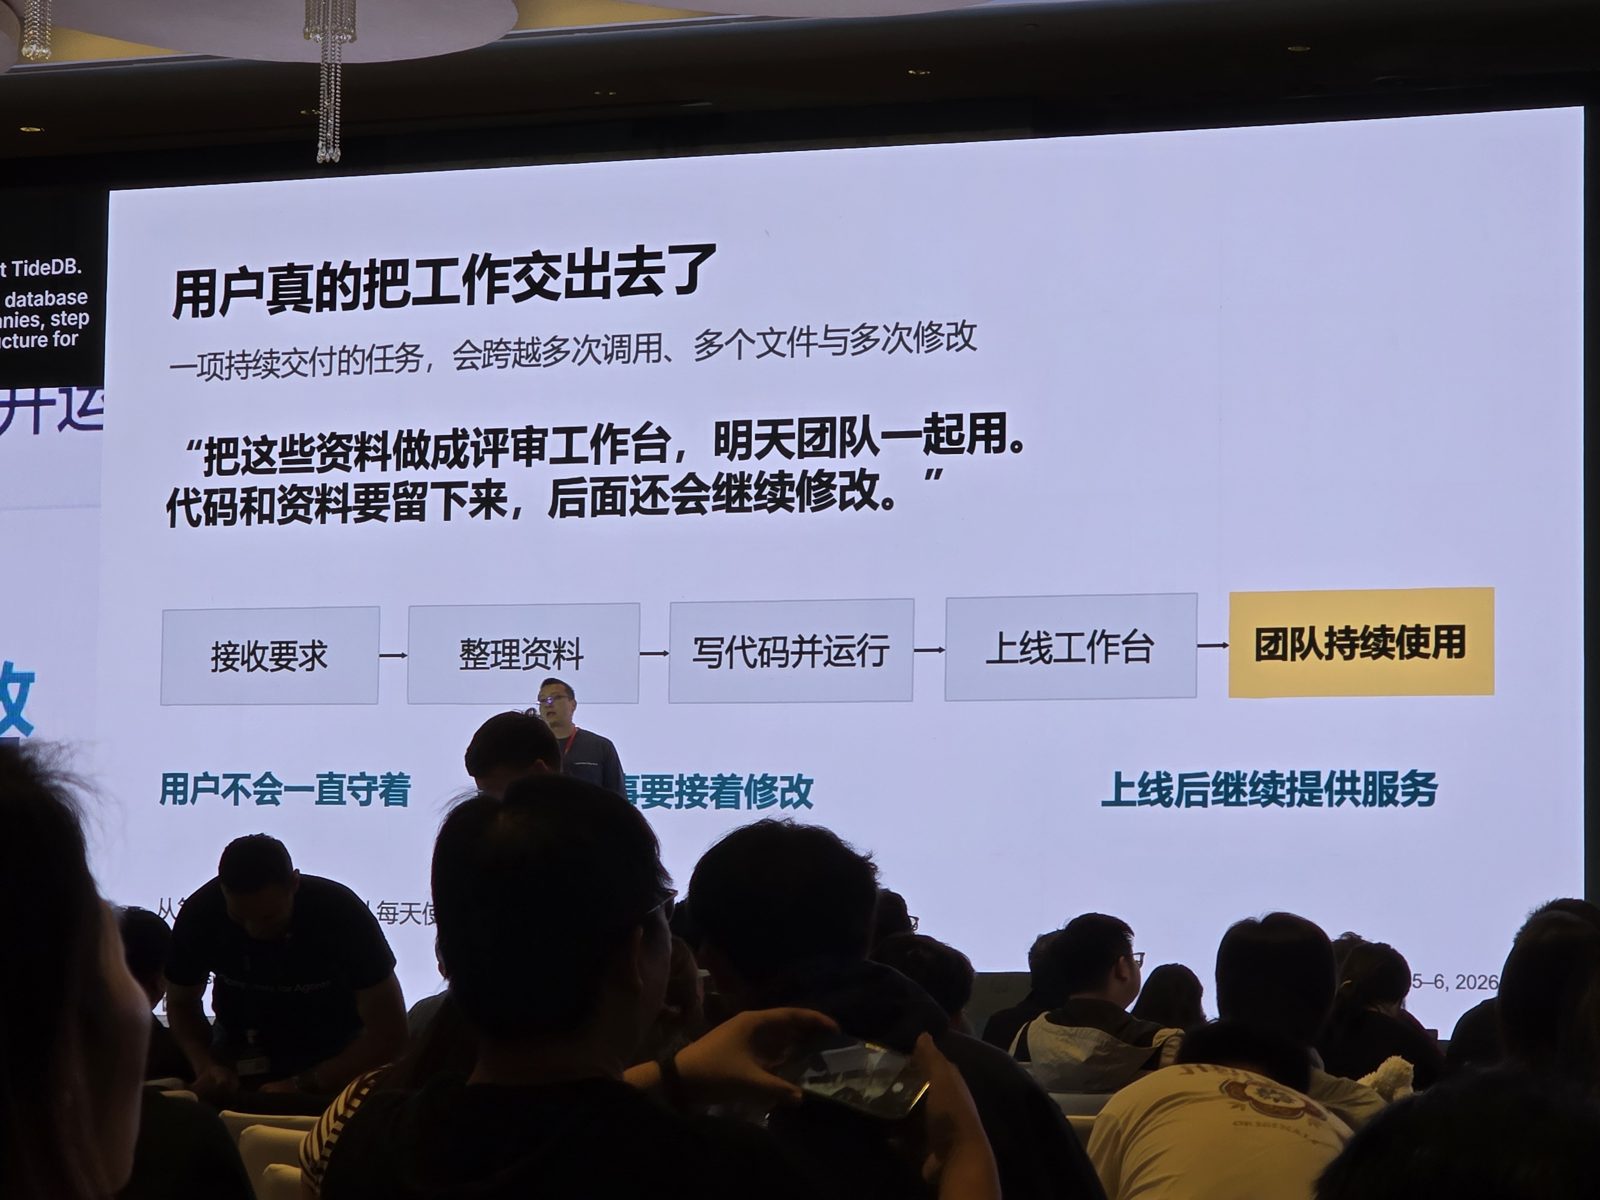
整场演讲的出发点:把这些数据做成团队明天要用的审阅工作台,代码和数据都要留着,之后还会一直改。流程从接到需求、写程序、运行,一路到工作台上线、团队持续使用。
第一种失败是 agent 被中断。为了能接续,平台要维护两张表:一张是 agent session snapshot(context、plan、tool call 历史,每份 snapshot 40 到 80 MB 很正常),另一张是 agent session event log,每一列用独立的 transaction 写入。他说整个 fleet 加起来,这些 metadata 会到几百 TB,有时到 PB 等级。有个客户原本把它拆在 20 多个分库上,后来为了不再维护 shard routing 才搬到 TiDB。
第二种失败出在 sandbox。agent 在 EBS volume 上写程序,任务结束后,回收策略把 volume 连同用户的项目一起删掉。对 volume 做 snapshot 理论上可以解决,但他的投视频列出了平台接着得自己扛下的整条备份与还原流程。
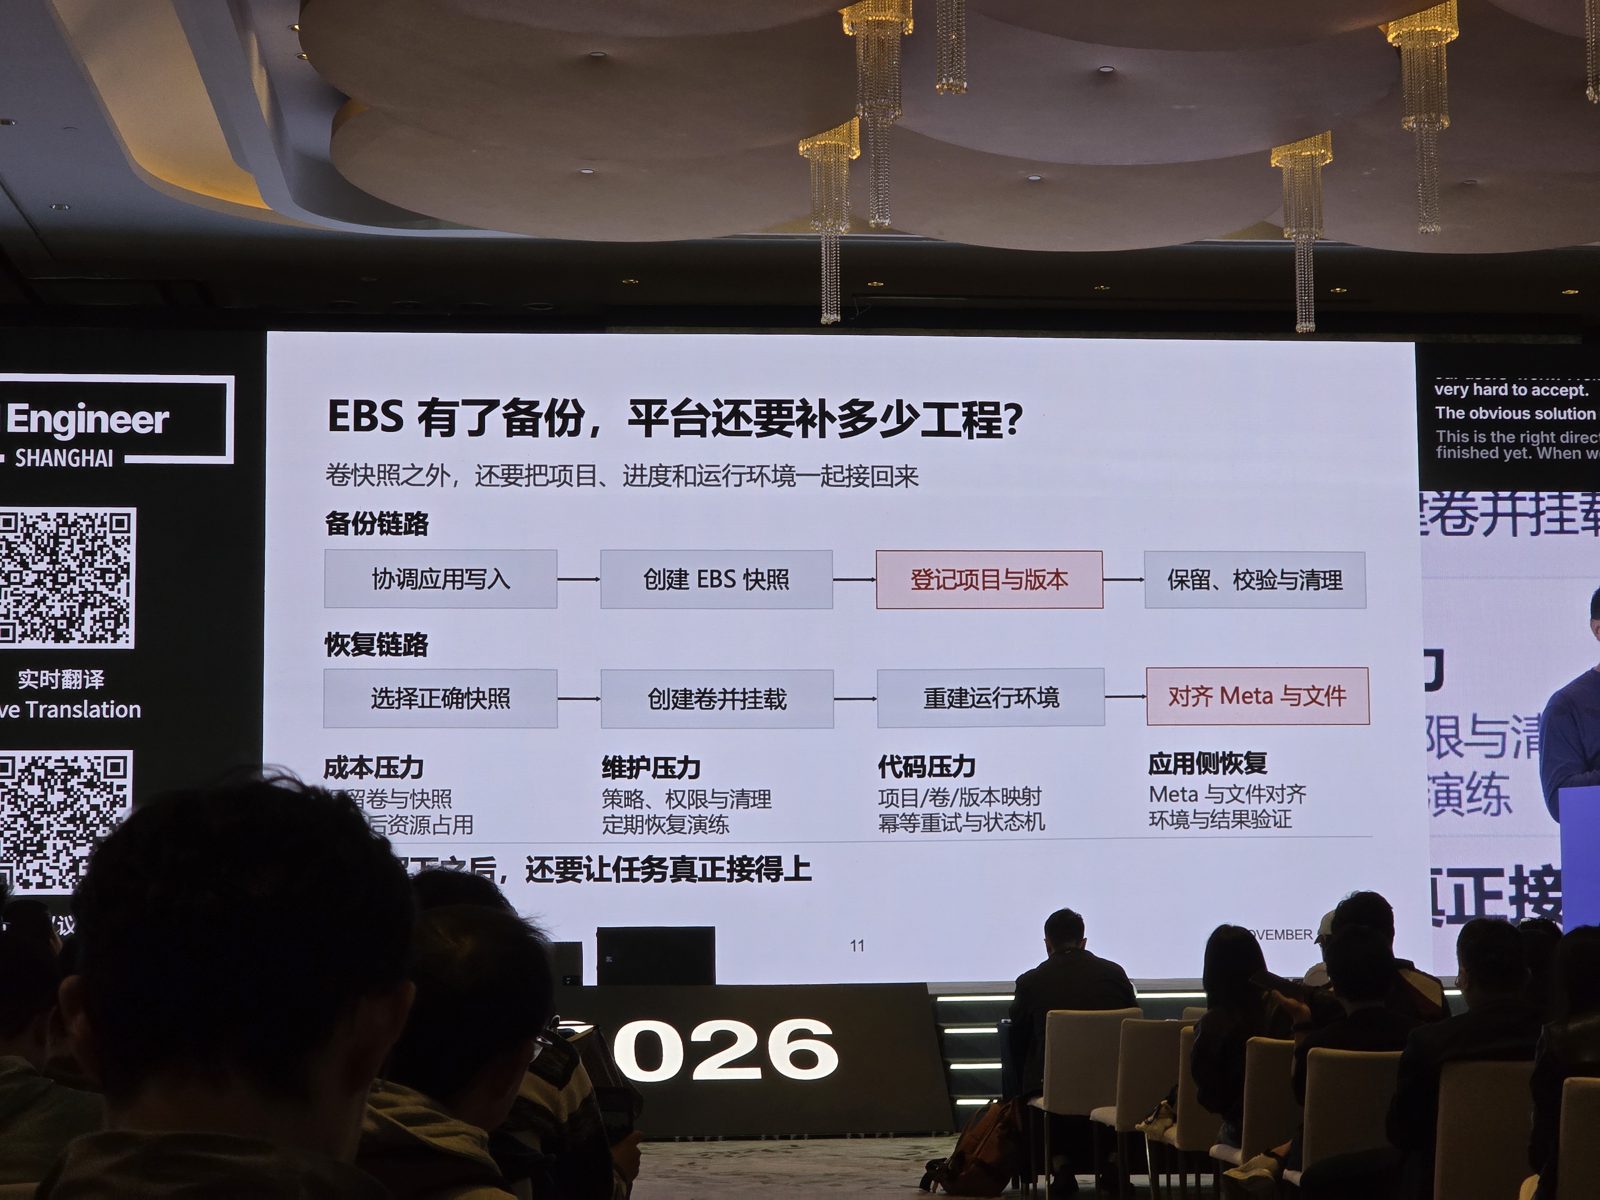
第 11 张投视频:用了 EBS snapshot 之后,平台还得自己做的事。备份是协调写入、做 snapshot、登记项目与版本、保留/验证/清理;还原是挑 snapshot、创建并挂载 volume、重建运行环境、重新对齐 Meta 与文件。
TiDB 的解法是一个放在 sandbox 外面的持久化文件系统。session A 写入,sandbox 消失,session B 挂上同一个 workspace。每个项目都是独立隔离的空间,他宣称可以扩展到数千万个。agent 生成的应用程序也套用同样模式:平台不必自己养一池 instance、处理创建逾时和建到一半的数据库,改由 TiDB Cloud Starter 在共享保存上发出数千万个彼此隔离的数据库。
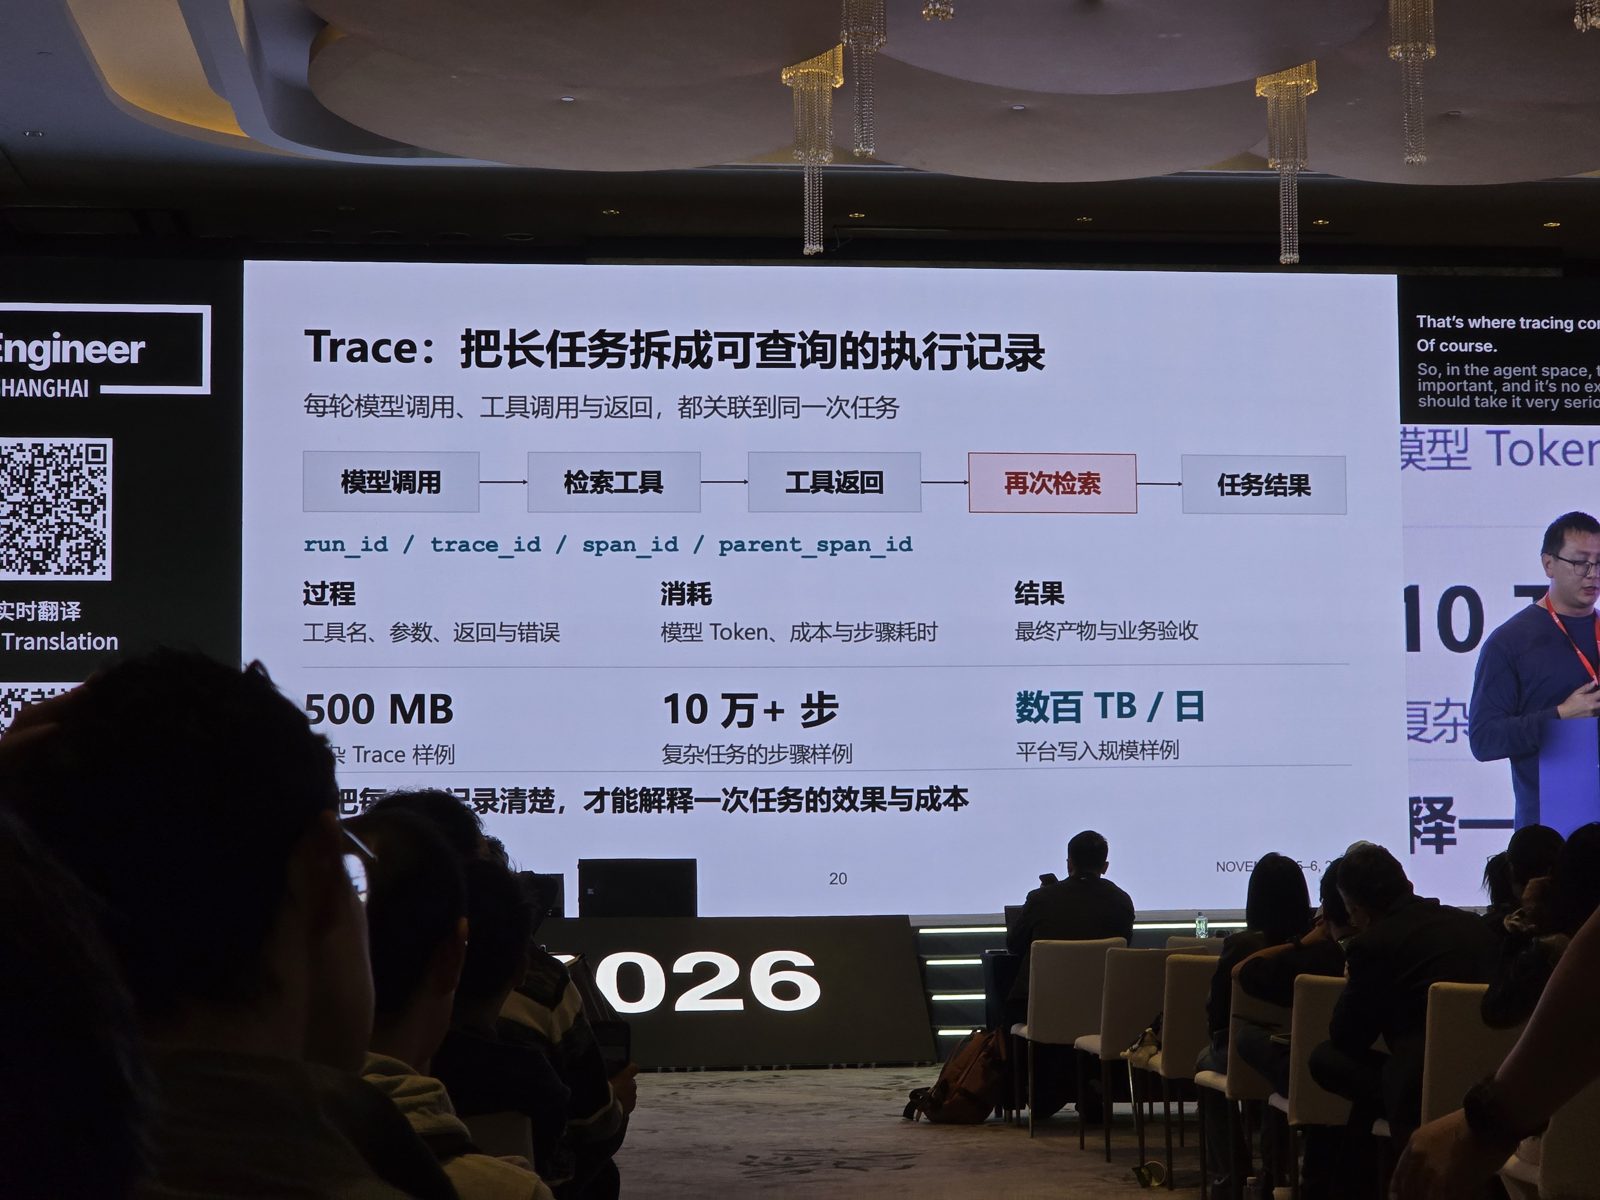
第 20 张投视频:把 trace 当成可查找的运行纪录,用 run_id / trace_id / span_id / parent_span_id 串起来。量级举例:一条 trace 500 MB,复杂任务超过 100,000 步,单一平台每天写入几百 TB。
tracing 这段数字最多。agent 任务跑两三个小时,有时超过十小时,单一 trace 就有几百 MB。一条 trace 只能解释一次运行。要决定该优化哪里,得看一整批,按 tool 和任务类型切开,单位成本还要算进失败的重试。他指出,某个 tool 被调用很多次,可能只是代表它很难用。他举了一个没具名的大模型团队,pipeline 是原始 NDJSON trace、用 SQL 清洗,再把分析用的副本放在对象保存(TiDB Cloud Lake)上,喂给两条分开的运算路径,一条做问题排查,一条做批量的品质与成本分析。
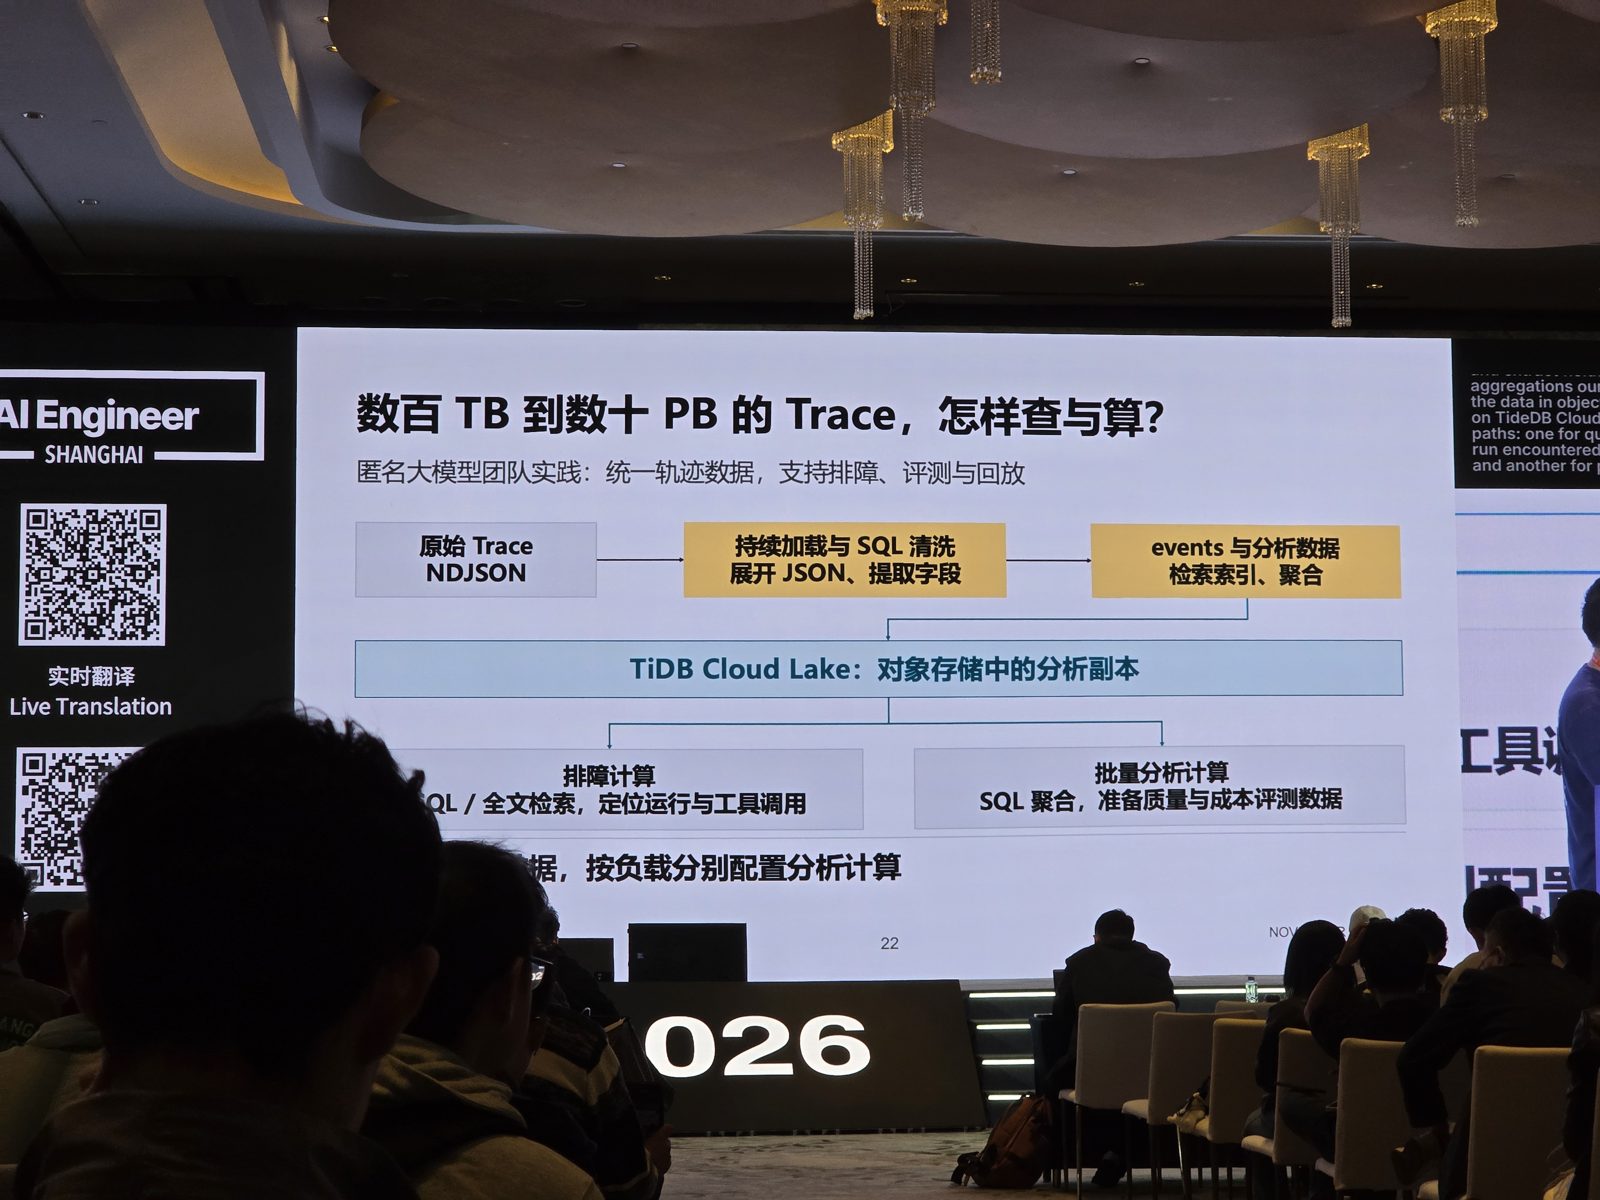
第 22 张投视频:几百 TB 到几十 PB 的 trace。原始 NDJSON 加载后用 SQL 清洗成 events 与汇总数据,存在对象保存上的 TiDB Cloud Lake,再由分开的排查与批量分析运算来查找。
如果你换了模型或 tool,然后直接把任务重跑一次,输入、tool 回传和文件早就在底下变了,你没办法判断这个改动到底有没有帮助。trace 告诉你发生了什么,但你没办法从 trace 重新开始。他们的 checkpoint 把 metadata snapshot 和 events 绑到一个文件系统 checkpoint 上,所以可以把 agent 的状态 fork 成两份一模一样的副本,各试一个改动,用同一套标准评判,之后再去检查类似任务、多跑几次排除随机性。
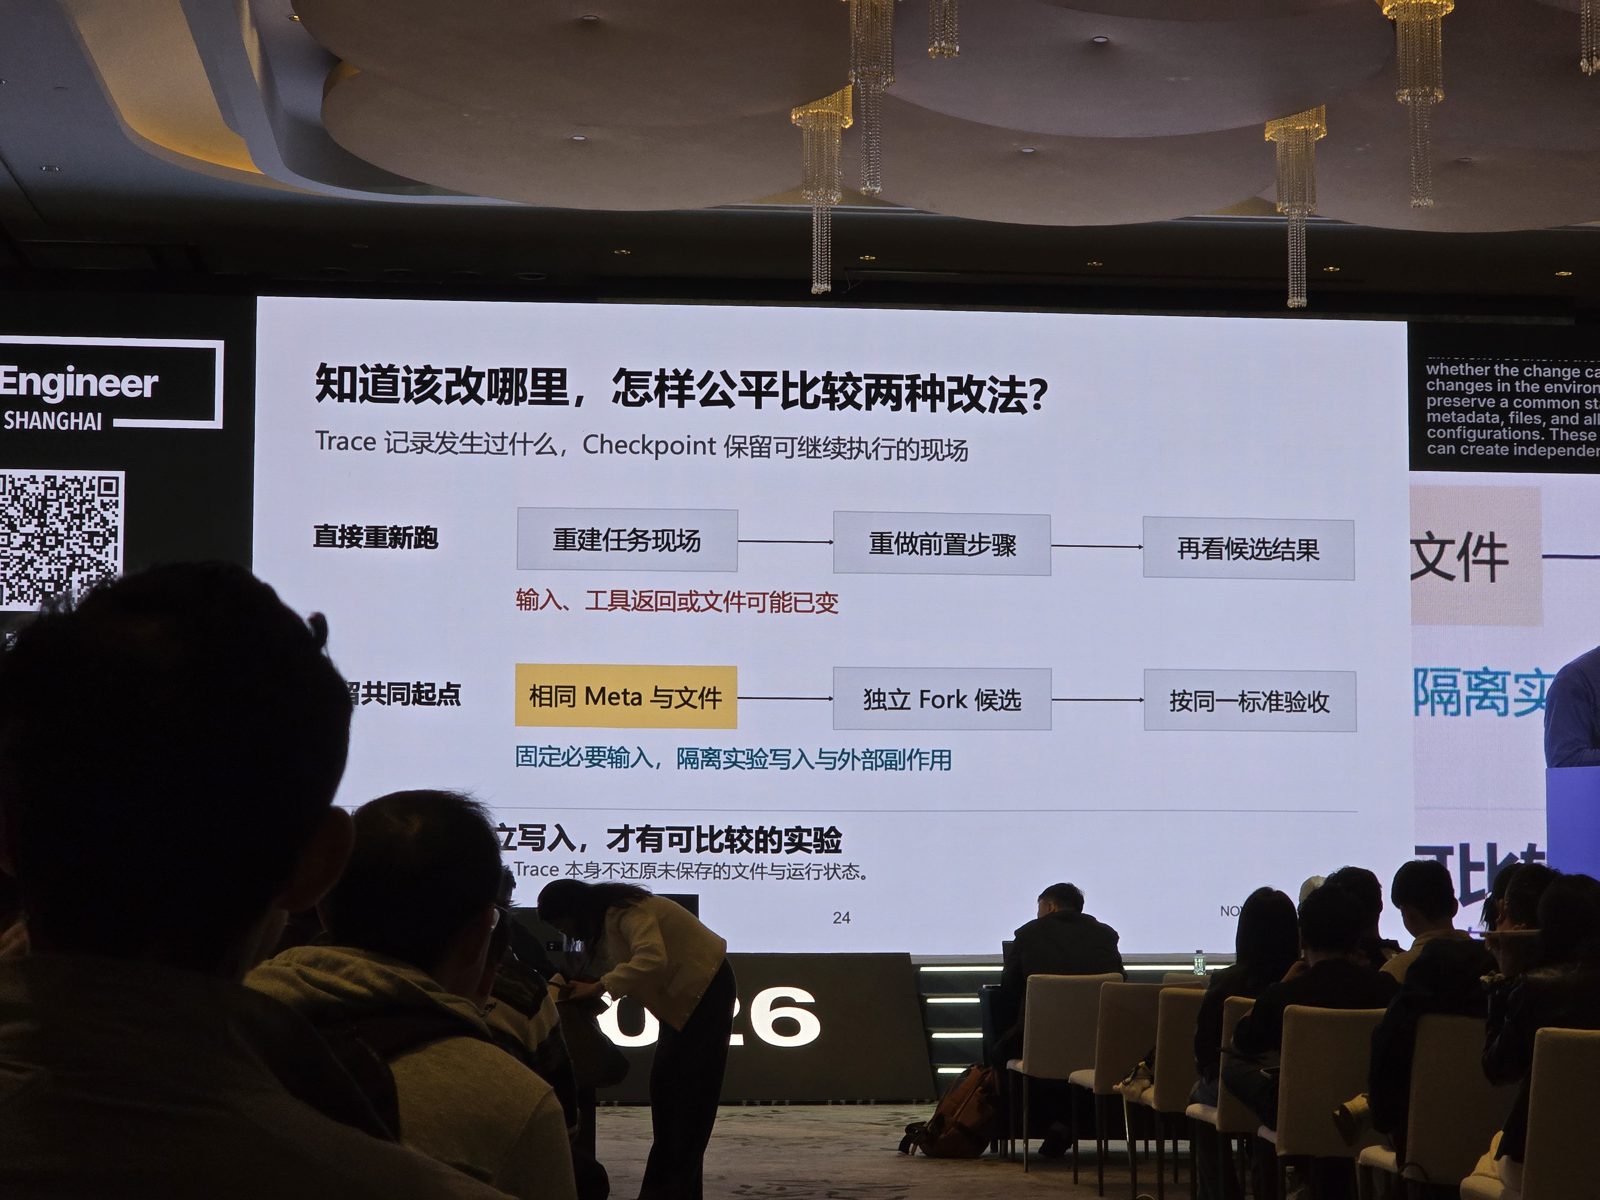
第 24 张投视频:从头重跑,对比从共同起点 fork(相同的 Meta 与文件、各自独立的 fork 候选、同一套验收标准),实验性写入与外部副作用都隔离开来。
优化整个组织的 LLM 推论成本:按席位授权、按 token 计费、布建容量,以及其他做法 — Do Tuan Anh (Techcombank)
Do Tuan Anh(大家叫他 TA)在越南最大的商业银行之一 Techcombank 负责数据、AI 和 agent 平台。17:00 的休息时间取消了,所以他的演讲比节目表上的时段早了大约十分钟开始,这也是后面两场快讲场跟着提早的原因。他讲了大约十二分钟。
他的论点是,一旦 AI 的使用进入规模化阶段,要管的数字就是每百万 token 的有效混合成本:整个组织的输入加输出,算进缓存之后的成本。他们的这个数字有时会突然跳上去,因为用户都想用最好的模型 Opus,就不再用 Sonnet 或 Haiku 了。付费方式有三种:Claude Code 或 AWS Kiro 这类订阅、按 token 计费的 API,以及布建的 GPU。他所谓的“效率点”,是 GPU 每月的成本除以 API 的混合价格,算出来的用量就是超过之后应该自己 host 模型的门槛。
他用 GLM 5.3 当例子。通过 API,每百万输入 token 大约 1 美元,每百万输出 token 5 美元。以他给的一般用途输入输出比 4:1 来算(tool calling、MCP 和 RAG agent 是 10–15:1),混合起来大约每百万 2 美元。两台各有八张 B200 的 AWS 节点,每月约 16.6 万美元。他说损益平衡点是每月“大约 8,300 万”个 token,照他的数字,16.6 万美元以每百万 2 美元计是 830 亿个 token。在他的另一个例子里,一家每月用 670 亿 token 的公司不应该转换,转了的话每月反而多花大约 3.2 万美元。超过这个点,他预期可以省 30–50%,搭配多年期的 savings plan 和谈来的折扣会省更多,扣掉维运人力的成本就省得少一些。每月 3,000 亿 token 的情况,他估算 API 要 50 万美元,布建只要 20 万美元。
他提了三个但书。GPU 很难拿到,所以要及早跟云端大厂一起规划。尖峰是真的会出现:autoscaling 曾经得从 12 张 GPU 扩到 15 张,所以银行保留 API 当作 fallback,主要模型则是布建的 GLM,放在 Databricks 的 Unity AI Gateway 后面。试行期间大约 10% 的请求走到 API,用户完全没察觉。另外,这些数字会随着每家公司拿到的折扣而有很大的差异。他最后讲的是 routing。有些模型对越南文和中文的 tokenization 很差,同样的文本在这些模型上要花更多 token。银行依语言和语意来做 routing,他说这又省了 40–50%。他今年在 NeurIPS workshop 发表的论文,量的就是越南文的这种 tokenization 税。
在 Agent Substrate 上大规模跑 RL:调度数百万个 sandbox — Tinsley Shi (Google)
这是十分钟的快讲场,而且比节目表上的时间早了大约十分钟开始。Tinsley Shi 在 Google 做 agentic infrastructure,讲的是 coding agent 做 RL post-training 背后的 sandbox。
她从单一个 RL step 讲起。模型拿到一个任务,例如“用 Python 写 hello world”。系统用该任务的 image 认领一个 sandbox,LLM 思考,它产生的不可信代码在 sandbox 里运行,再由 grader 评分。实务上,一个 lab 每个任务会采样大约 16 条 trajectory,任务数约 1,000 个,所以一个 step 会同时要大约 16,000 个 sandbox,而且全部同步释放。她指出一般的 agent serving 和推论几乎不会碰到这种并行量,现成的容器基础设施本来就不是为此设计的。
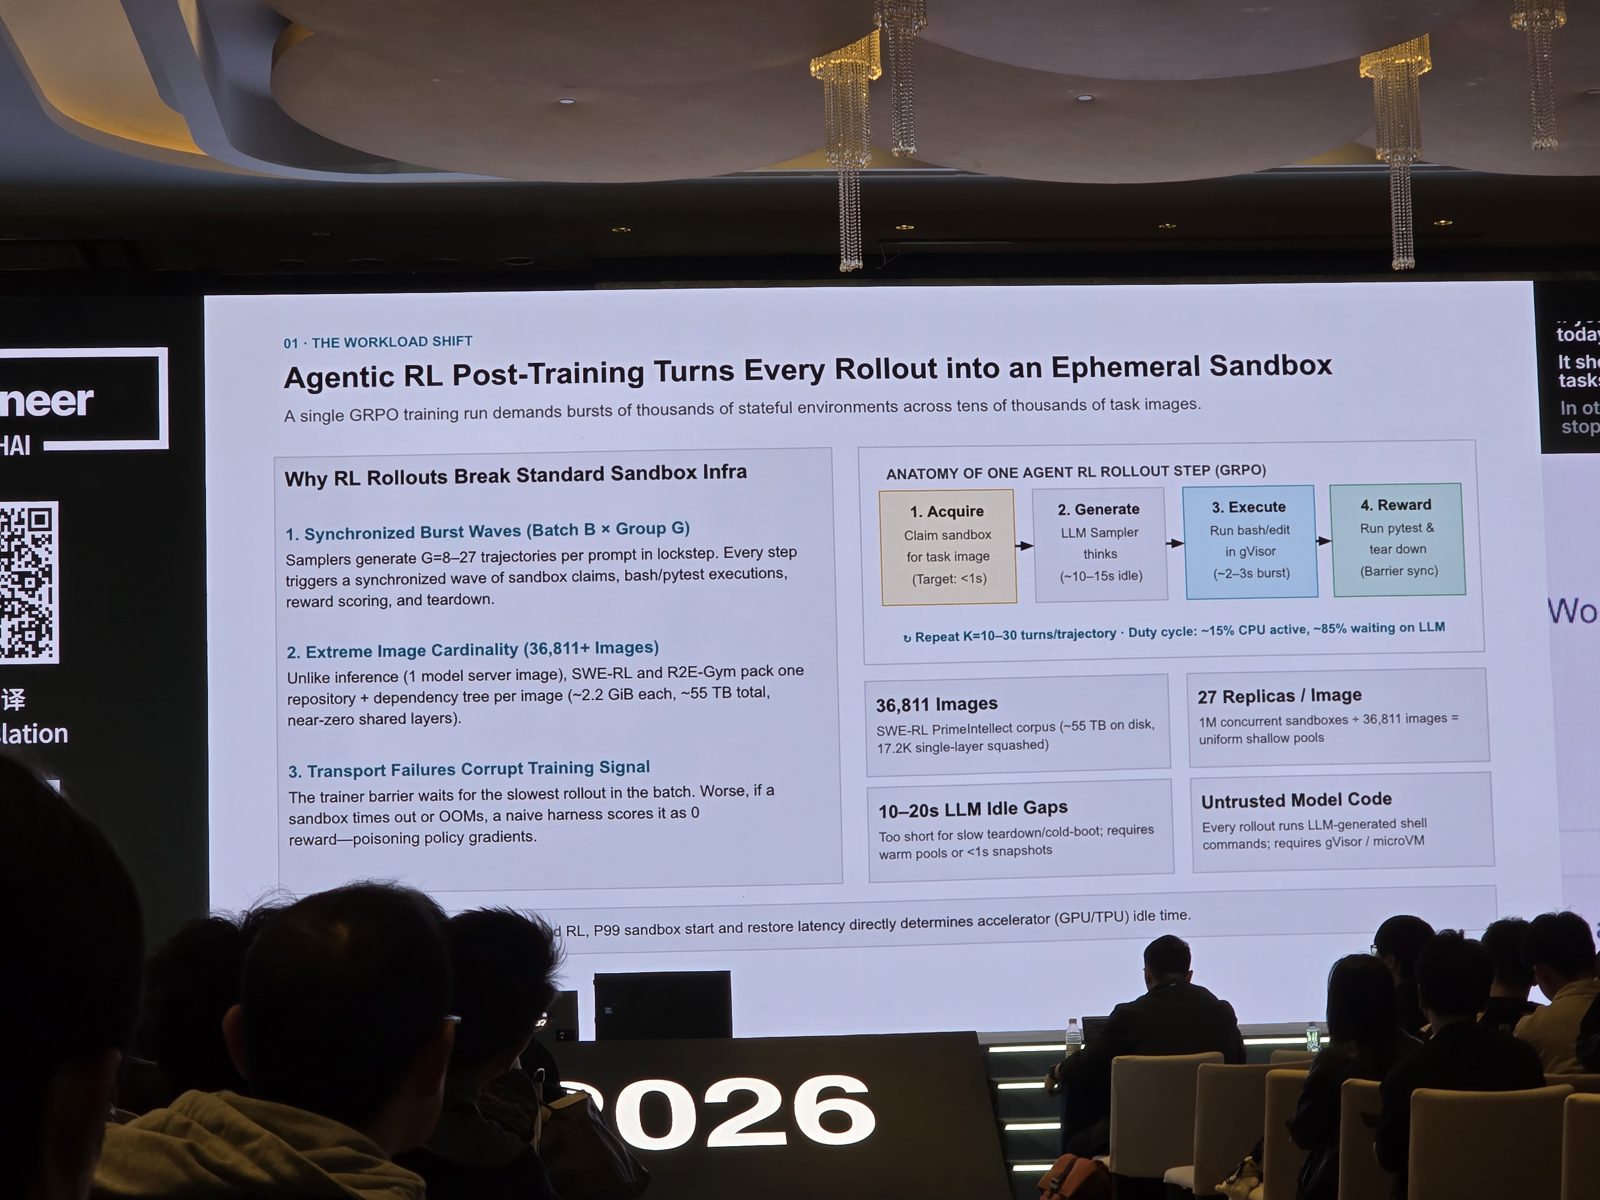
workload 投视频:一个 GRPO rollout step 分成 acquire(目标 1 秒内)、generate(LLM 思考时闲置 10-15 秒)、在 gVisor 里 execute(2-3 秒的突发)、reward 与 tear down。duty cycle 约 15% CPU 在忙,85% 在等 LLM。
除了突发量,还有两个问题。coding 任务是一个 GitHub repo 加上它的相依套件打包成一个 image,所以每个 image 有好几 GB,几乎没有共用的 layer(投视频上写每个约 2.2 GiB,总共 55 TB)。另一个问题跟数据品质有关:如果 sandbox 逾时或内存用光,单纯的 harness 会把这次 rollout 记成零 reward。基础设施的失败就变成了错误的标签,这个错误标签会进到 policy gradient 里。同时,sandbox 大约 80% 的时间闲着在等模型,而加速器又在等 sandbox 启动。她的投视频讲得很直白:p99 sandbox 启动 latency 就是加速器的闲置时间。
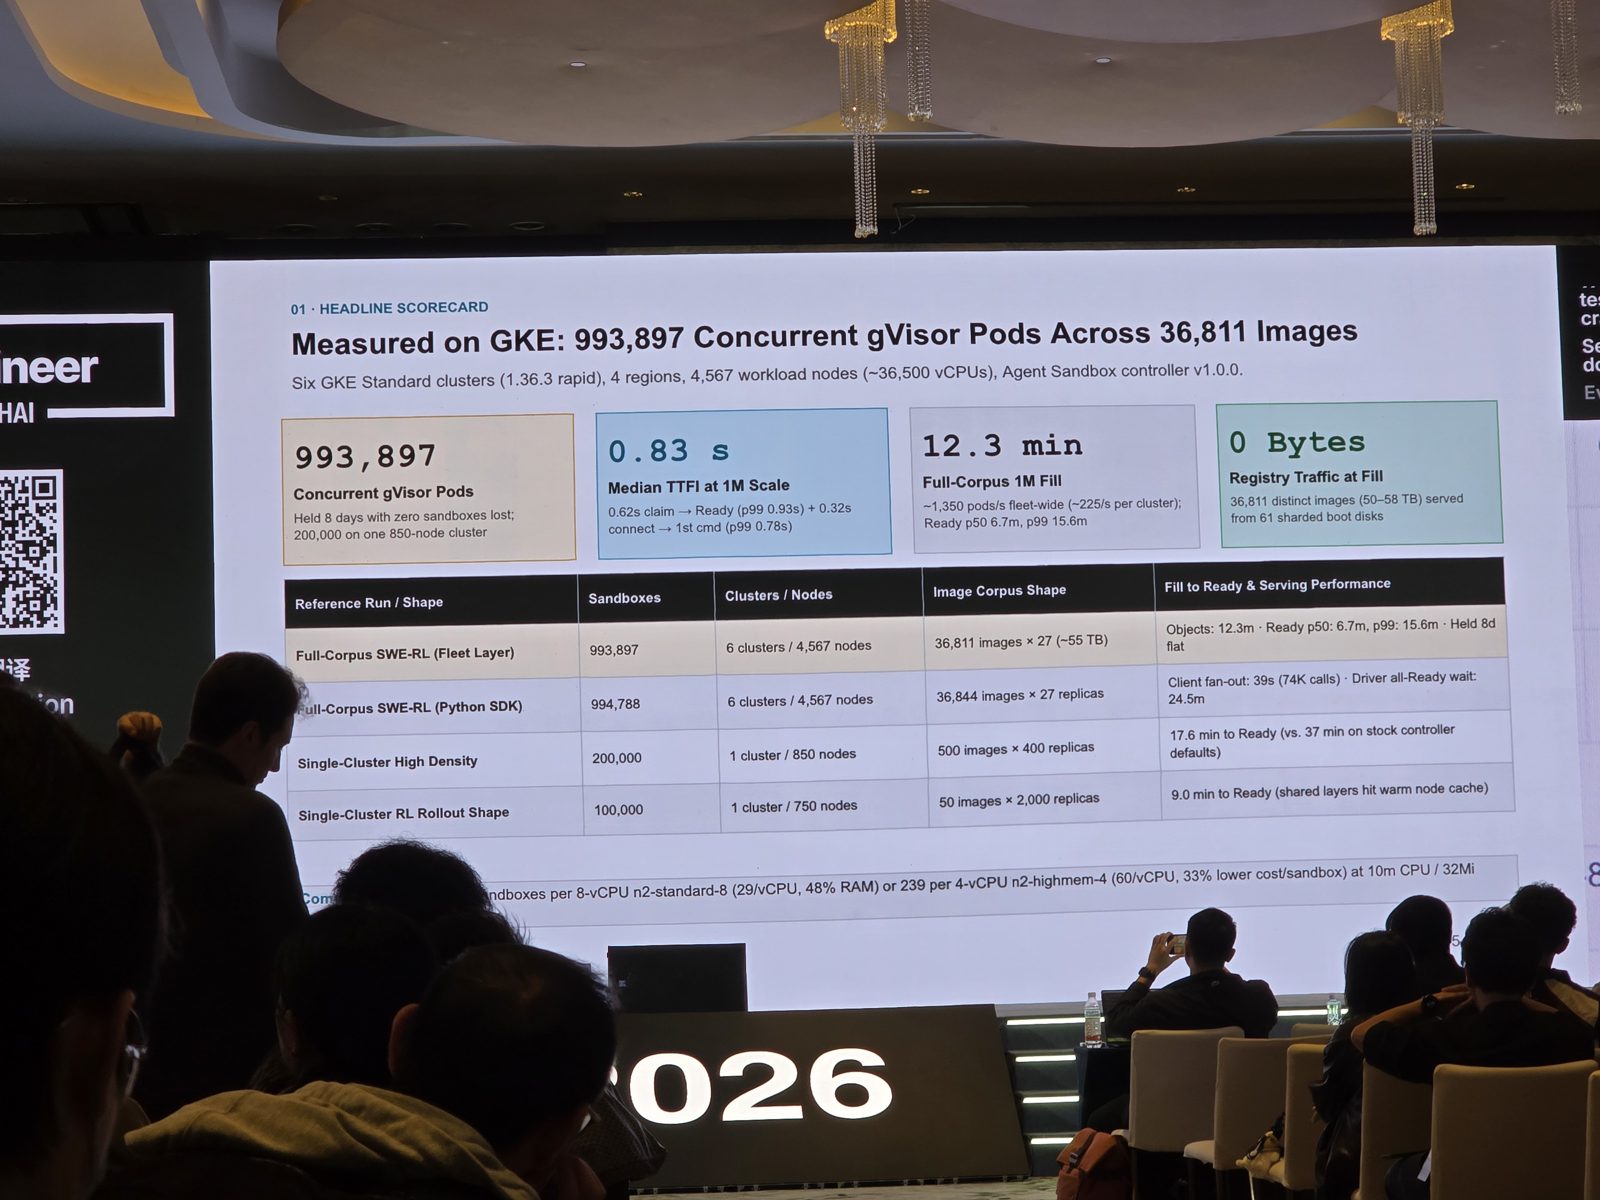
GKE 上的成绩总表:993,897 个并行 gVisor pod,横跨 36,811 个 image;百万规模下到第一个指令的中位数时间 0.83 秒;填满整个 1M 语料要 12.3 分钟;填充时 registry 流量 0 bytes。六个集群、4,567 个节点、约 36,500 个 vCPU。
这些数字来自 GKE 上开源的 Agent Sandbox controller。他们维持大约一百万个并行 gVisor pod 跑了八天,没有遗失任何 sandbox,到第一个指令的中位数时间是 0.83 秒,从 warm pool 填满要 12.3 分钟。密度是每个节点 60 个 sandbox。她讲的修正全都在调度层:把 image 放在靠近节点的地方并做缓存、调校 API server 和 controller、把网络身分合并,让 10,000 个 sandbox 需要的数量少很多。他们也用 TPU 搭配 397B 参数的 Qwen 模型跑过。dashboard 的 demo 视频没有播出来。
下一步是 Agent Substrate:用 snapshot 与还原取代一直待命的 warm pod,投视频上写的恢复时间在 300 ms 以内,另外用独立的 data plane 来绕过 control plane 的限制。她说预计 11 月底发布。两个项目都是开源的。
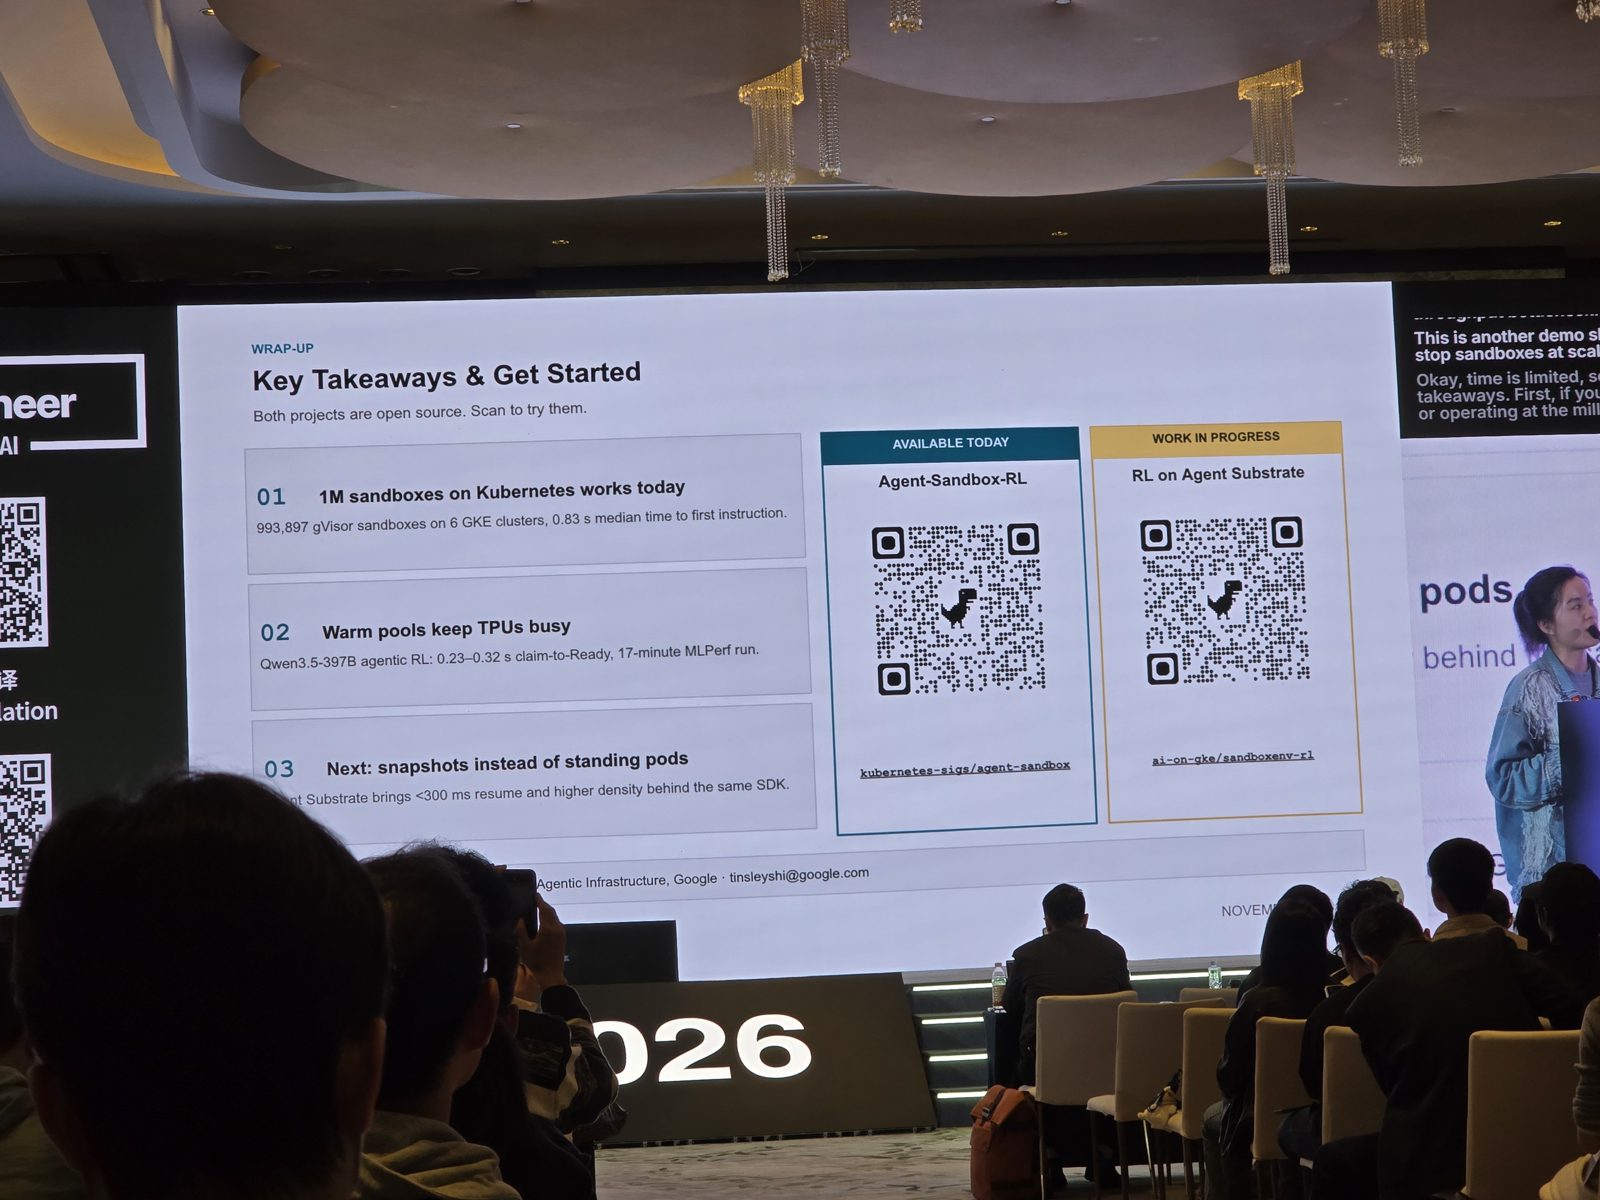
收尾投视频:Kubernetes 上跑一百万个 sandbox 今天就做得到,warm pool 让 TPU 保持忙碌,下一步是用 snapshot 取代待命的 pod。附有 kubernetes-sigs/agent-sandbox 和进行中的 RL-on-Agent-Substrate 的 QR code。
AI 时代游戏开发者的日常 — Tang Feihu (Kimi / Moonshot AI)
Tang Feihu 负责 Moonshot AI 的开发者关系,讲的是当天最后一个快讲场,长度十分钟。他的主张是,agent 现在已经能自己扛长任务,所以做一个可以玩的游戏原型变得很便宜,开发者的工作转成决定要做什么、验收交回来的东西。他说身边很多任务程师已经不手写程序了,有些人连 AI 写的代码也不看了,因为量太大。
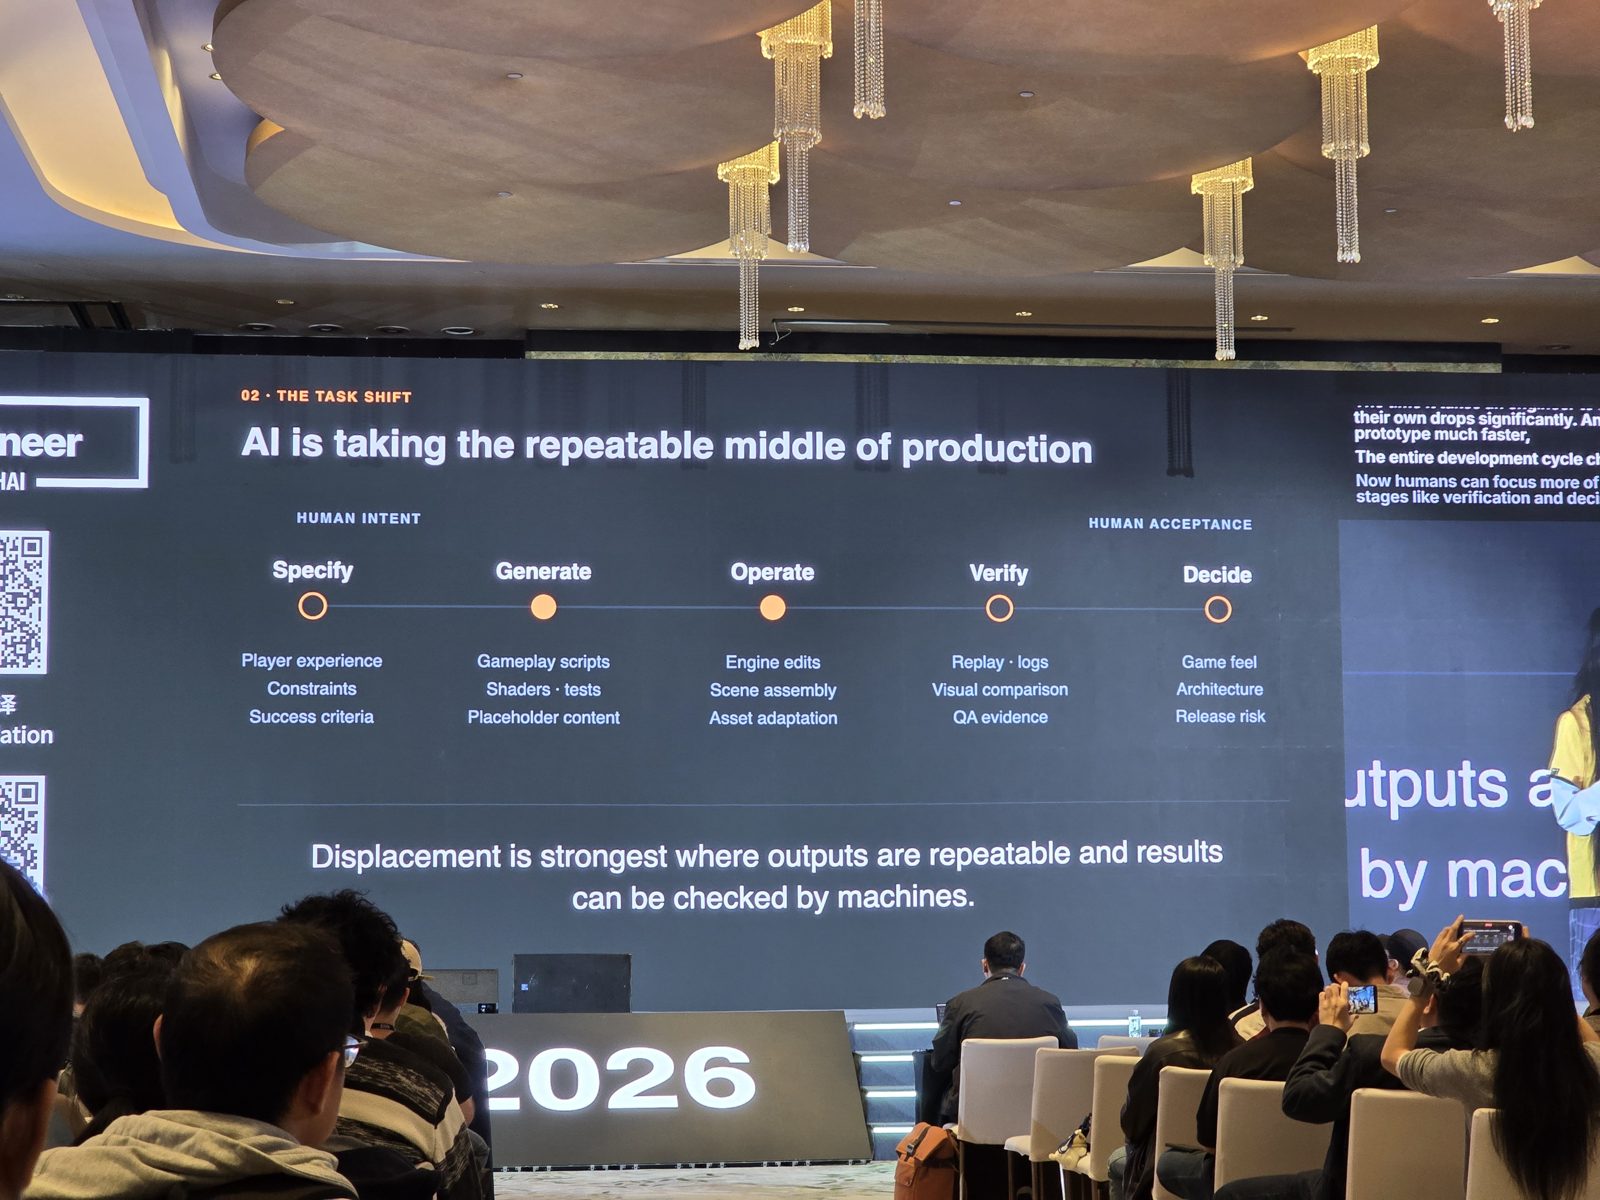
任务转移的投视频:Specify(玩家体验、限制条件、成功标准)留给人,Generate、Operate 和 Verify 交给 agent,Decide(游戏手感、架构、发布风险)回到人身上。投视频底部的结论:产出可重复、能由机器检查的地方,被取代得最明显。
这张投视频把线画在这里:机器能检查的工作(脚本、shader、场景组装、replay 与 log 比对)最先被自动化,没人写得出测试的部分则留给人。
剩下的是一连串 demo,大多用 Kimi K3.1 Pro 做的。他展示了一段模型依照目标渲染出来的动画,难点在于让爆炸和周围场景产生交互;还有一位没有游戏背景的同事画在纸上的分镜,被做成了动画。他提到一些长时程的 benchmark,现在会给 agent 一个 sandbox 和 GUI 工具,然后评分它交付的成果,而不是聊天框里的一段代码。其中一个范例任务是要 agent 用 RPG Maker 重做老 Flash 游戏魔塔(Magic Tower);其他任务则是操作游戏引擎或 Blender。在展览摊位上,Moonshot 展示了三款自家工程师用最新模型做的游戏,每款大约花四天、约人民币 3,000 元的 token。
他也介绍了几个社群项目。抖音上一支爆红的假“阿嬷 GTA”视频,大约一周后就在 GitHub 上变成一款可以玩的开源游戏,用的是一个“视频转游戏”的 skill。有人把 Diablo II 之类的 Switch 游戏移植到 iPhone 上,并重新设计触摸操作。他还展示了一位社群大使做的小王子游戏(那位大使当天下午稍早在分会场讲过),以及一位没有工程背景的同事做的动作游戏。
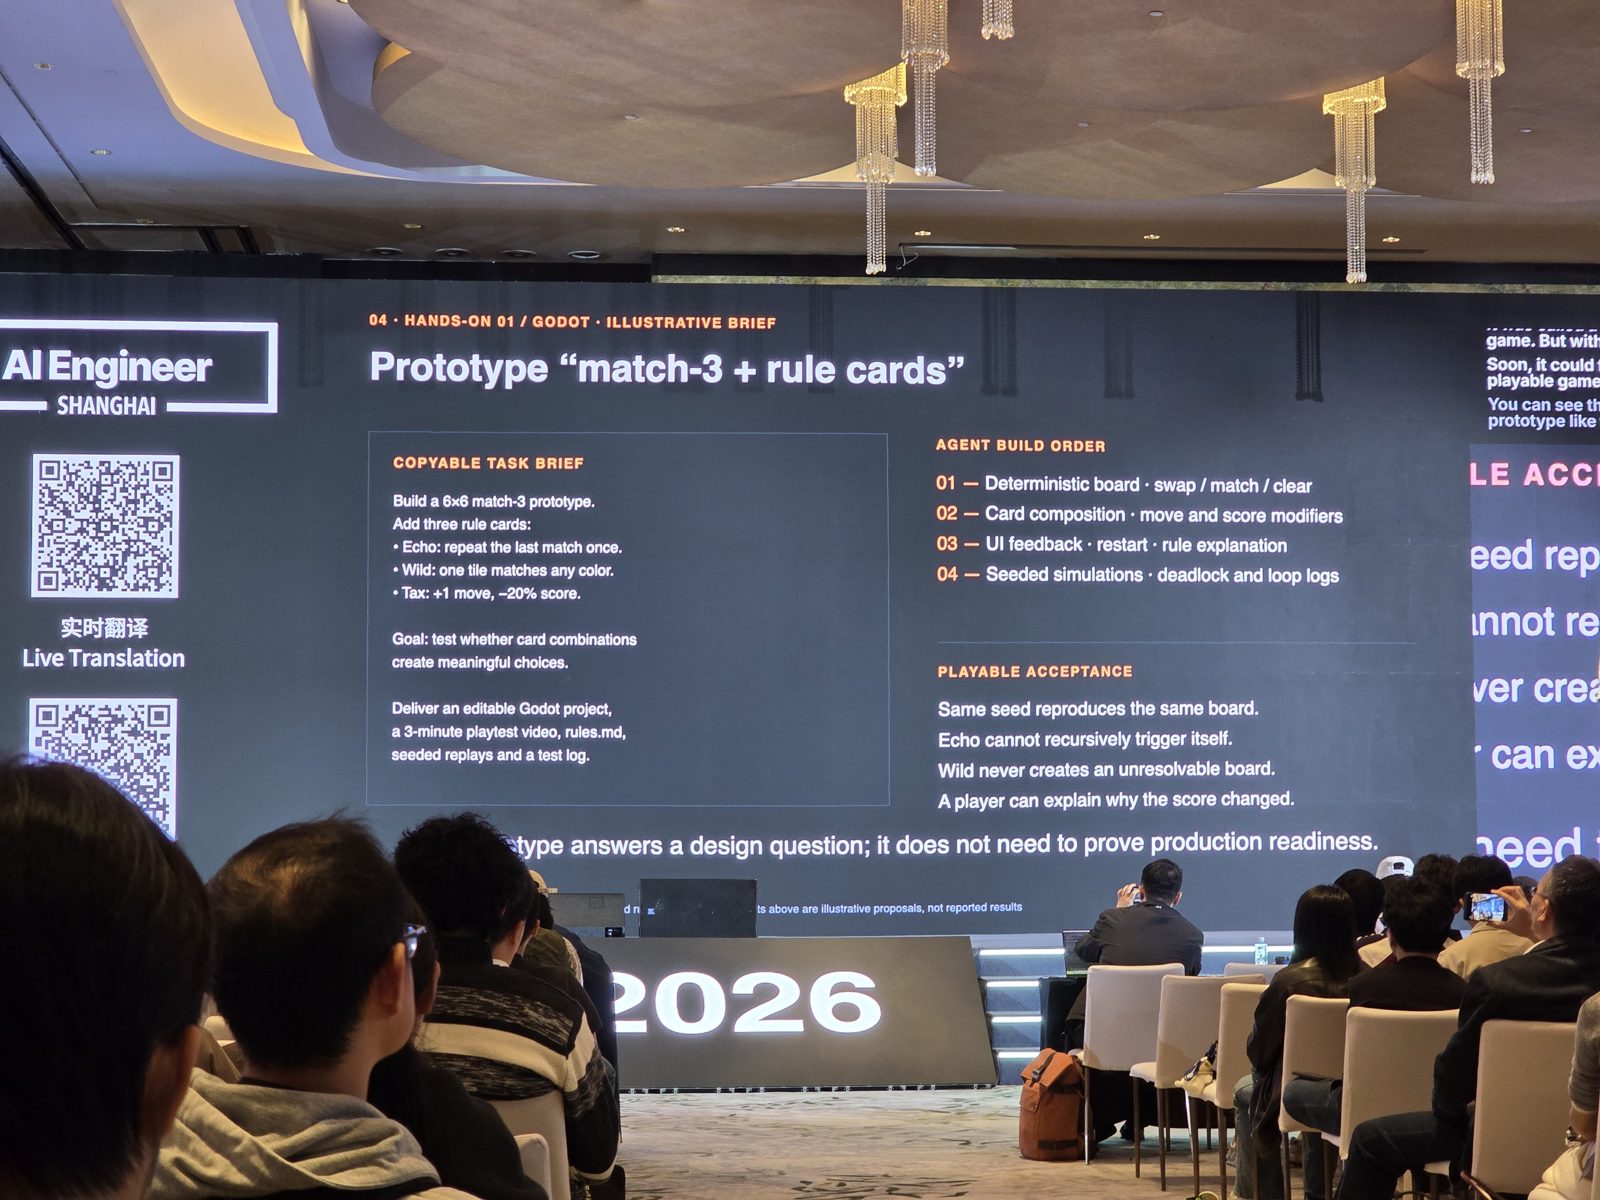
一份写好的任务说明,对象是一个 Godot 三消游戏原型,附三张规则卡:交付物(可编辑的项目、3 分钟试玩视频、rules.md、带 seed 的 replay、测试 log)、agent 的建构顺序,以及像“同一个 seed 会重现同一个盘面”这样的验收检查。注脚标明这些是示意性的提案,不是实际结果。
最后一个例子是他自己的。他让一个较早的模型逆向一款老游戏,拆出它的世界地图,再加上航海和可以探索的城市。agent 通过截屏观察运行中的游戏,发现一个 bug,修掉它,然后写了一份报告说明它是怎么找到的。他的重点是,像这样的自我检查可以让一轮迭代跑得更久,人才需要介入。最后他说主流游戏工作室都在把模型加进 pipeline,人的角色会变成验收和设计。