概覽
AI Engineer Shanghai 2026 的第二天是 11 月 6 日,地點一樣是上海虹橋希爾頓,一樣只有一個主舞台。議程上的主題是世界模型、實體 AI 和 AI-native 產品。第一天的筆記在第一天的文章。
上午談的是模型要吃進什麼,以及怎麼檢查它吐出來的東西。World Labs 共同創辦人 Christoph Lassner 開場,講世界模型的分類。HeyGen 主張對影片 agent 來說,HTML 是比 JSON 更好的 context。Chiling 的創辦人說,垂直 AI 唯一剩下的護城河是你自己編碼進去的專家知識;HICAP 則說,工廠裡的最後一哩路是沒有任何系統透過 API 開放出來的資料。接著是兩場談檢查的演講:Daily.co 講在自己看不懂的語言上,要怎麼信任 voice agent 的 eval;NUS 講 3,000 場即時語音轉文字 session 讓他們的 benchmark 數字變成什麼樣子。
一場投資人座談之後,下午從 harness 講到機器人。MiniMax 說明隨著模型變強,他們在 agent harness 裡放掉了哪些控制。實體 AI 的時段有 AiMoga 的工廠機器人、VAST 的持久世界模型、QuantSparkle、Noematrix 和 DYNA 三種繞過 sim-to-real gap 的不同做法,還有 Futuring 的居家機器人。Liquid AI、masons.ai 和 1Password 分別講小型決策模型、彼此對話的 agent 網路,以及在執行期檢查 agent 的 tool call。最後三場快講談機器人資料、團隊記憶和讀網頁的成本,結束了這一天。
以下筆記照議程時間順序整理。
世界模型的分類 — Christoph Lassner (World Labs)
Christoph Lassner 在 2024 年初和 Fei-Fei Li、Justin Johnson、Ben Mildenhall 一起創辦 World Labs,這次他以個人身分替第二天開場。現在生物、化學和企業軟體用起「世界模型」這個詞,跟機器人領域一樣隨便,他想讓這個詞重新變得能用。他的開場是 8 月的一張迷因圖,上面排著 LLM、SLAM、3D Gaussian splatting、影片生成、Google Maps、JEPA,還有 Ha 和 Schmidhuber 那篇 World Models 論文裡的示意圖,每一個都自稱是世界模型。
他從強化學習講起,這個詞現代的用法就是從那裡來的。世界模型是描述一個世界如何運作的模型,它回答的是「如果我採取這個動作,接下來會發生什麼?」它不一定要是視覺的。在常見的部分可觀測迴圈裡,agent 只看得到世界狀態的一部分。state estimator 把每次的觀測、前一個 belief 和上一個動作合成新的 belief,再由 policy 根據它挑出下一個動作。世界模型就是「世界怎麼變化、觀測怎麼產生」的知識,它同時提供給 estimator 和規劃使用。在這之上,他用了 World Labs 6 月那篇文章的切法:渲染(rendering)產生觀測,模擬(simulation)產生一個可能的世界狀態,規劃(planning)產生動作。一個模型可以做這三件事的任意子集,包括一件都不做,而做到其中一件並不會讓它變成世界模型。
接著他把那張迷因圖拿來套,只要至少有一種實作符合就算。他問 LLM 能不能算是描述世界如何運作的模型,只有兩三個人舉手,問到 SLAM 時舉手的人多一些。他的答案是兩個都算。LLM 不能渲染,但能模擬和規劃。Google Maps 吃進資料,整合成一個 belief,再幫你規劃行程。每一項都過關,而這正是他要講的:只看功能的話,Google Maps 和 SLAM 會被丟進同一鍋。
所以他加了幾個軸。領域(domain)區分空間世界、CRM 或使用者介面這類數位領域,以及像人類細胞模型這種專門領域。尺度和解析度區分的是一個房間和一顆行星。他舉的例子是 livex.earth,一個即時的地球儀,從衛星到天氣都有建模。覆蓋範圍(coverage)問的是模型保留了哪些變數,包括不在視野裡的那些。他放了一段自己用 Kling 4.0 做的影片,鏡頭在一個生成出來的路口繞來繞去,結果每個方向都是紅燈。他的工作定義是:一個預測世界如何運作的模型,具備一組功能,屬於領域 X,尺度和解析度是 A 和 B,覆蓋範圍是 C。資料庫這類描述性的模型,他先放在一邊。
最後一部分是一個論點:世界模型會決定智慧怎麼和世界互動。他畫了一個 System 2,是一個掌握長期目標、能跨領域推理的大型多模態模型,底下是多個 System 1 模組,分別處理實體互動(視覺、觸覺、動作)和數位工作(語言、工具)。每個模組都有自己的世界模型、belief、estimator 和 policy。System 2 接收 System 1 的 belief,包括不確定性和失敗的動作,然後建立或修改那些即時執行的 policy。協調機制他沒有定案,只說這是一種可能的組織方式。
HTML 就是 agent 需要的一切:重新定義 context engineering — Bin Liu (HeyGen)
Bin Liu 自我介紹時說叫他 Ben 就好,他負責 HeyGen 的 agentic 影片業務。他的主張是,context engineering 裡最重要的決定是 agent 讀寫的表示格式,比記憶、工具或檢索都重要。選一個模型本來就擅長的格式,每次模型更新都會讓你的產品變好。自己發明一個格式,你的時間就會花在跟模型作對。

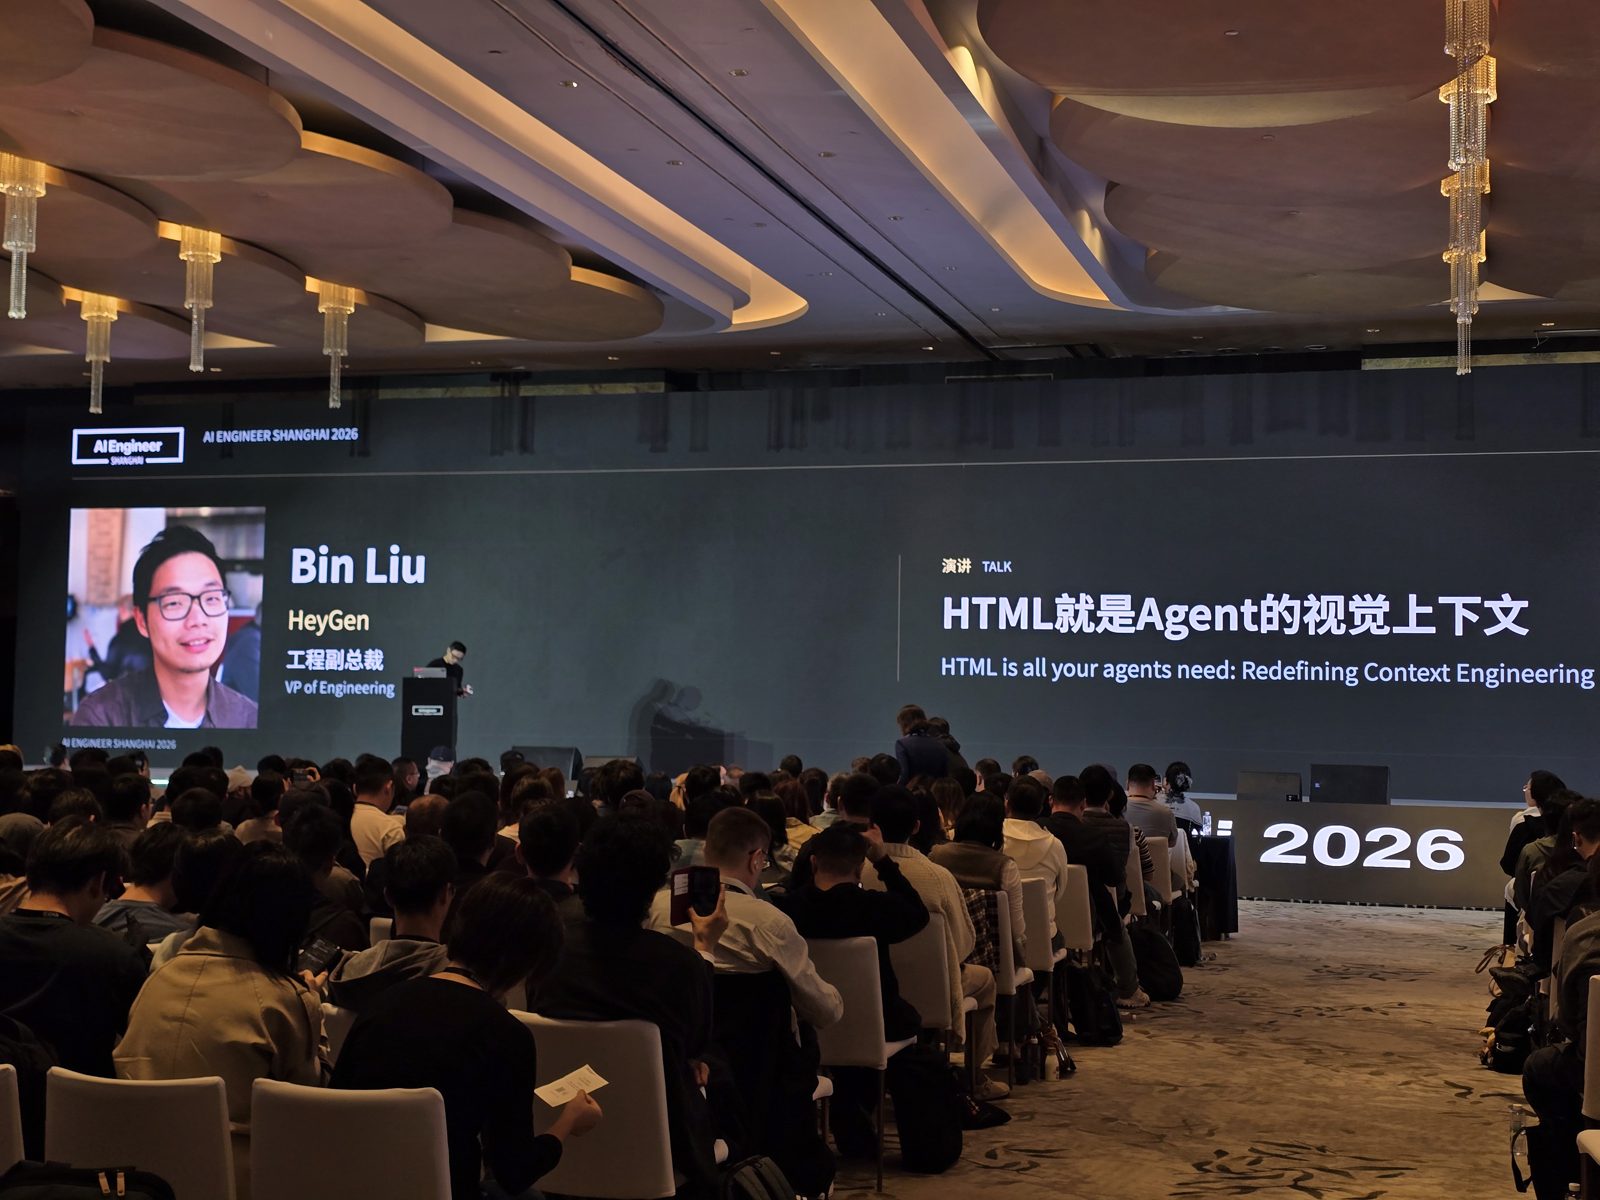
Bin Liu 在主舞台上的標題頁,中文標題是「HTML 就是 Agent 的視覺上下文」。
例子是 HeyGen 的第一個影片 agent。它建在既有的影片編輯器上,而編輯器的專案檔是 JSON:每支影片至少 2,000 行,有時候到 10,000 行。模型要寫出合法的 JSON 不難,但用他的話說,模型「沒辦法在你的 JSON 裡推理」。他放了兩段各四行的片段,單看文字都一樣沒問題。一段渲染出來是對的。另一段的文字跑到沒有人看得到的地方,而 agent 完全沒辦法知道,要等到 HeyGen 把那一格畫面渲染出來、把圖片餵回去才發現。他們內部把這比喻成請莎士比亞照著範例寫中文詩:看起來像詩,但不是好詩。
所以他們把 JSON 丟掉了。現在 agent 寫的是一般的 HTML、CSS 和 JavaScript,再由 HeyGen 在 4 月釋出的開源框架 HyperFrames 渲染成影片。他心裡的模型是一個一直在變的 landing page:文字飛進來、一段影片放到全螢幕、聲音出來。根據 repo 的說明,headless Chrome 會在動畫時間軸上逐格 seek 並擷取畫面,再交給 FFmpeg 編碼,所以同一份 HTML 永遠產生同樣的影片。
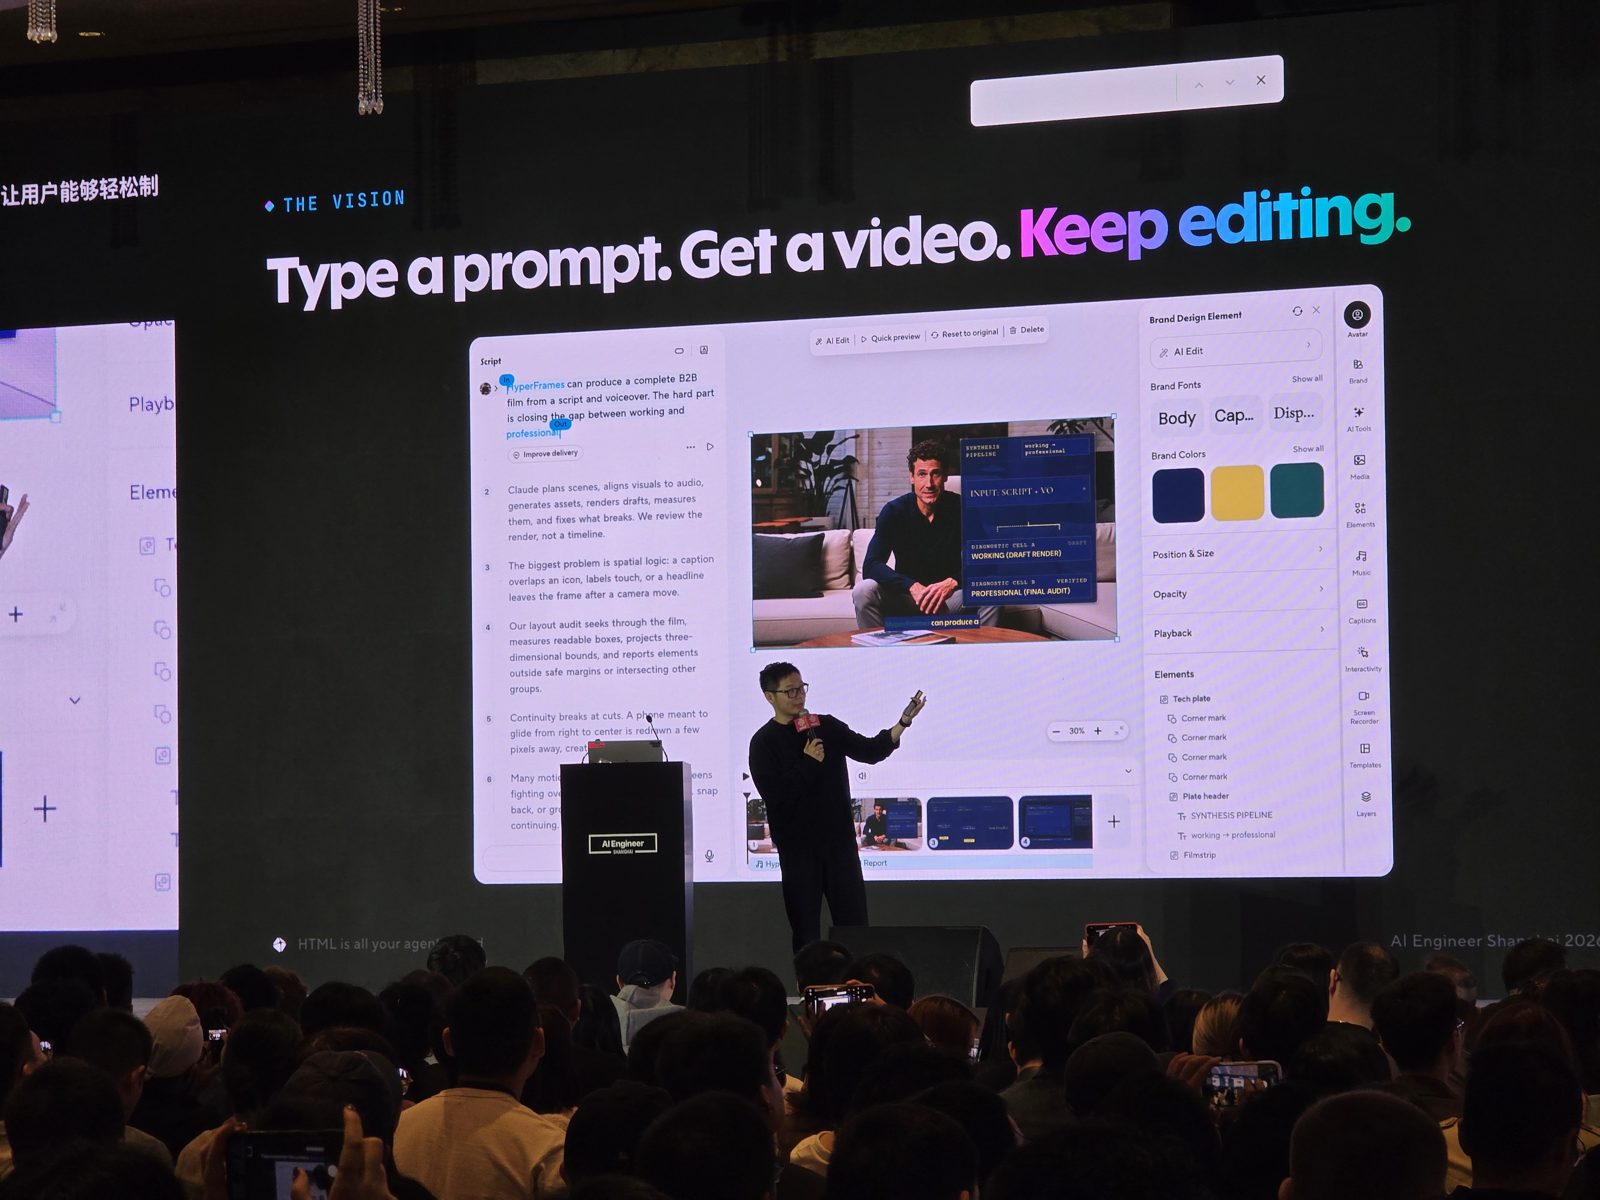
「Type a prompt. Get a video. Keep editing.」HeyGen 的編輯器。左邊的範例腳本描述了 agent 的迴圈:Claude 規劃場景、渲染草稿、量測,再修好壞掉的地方,另外由 layout audit 回報超出安全邊界或和其他群組重疊的元素。
他拿出的證據是採用的情況。他說 GitHub 上大約有 80,000 顆星,在全球 agent skill 的安裝數排第二。那支 demo 影片花了兩分半鐘才順利播放,影片裡說到 10 月底每天有 500,000 支影片;放完之後他又說「我其實覺得」現在已經是 700,000 了。他說有好幾週團隊什麼都沒發布,HyperFrames 還是一直成長,因為模型變好了。釋出後第 22 天,Anthropic 的 Thariq 發了一篇「HTML is the new markdown」。Bin 把它當成自己做對了的證明,還補了一句說他們抄了這個點子,卻「完全沒提到我們」。
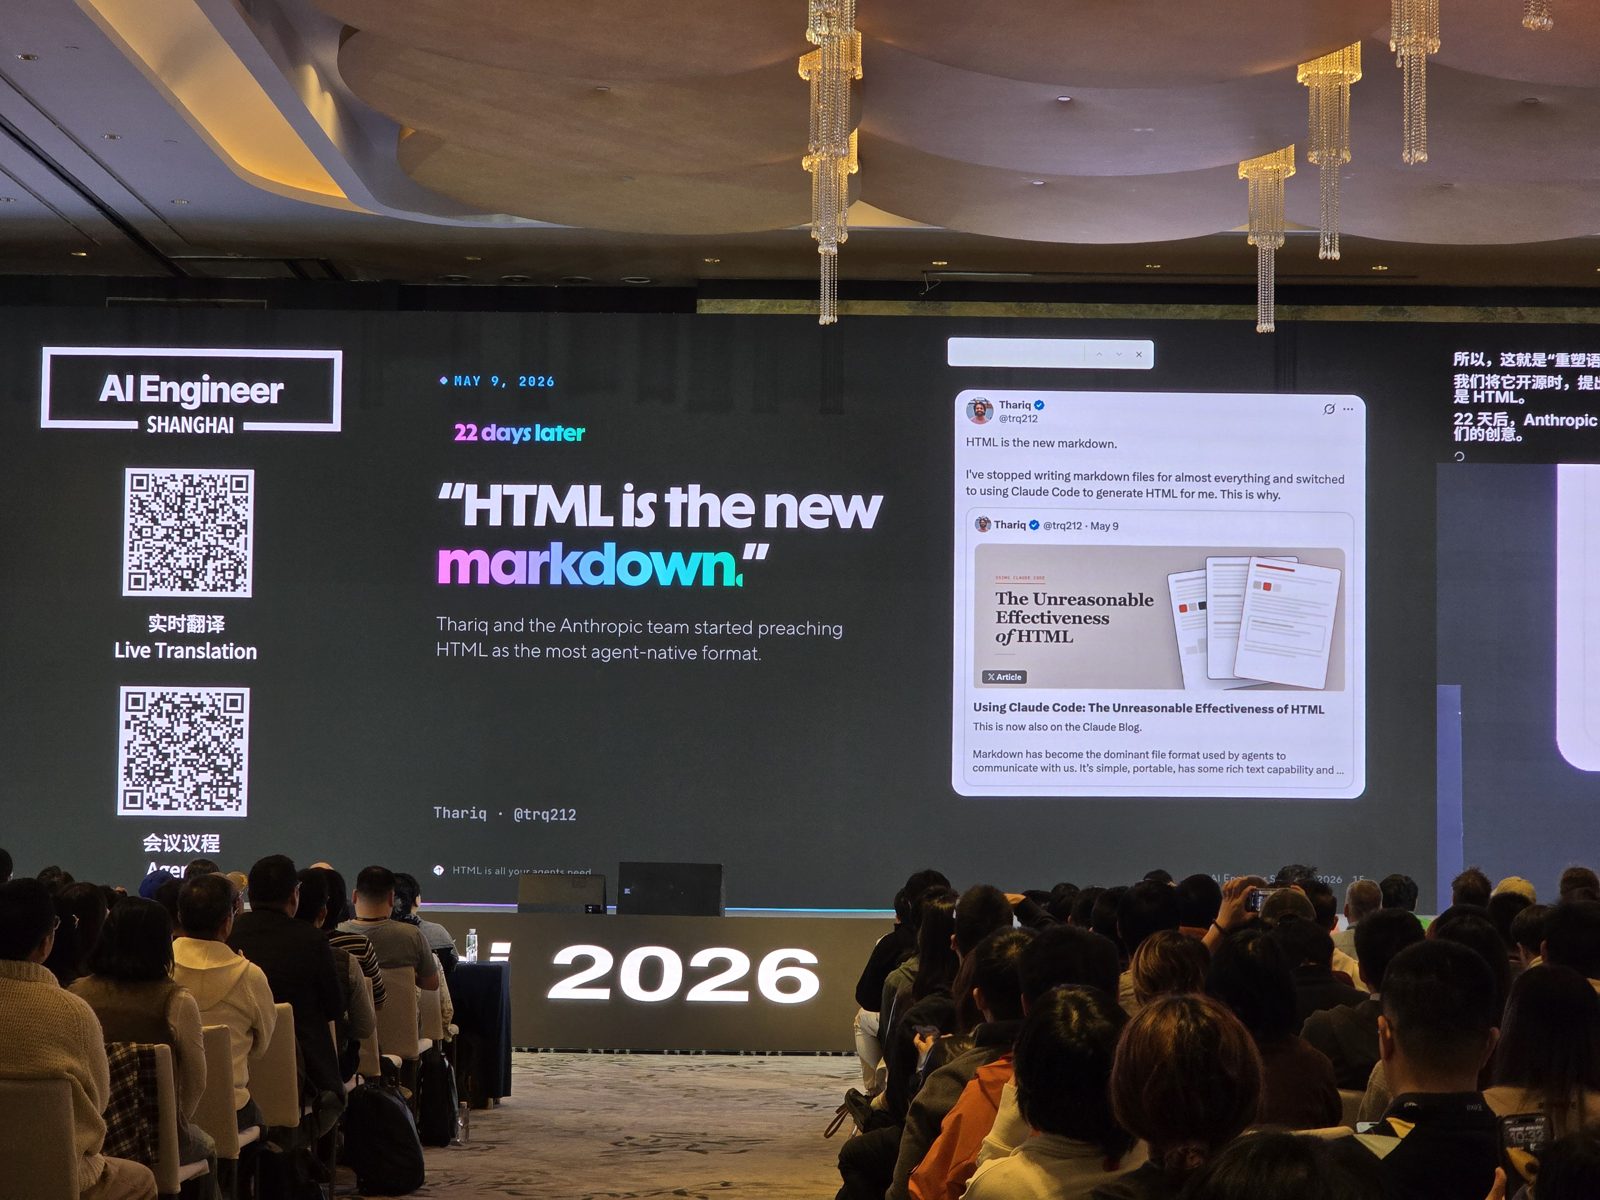
「22 天後」:Thariq 在 2026 年 5 月 9 日的貼文「HTML is the new markdown」,引用了 Claude 部落格的〈The Unreasonable Effectiveness of HTML〉。
AGI 是解碼,編碼才是護城河 — Ying Yang (CHILING CHUANYUE TECHNOLOGY)
Ying Yang 是腦科學博士,在創立美妝事業之前做過腦機介面。她說這門生意沒有拿外部資金,兩年做到 ¥1.9 億。她在各個帳號加起來也有大約一千萬名追蹤者。這是一場創辦人講策略的演講,圍繞著一個問題:哪些 AI 產品會被通用模型吞掉?
她的答案來自一個她歸功於指導教授的框架:科學負責編碼,工程負責解碼。植物學為植物編碼,調香把它們解碼。中心法則編碼了遺傳資訊怎麼流動,藥物設計把它解碼。神經科學描繪出各個腦區,BCI 則把它們的訊號解碼成指令。AGI 是到目前為止最強的解碼器,而解碼器在編碼最清楚的地方表現最好。她說這就是為什麼數學和寫程式最先被攻下:它們沒有模糊地帶。建在這塊地上的垂直應用都會被吸收掉。
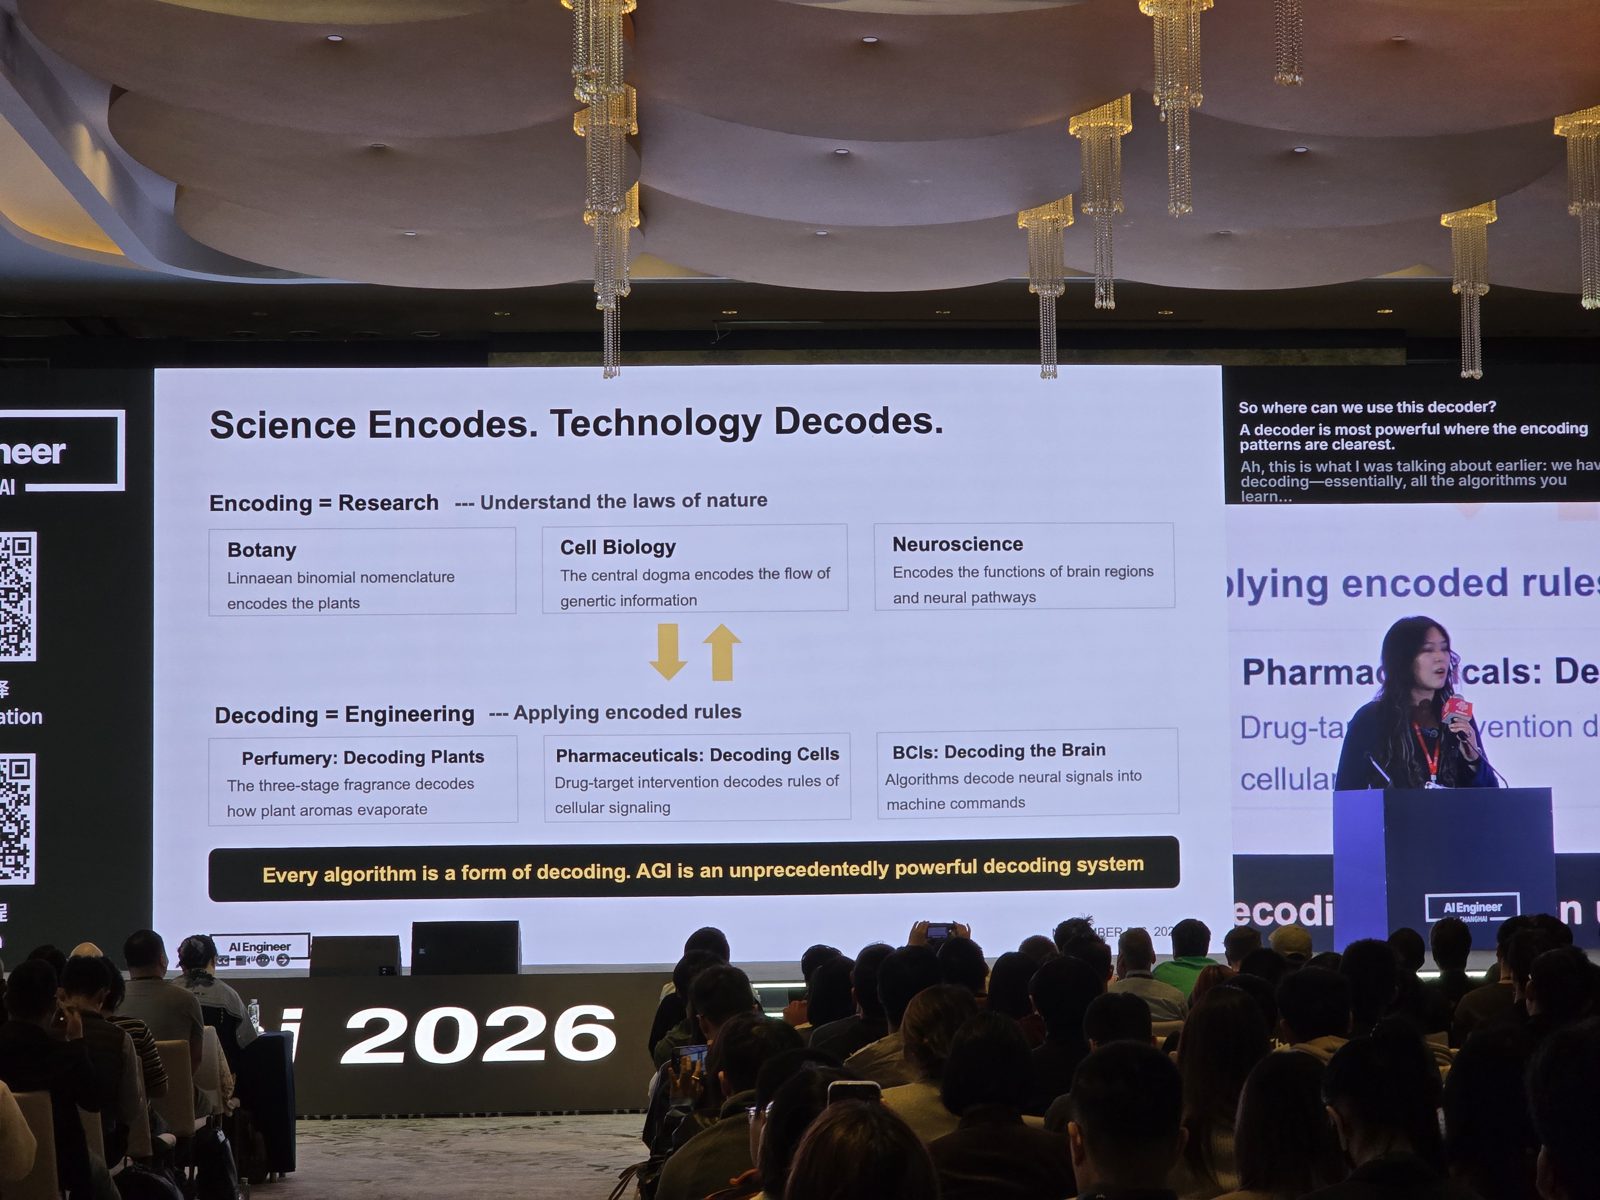
「科學編碼,技術解碼。」編碼那一列是植物學、細胞生物學和神經科學,解碼那一列是調香、製藥和 BCI。最底下那一行:每個演算法都是一種解碼,而 AGI 是前所未有的強大解碼系統。
她借用季辛吉的書 Genesis 裡的意象,說機會在「群島」:這些領域有一部分規則是已知的,但周圍是一片沒有人數位化過的隱性知識海洋。把這些知識變成規則和資料就是「填海造陸」,她認為填出來的陸地會變成 AGI 吸收不了的屏障。美妝就是她的群島。投影片上寫 2025 年中國美妝個護的 GMV 是人民幣 1.1 兆。她最倚重的數字來自自己經營品牌的經驗,也就是交易成本:一家美妝公司把大約 50% 的營收花在銷售上,就已經算是好公司了;有些花到 90%,根本沒有錢留給研發。
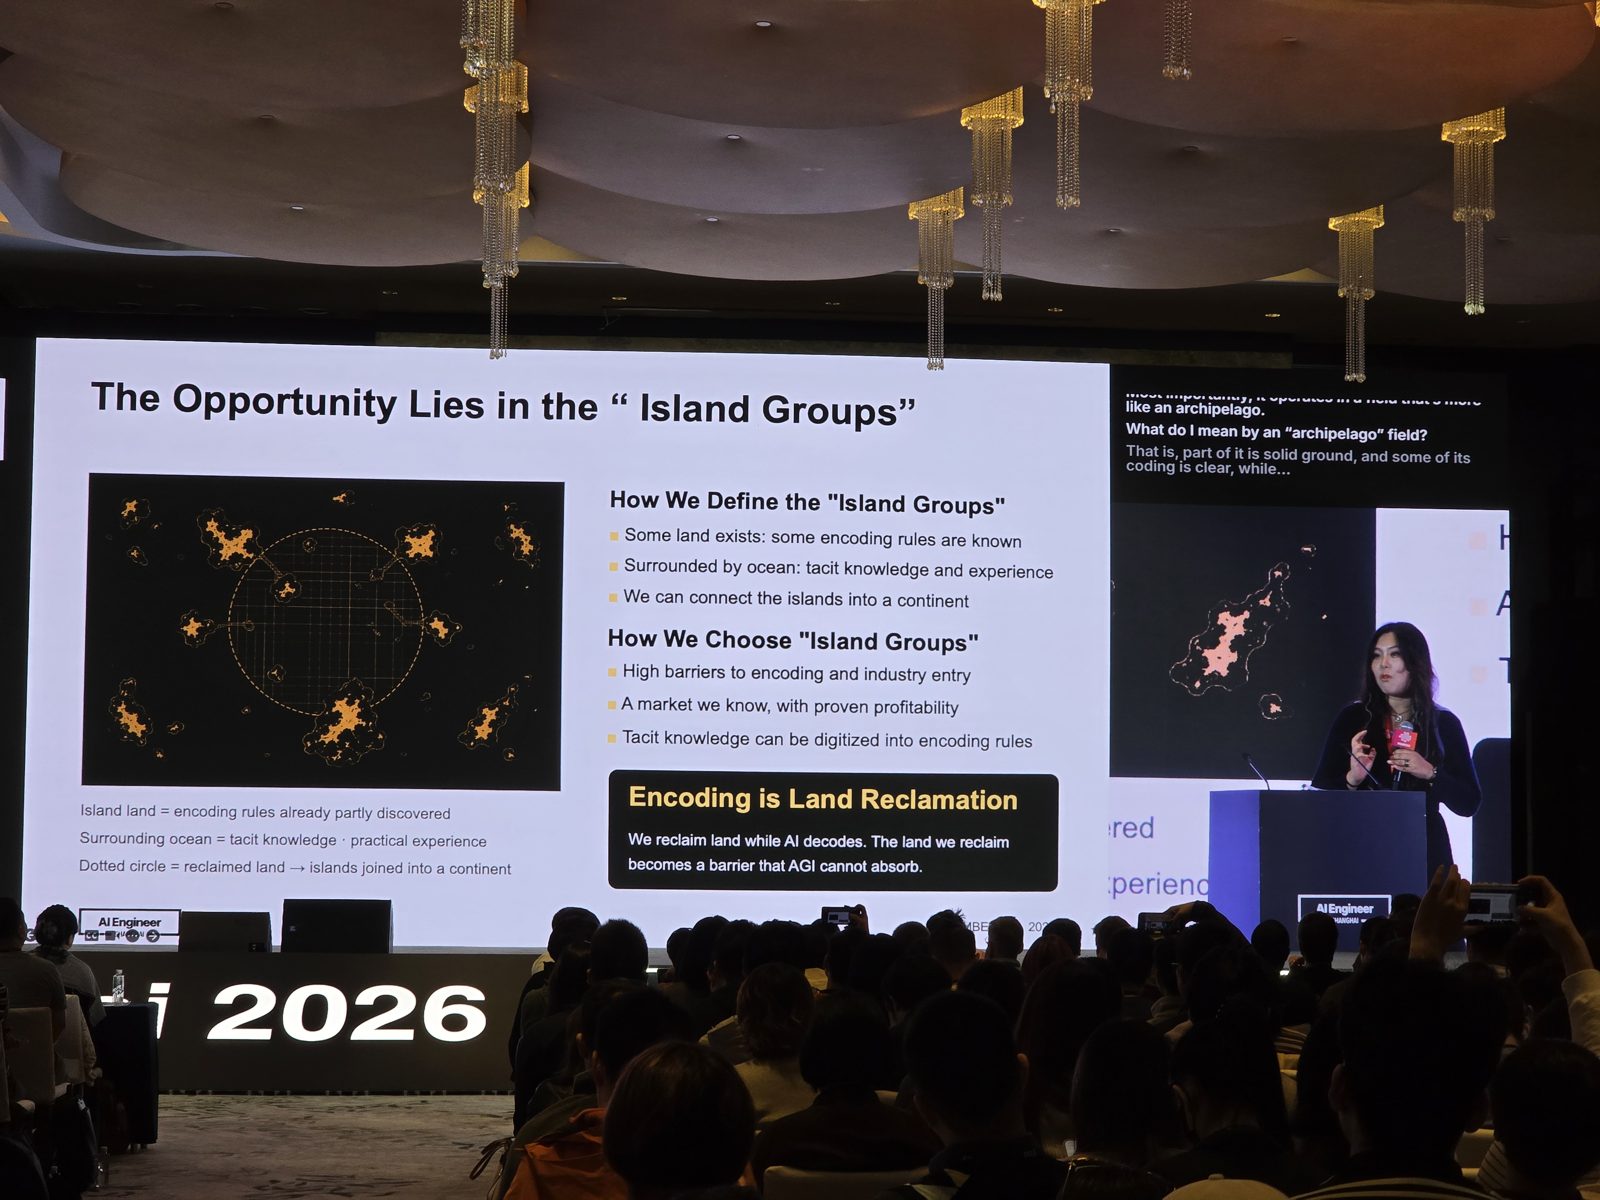
「機會在群島」:部分已知的編碼規則被隱性知識包圍,挑選的條件是進入門檻高、獲利已經被證明。「編碼就是填海造陸:AI 解碼的同時,我們在填海。」
她的計畫是從消費者開始,接著是小品牌、大品牌,最後是供應鏈。先做消費者,是因為要有一大群人在問保養問題,品牌才會願意分享資料。她的助理根據她所說的數千萬筆產品備案紀錄,以及一千多篇皮膚生理、配方和生化的論文來回答問題。每個問題都會記下一種膚質、一個偏好,或是使用者已經有的一項產品。
她反對用照片做膚質分析,她說那是不懂客戶的男工程師會做出來的產品。一張自拍只是一個雜訊很多、又受光線影響的樣本。她的投影片寫,用照片做的推薦準確率是 75%,而女性對自己的選擇滿意度超過 80%,還說大多數 25 歲以上的女性在半年內就知道什麼適合自己。她的比喻是沒有先經過駕駛輔助的階段,就直接做完全自動駕駛。她的 app 則是建立在這些經驗上:你把自己架上或店裡的產品拍下來,說你的皮膚有什麼反應,因為每項產品的成分表都是已知的,你的使用紀錄就成了訊號。
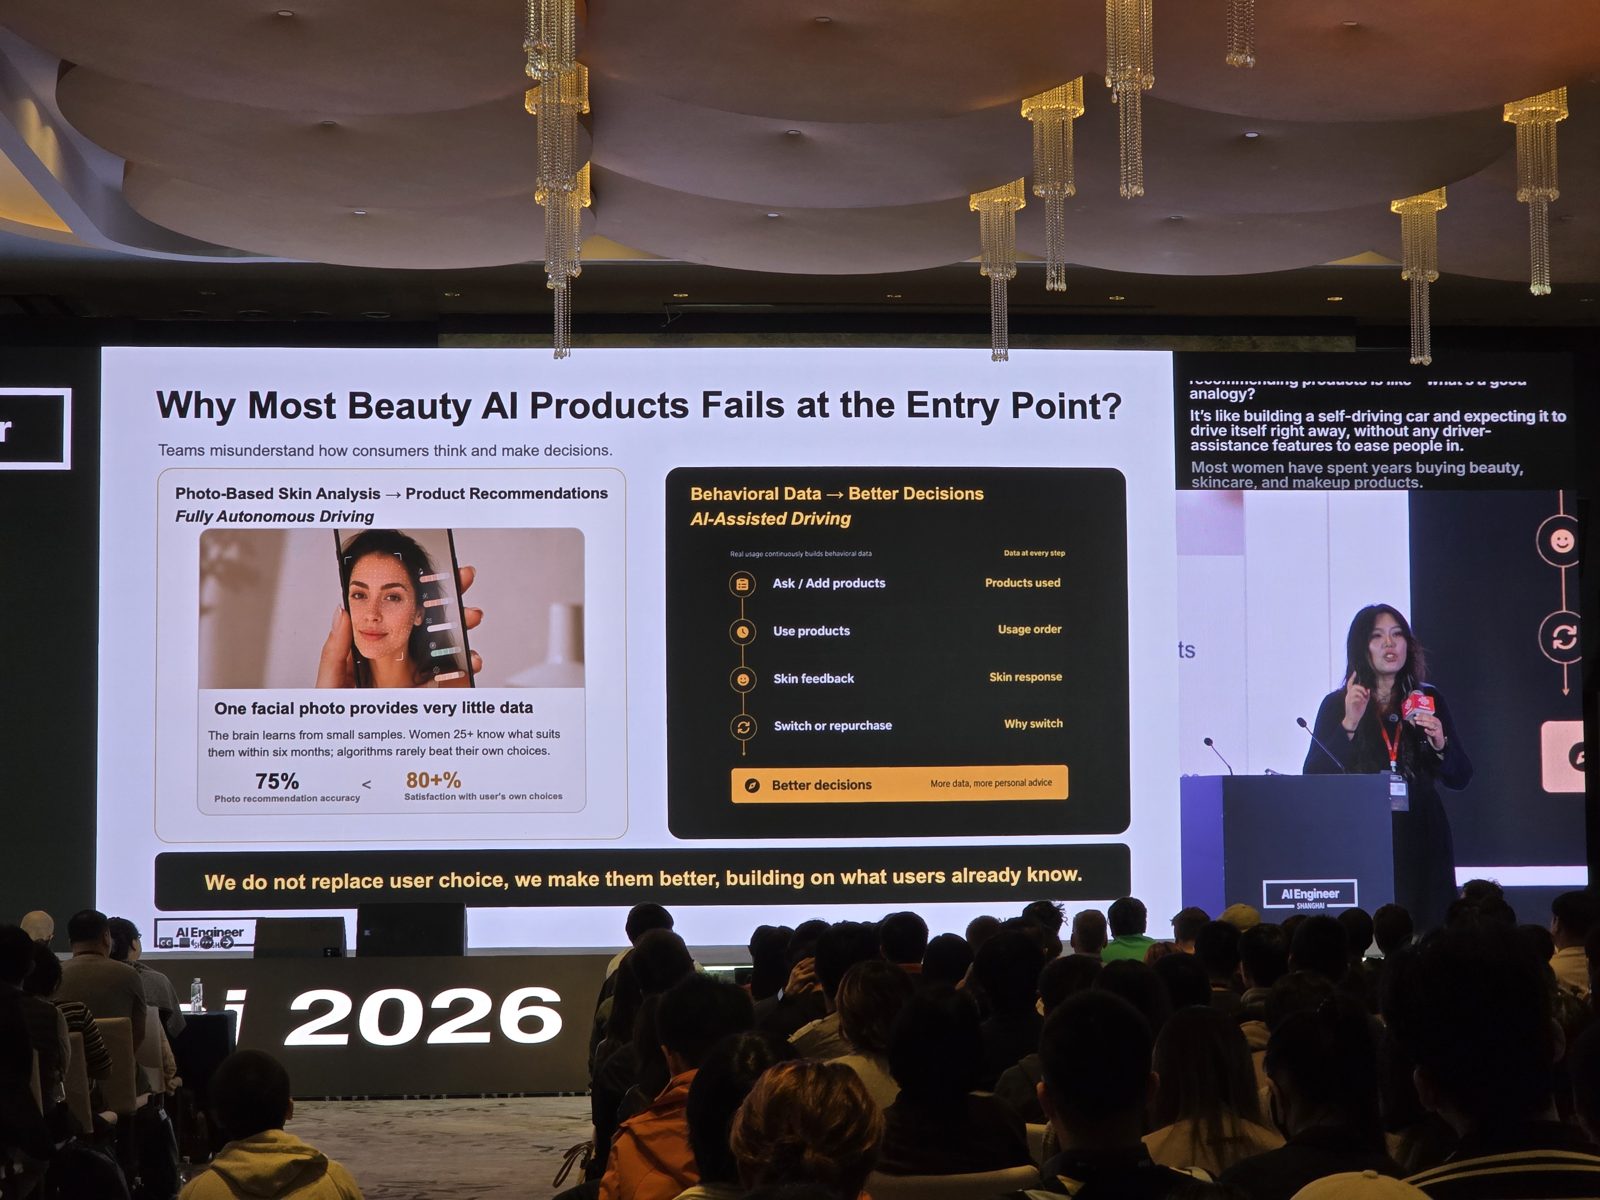
為什麼大多數美妝 AI 在入口就失敗:一張臉部照片,對上一份記錄用過的產品、使用順序、皮膚反應和換用原因的紀錄。「我們不取代使用者的選擇,而是讓他們選得更好。」
第二步是把專家型的創辦人放進 app 裡。她舉的例子是冰寒,同濟大學的皮膚科博士,自己寫書、自己做配方,也賣自己的產品線。他的 AI 分身根據他的書、論文和測試資料回答痘痘和酒糟的問題,然後推薦他的產品。大品牌則把這一個人的角色拆給科學家、配方師和不同的產品線,平台再把它們合併成一個品牌 agent。品牌提供資料,換來的是一個顯示消費者在問什麼的 dashboard,以及廣告工具。她說 L’Oréal 開發一個產品要 24 個月,資生堂要 22 個月,而真實的需求資料可以縮短這段時間,也能終結她描述的那種追流行:大家一窩蜂做玻尿酸,接著是膠原蛋白,然後是 PDRN。
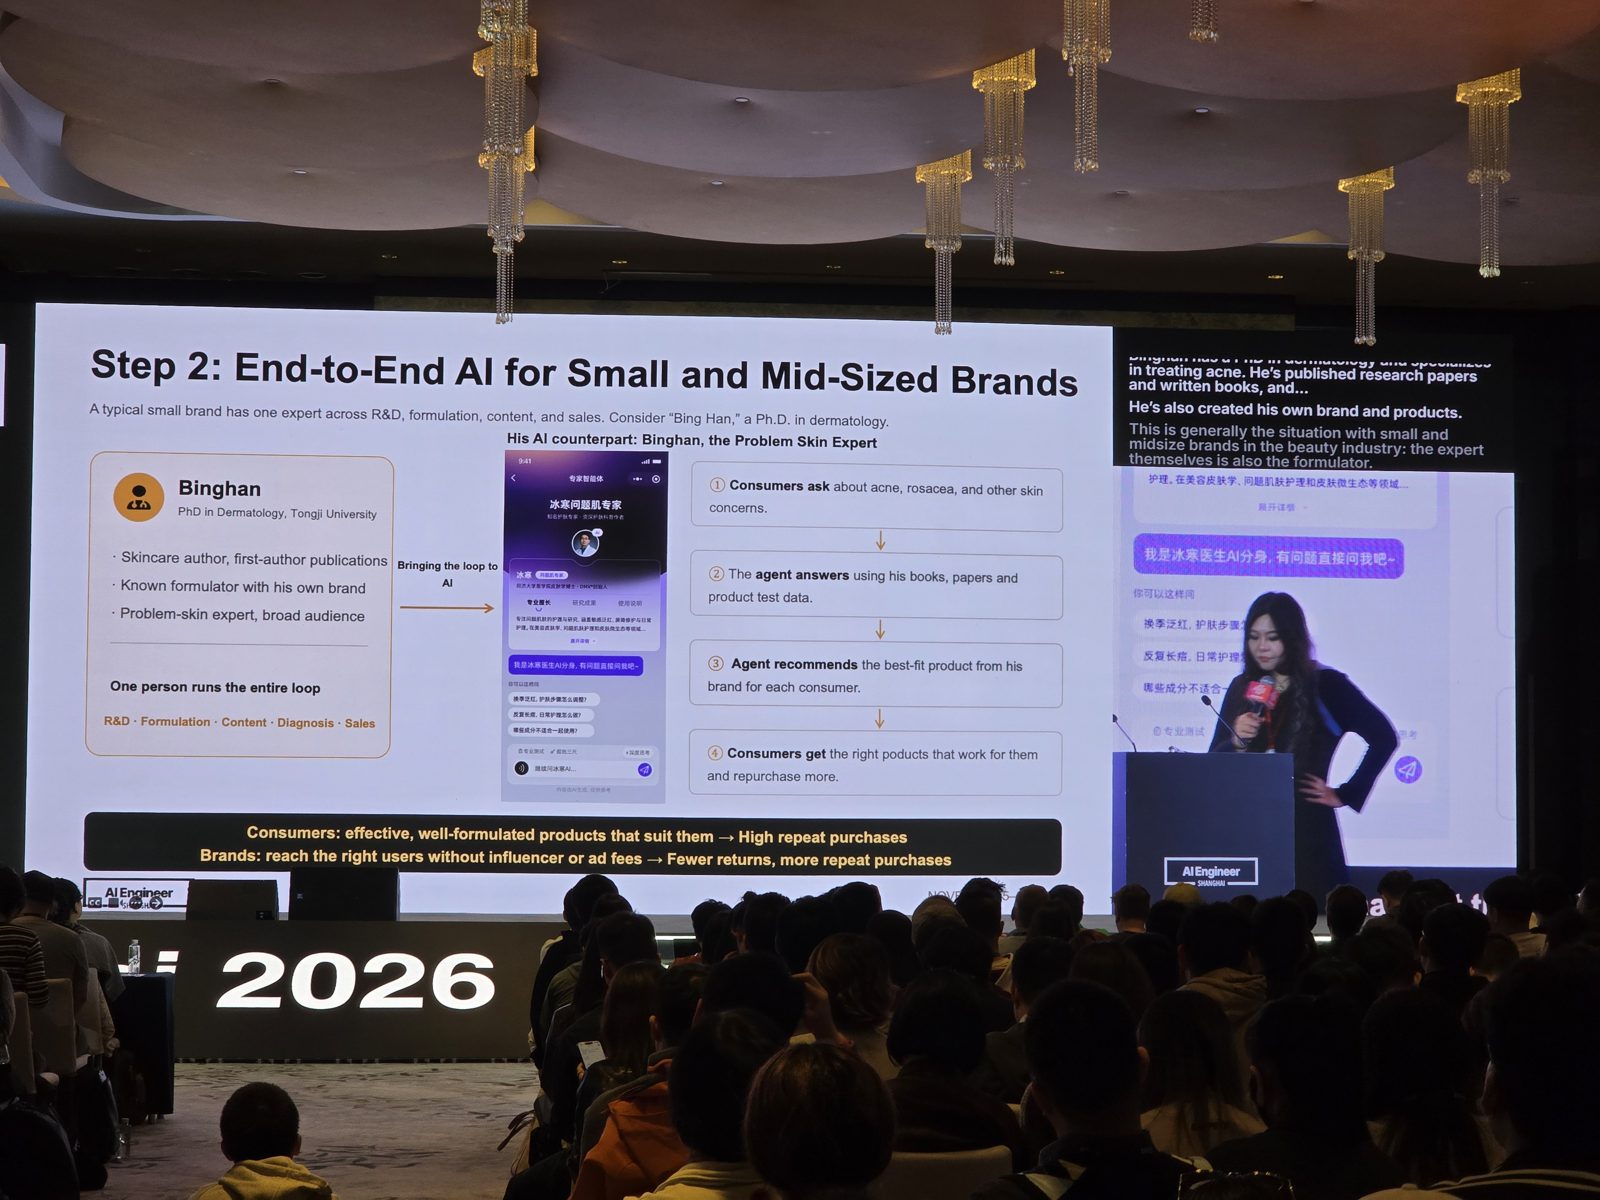
第二步:一位專家包辦研發、配方、內容、診斷和銷售;他的 AI 分身「冰寒問題肌專家」根據他的書和測試資料回答問題,推薦的是自家品牌的產品。
AI 在製造業:行百里者半九十 — Shihui Zhu (HICAP Group)
Shihui Zhu 負責 HICAP 的軟體部門。HICAP 有六座工廠,中國大部分大型酒類品牌的瓶蓋都是他們做的。他一開場就說自己是外行,是自己跑來參加這場 AI 研討會的。他的題目是一句老話「行百里者半九十」:一百里的路,走到九十里才算一半。他的論點是,AI 能讓製造業很快做出 demo,但最後那十里路跟模型沒什麼關係。
他帶了自家導入的數字。HiWork 是他們內部的 AI 工作平台,架在所有舊系統上面,跑了 50 多個 agent。每個月處理 85 萬次業務呼叫,大約 1,167 億個 token。他們先在寫程式上把它跑起來,再一個需求一個需求推到六座工廠。
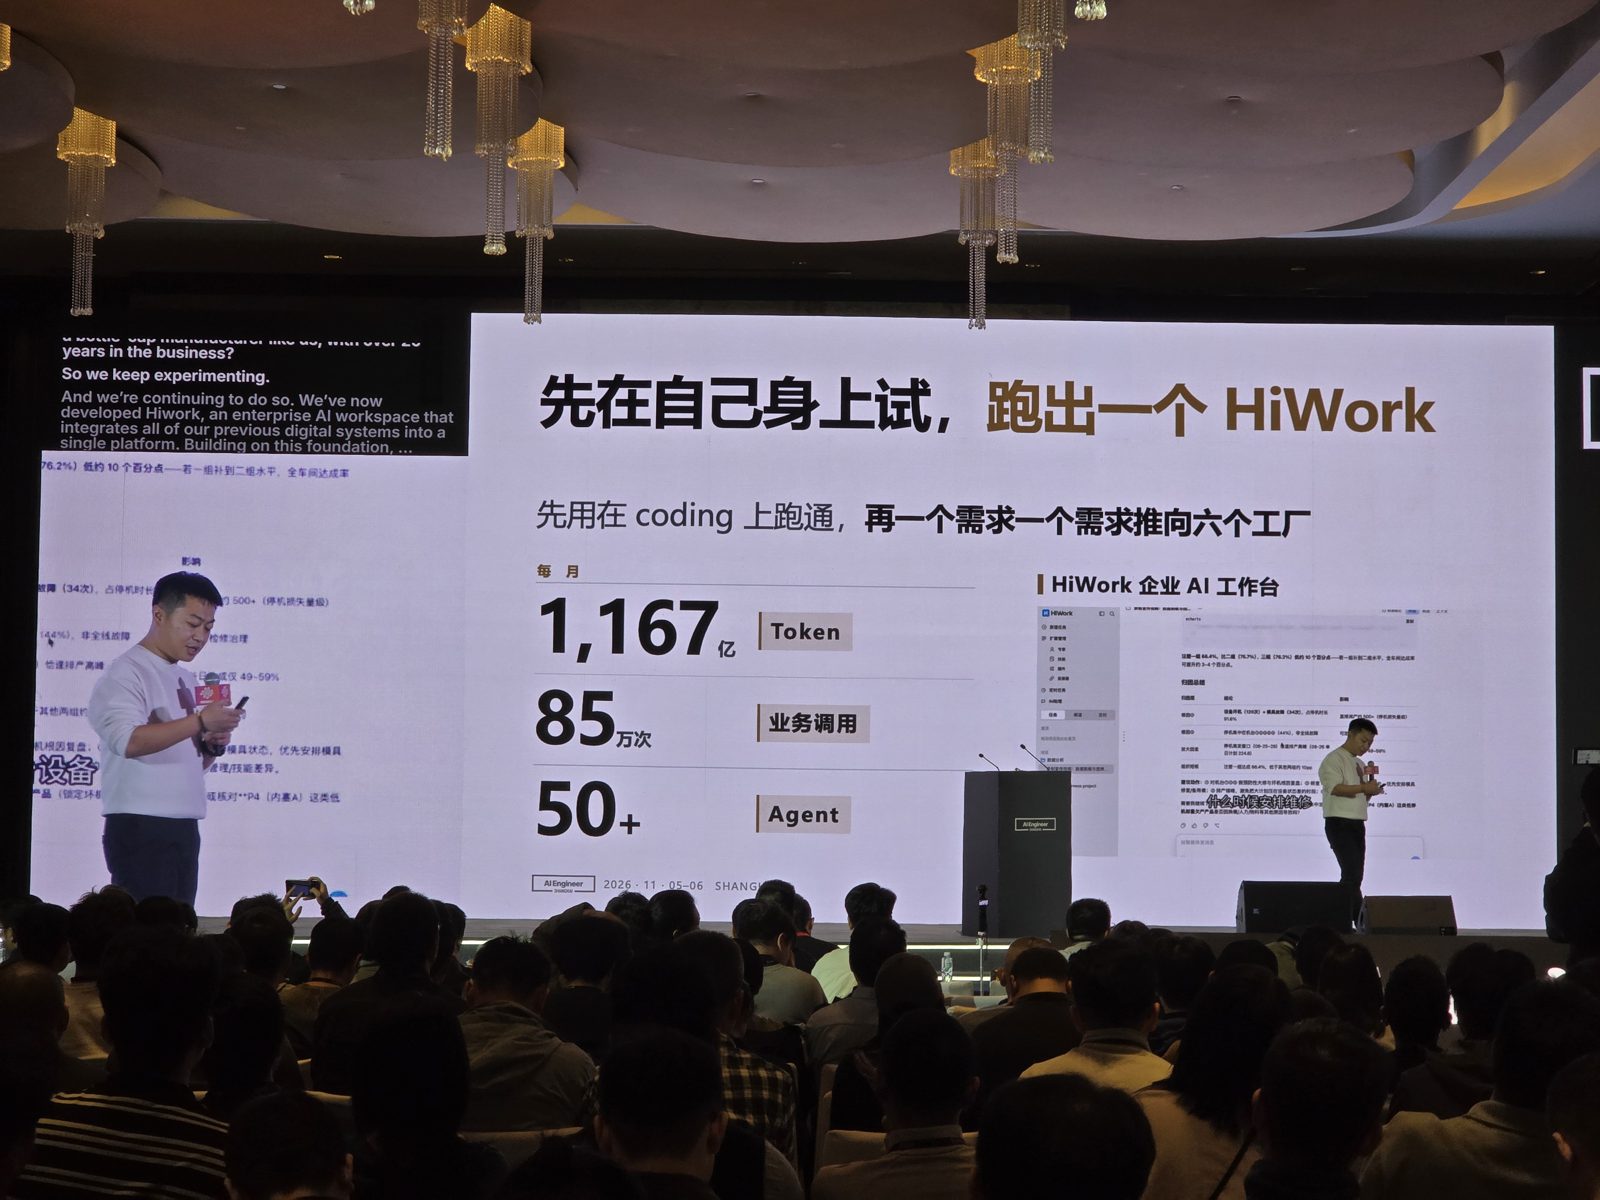
HiWork,先在自己身上試:每月 1,167 億 token、85 萬次業務呼叫、50 多個 agent,先在寫程式上驗證,再一個需求一個需求推到六座工廠。
演講大部分在講為什麼模型不是瓶頸。他把企業導入 AI 比喻成翻修一棟樓:地基是 ERP、CRM 和 MES,上面是一層由物件、流程、指標和規則組成的「本體」(ontology),最上面才是 agent。本體是最難的部分,他說市面上沒有人在賣這方面的好產品。在工廠裡,機台老舊,訊號讀不出來,一線員工超過一半在 40 歲以上,批號還寫在紙卡上。某一天實際發生的事(供應商少交貨、客戶把交期提前、機台壞掉),最後只會變成聊天群組裡的一張照片,系統裡只有計畫。
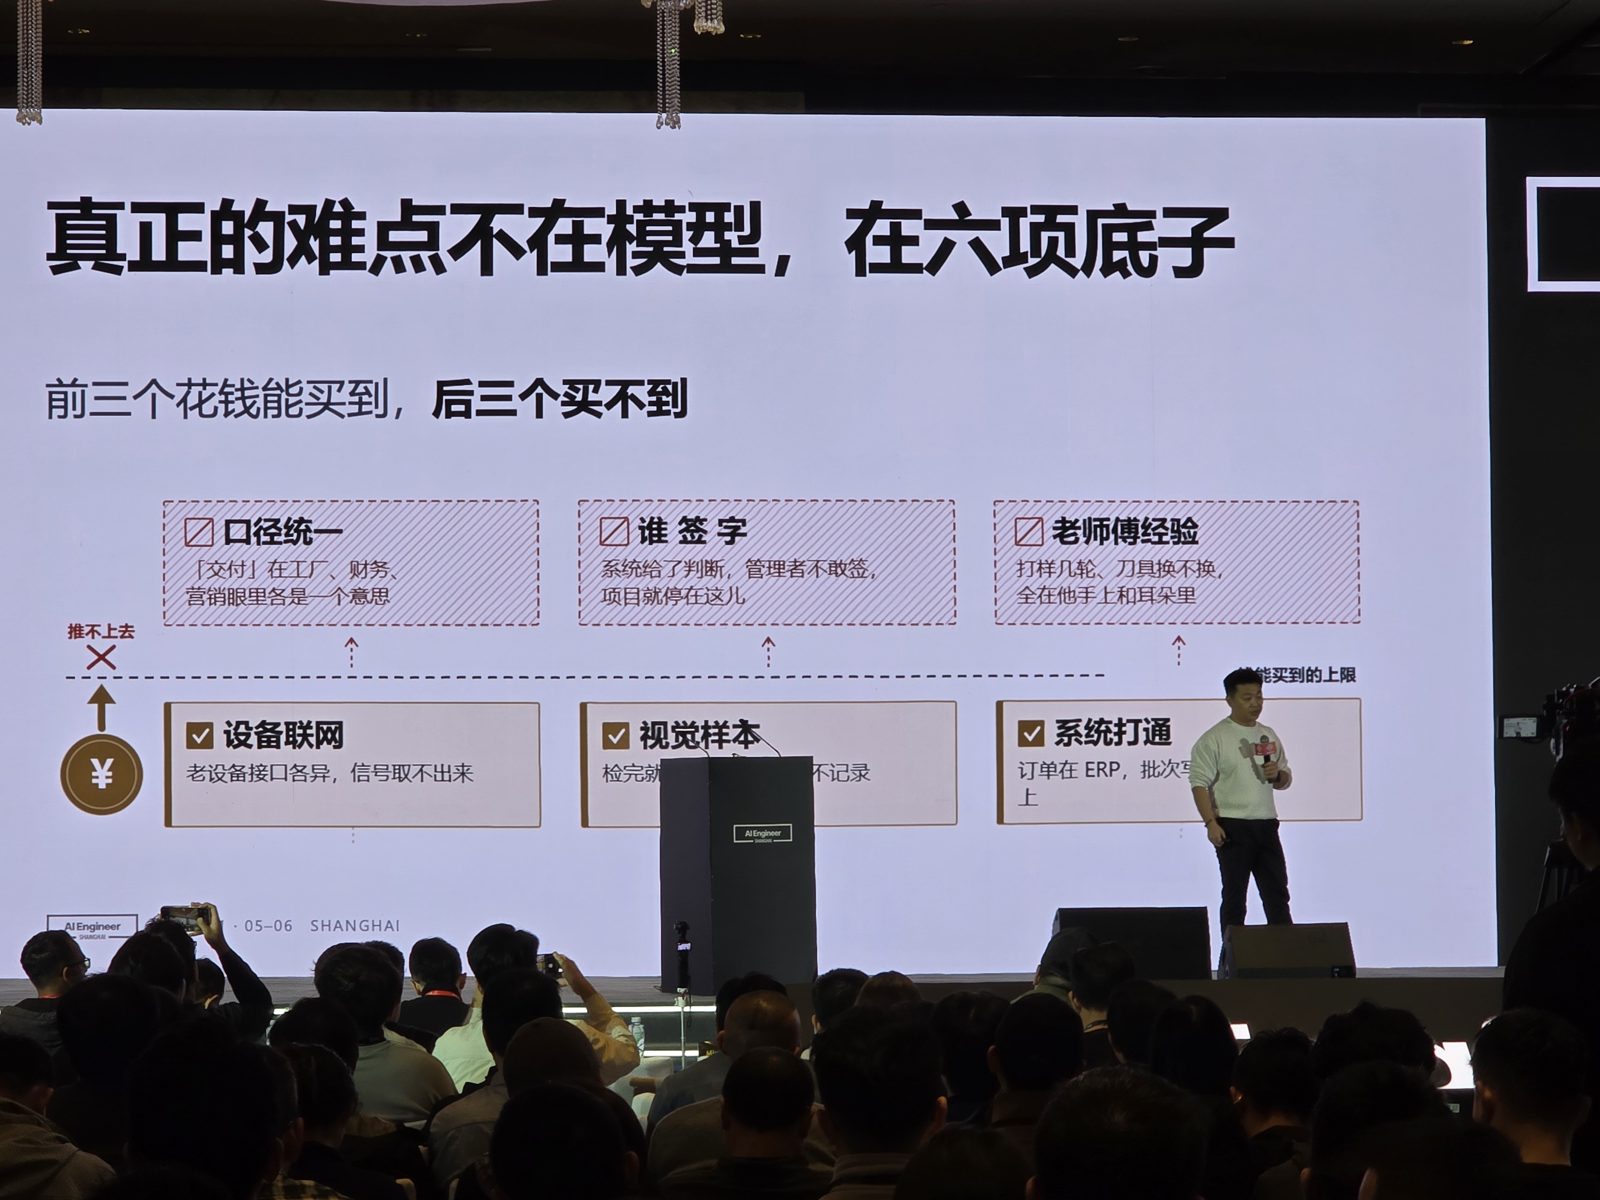
「難的不是模型,是六個地基」:設備聯網、視覺樣本和系統整合買得到;一詞一義、有人願意簽字、老師傅的經驗買不到。
上面這張投影片是他的總結。錢買不到的是:像「交付」這種詞的單一定義(它在工廠、財務和行銷各有不同的意思)、一位願意替系統的結論簽字的主管,還有知道什麼時候該換刀具的老師傅的經驗。他補充說,語意沒統一的時候,更強的模型只會更有自信地給出錯誤答案,所以他們會記錄每個定義為什麼改。
挑專案時,他們把每個需求放在兩個軸上評分:對財務的影響是直接還是間接,回報是快還是慢。早期的成果:費用報銷每個月省下 580 小時,合約審查從幾小時縮短到幾分鐘。接著他引用 Goldratt 的《目標》(The Goal):在非瓶頸環節省下的時間只是幻象。真正的槓桿是生產排程,用同樣的人和機台做出更多產出。而它落在「想清楚再動」那一格,因為交期常常只是口頭承諾,物料的前置時間不清楚,有些模具只能上某些機台。
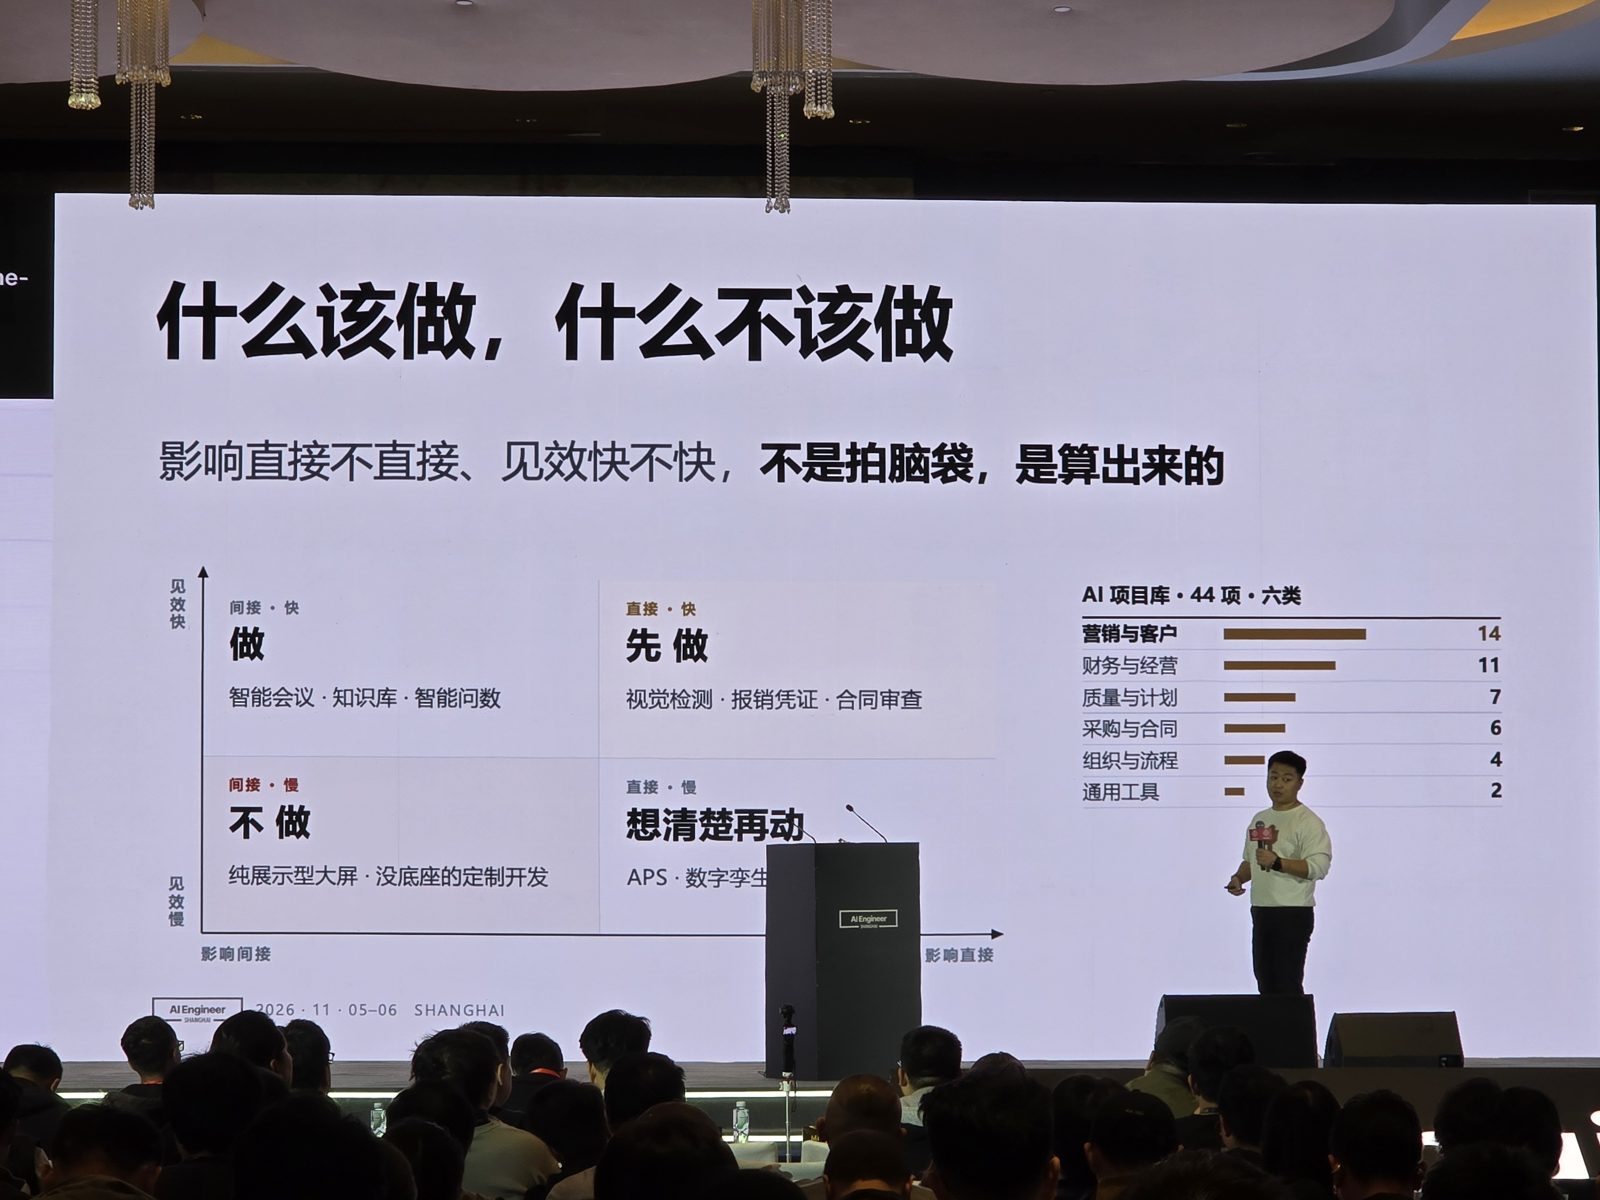
依影響(直接或間接)和回報速度分類專案:視覺檢測、費用憑證和合約審查先做,APS 和數位孿生之後再做,只能看的大螢幕永遠不做。右邊:六大類共 44 個專案,其中 14 個是行銷。
他的結論是,難的不是讓 AI 排程,而是把每一步依賴的規則寫下來。他給的答案是先把計畫系統一步一步建起來。
現在工人用手機講話回報現場事件,語音會變成結構化的紀錄,再派給負責人。
信任我讀不懂的 eval — James Hush (Daily.co)
James Hush 在做 Pipecat,也就是 Daily 的開源 voice agent 框架(他在台上說「我在 Deepgram」,Deepgram 前一週剛宣布要收購 Daily)。他在亞洲住了六年,太太是台灣人,面對上百種飲料的手搖飲菜單,他只會點一樣:珍珠奶茶。於是他做了一個 voice agent 來教自己點飲料。麻煩的是他看不懂中文,所以他自己的測試有一半他讀不懂。
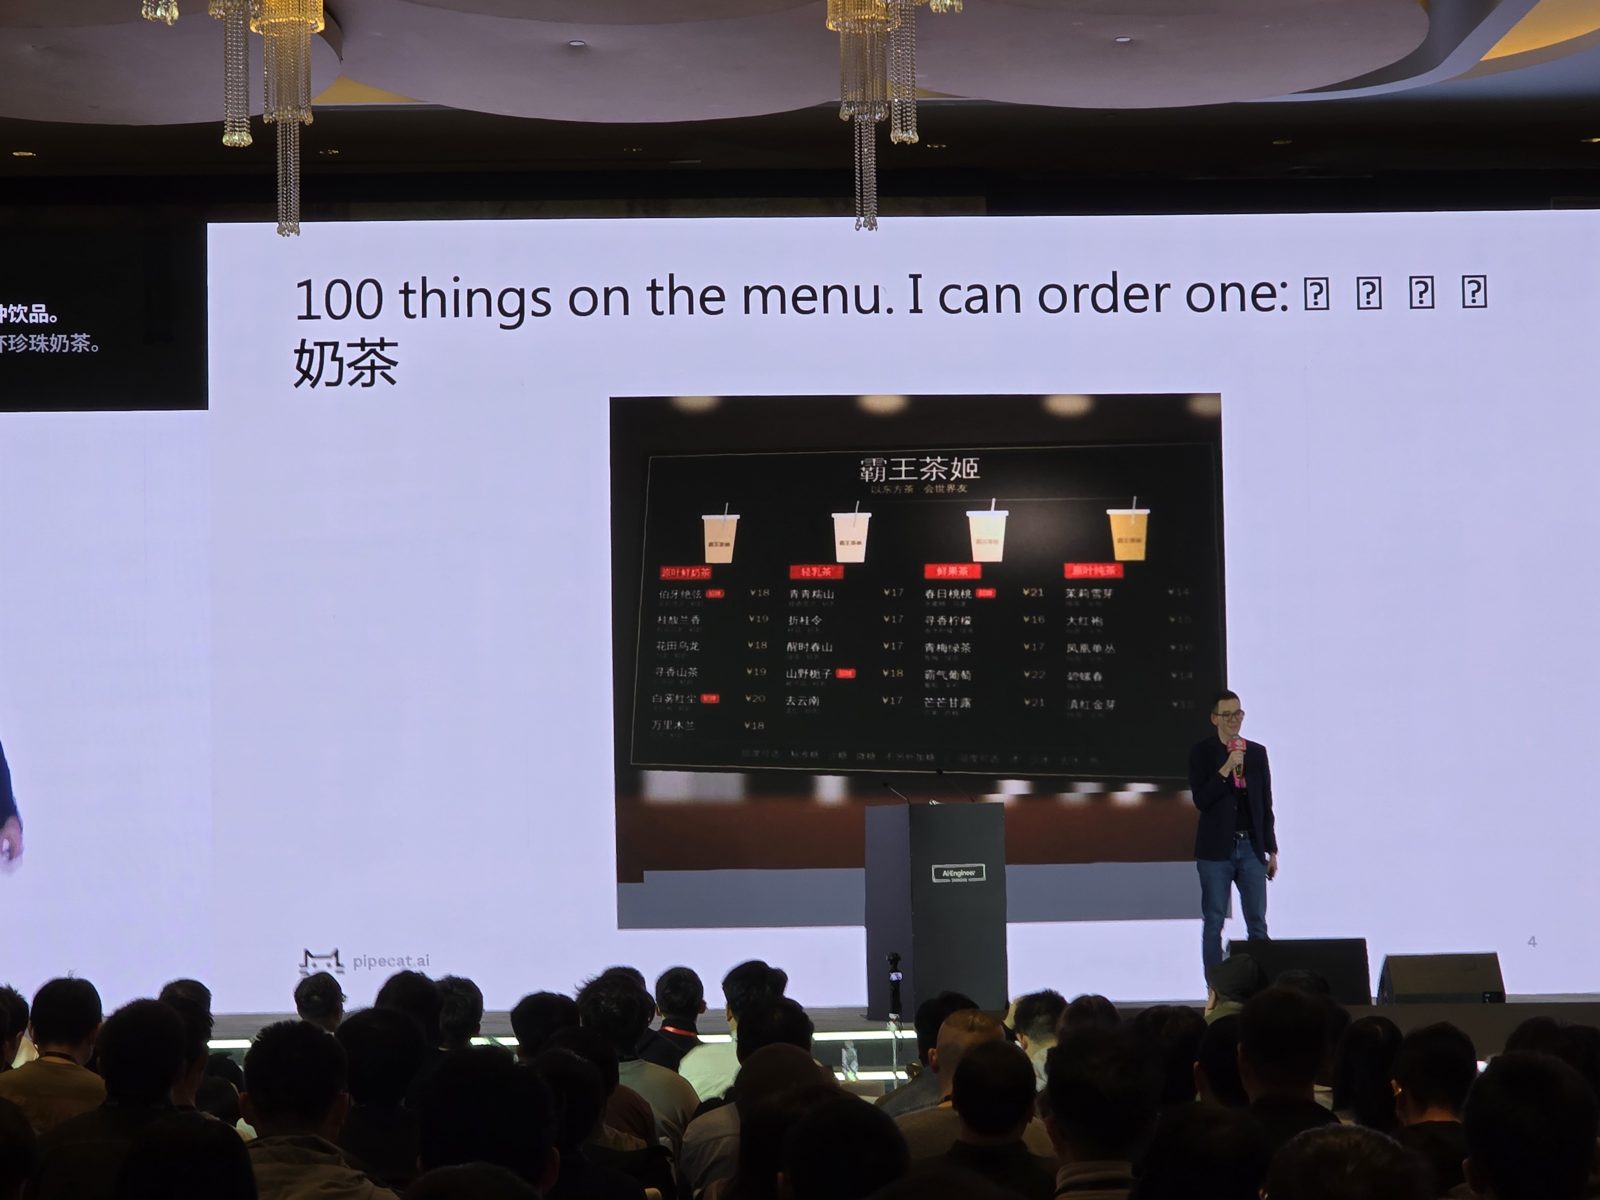
出發點:一份大約一百種飲料的手搖飲菜單,和他唯一會點的那一杯,珍珠奶茶。
接著他把這件事推廣出去:在場的人已經沒有誰讀得過來了,不管是哪種語言。有一張投影片把一個「claude-agent」帳號送到 Pipecat repo 的 pull request(214 個 commit,1,342 個檔案,+52,417 行、−18,903 行),和一個 999+ 則未讀的 WeChat 收件匣放在一起。他的答案是不再檢查工作成果,改成檢查那些檢查,用 LLM 去檢查別的 LLM。他用英文寫檢查,Claude 或 ChatGPT 用 Python 寫程式,他預期 2027 年每個應用程式開發者都會這樣工作。
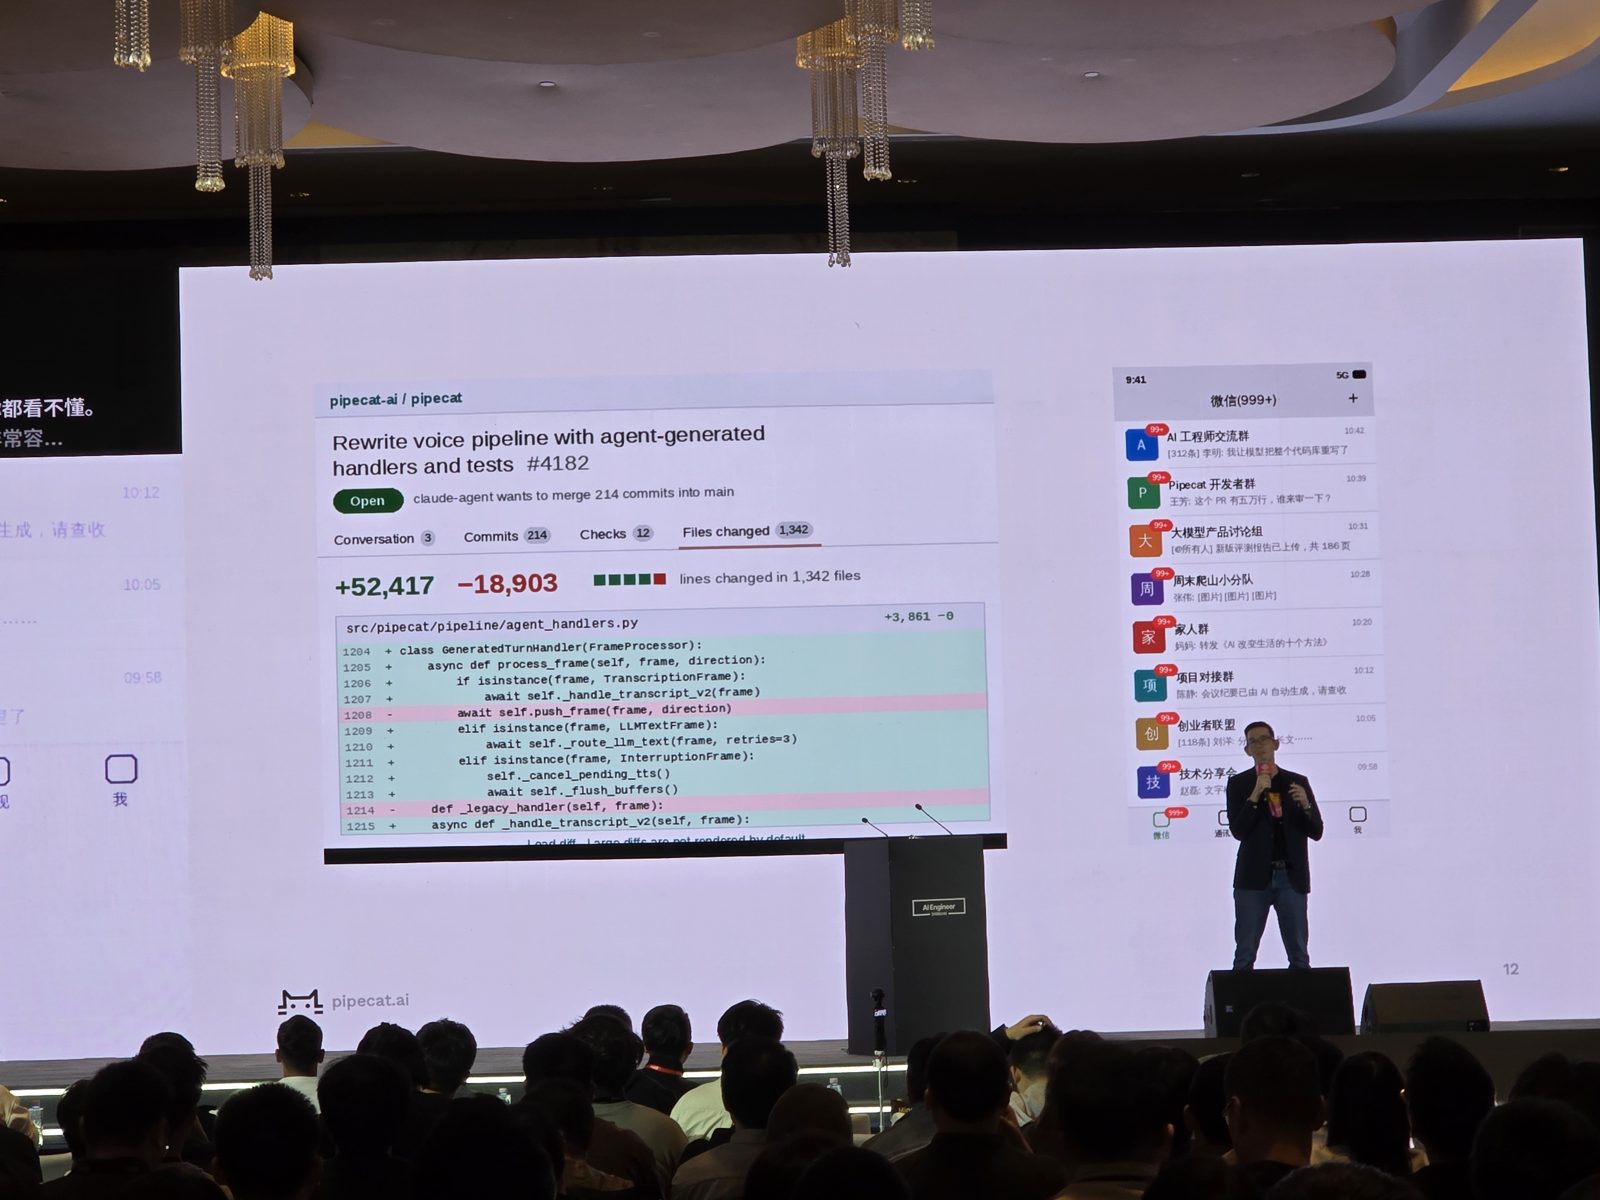
為什麼沒人讀得過來:一個由 agent 產生的 Pipecat PR,214 個 commit、改了 1,342 個檔案,旁邊是一個 999+ 則未讀訊息的 WeChat 列表。
Voice agent 是一條 pipeline(音訊傳輸、語音轉文字、LLM、文字轉語音、再傳回去),Pipecat 是不綁定廠商的膠水層。Claude 照著 Pipecat 文件,大約 30 分鐘就做出第一版。手動測試代表每改一次就要從頭講完一整筆點單,所以他把它包進一個 agent loop。Judge 是一個 LLM,讀完一段結束的對話後回答一個是非題,例如 agent 有沒有禮貌。Eval 會讓 agent 跑 10 次、20 次或 100 次,回報通過率,因為 voice agent 從來不會兩次表現一樣。Scripted eval 像單口喜劇,每次講的都一樣。Simulation 像即興劇:另一個 LLM 扮演拿不定主意的客人,講的是他讀不懂的中文,再用他用英文寫的成功條件來評分。
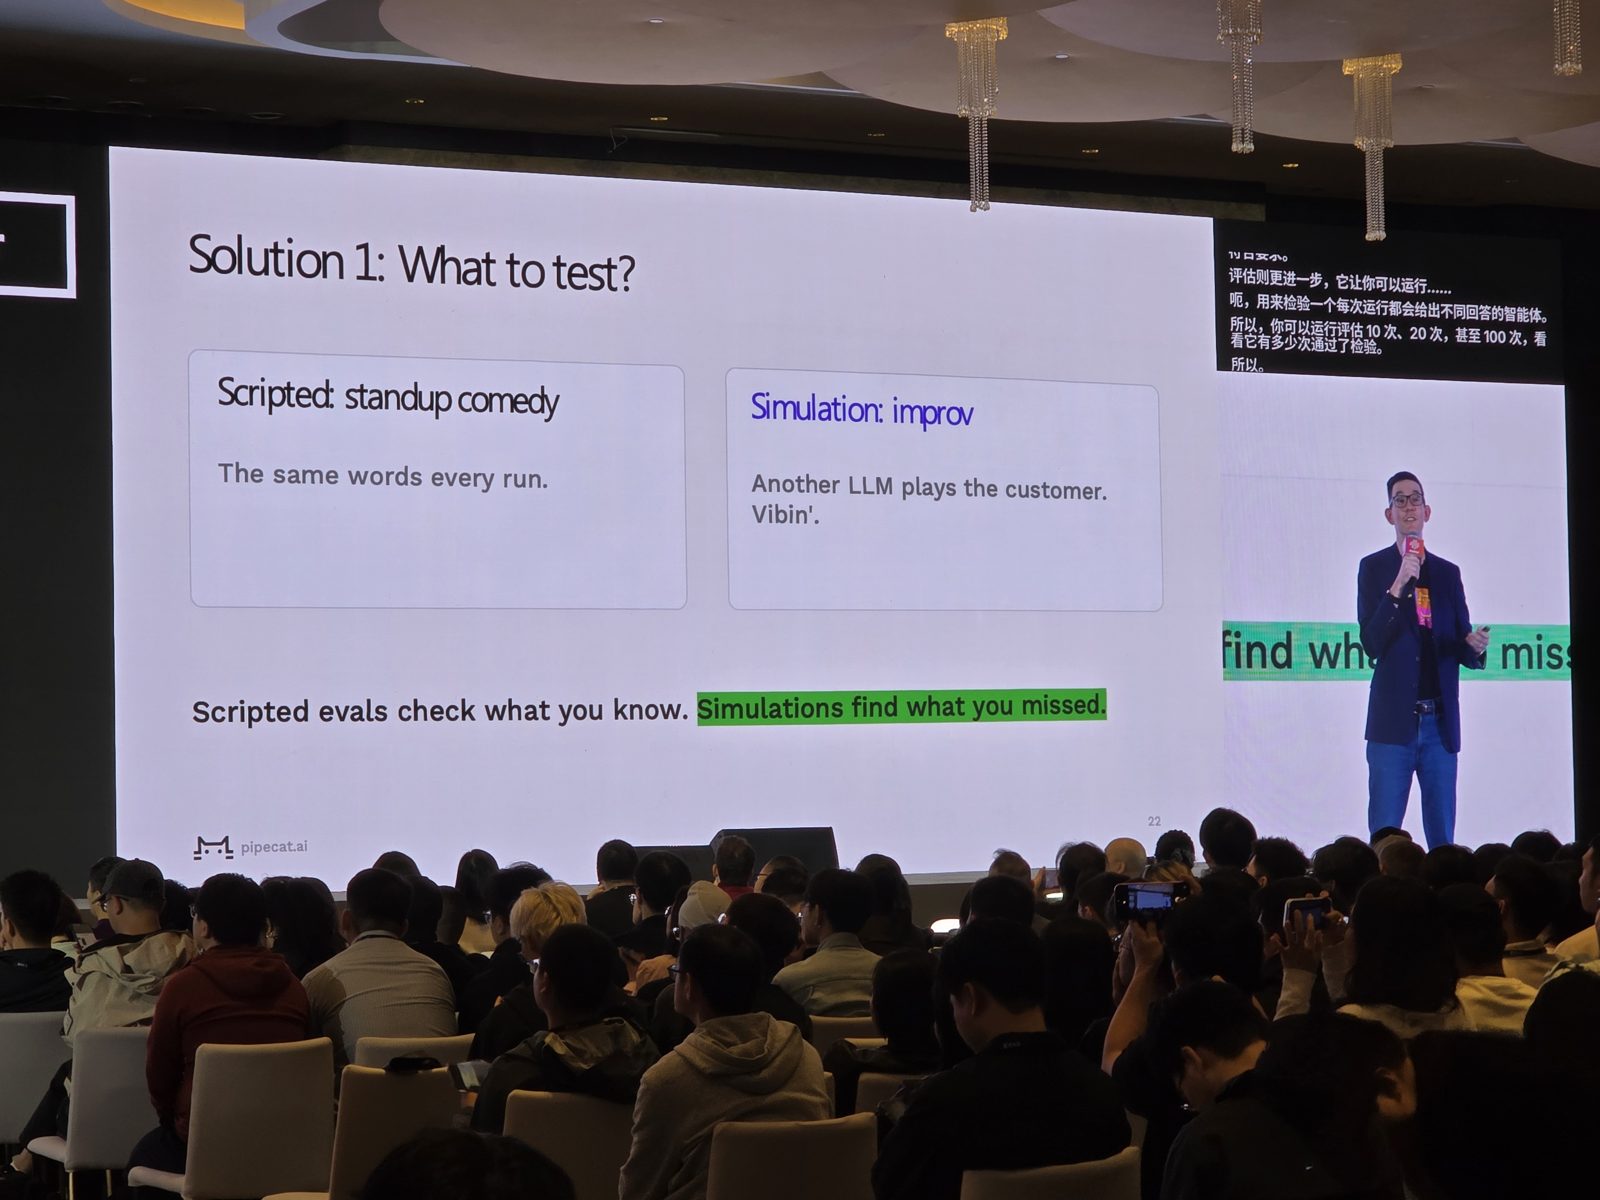
Scripted eval 像單口喜劇(每次都是同樣的台詞),simulation 像即興劇(由另一個 LLM 扮演客人):「Scripted eval 檢查你已經知道的,simulation 找出你漏掉的。」
文字模式跳過音訊,搭配本地的 judge 幾乎不花錢。音訊模式抓到了一個 bug:語音轉文字把「去冰」聽成「two 瓶」,也就是中英夾雜的「兩瓶」。純文字的測試看不到這種問題。
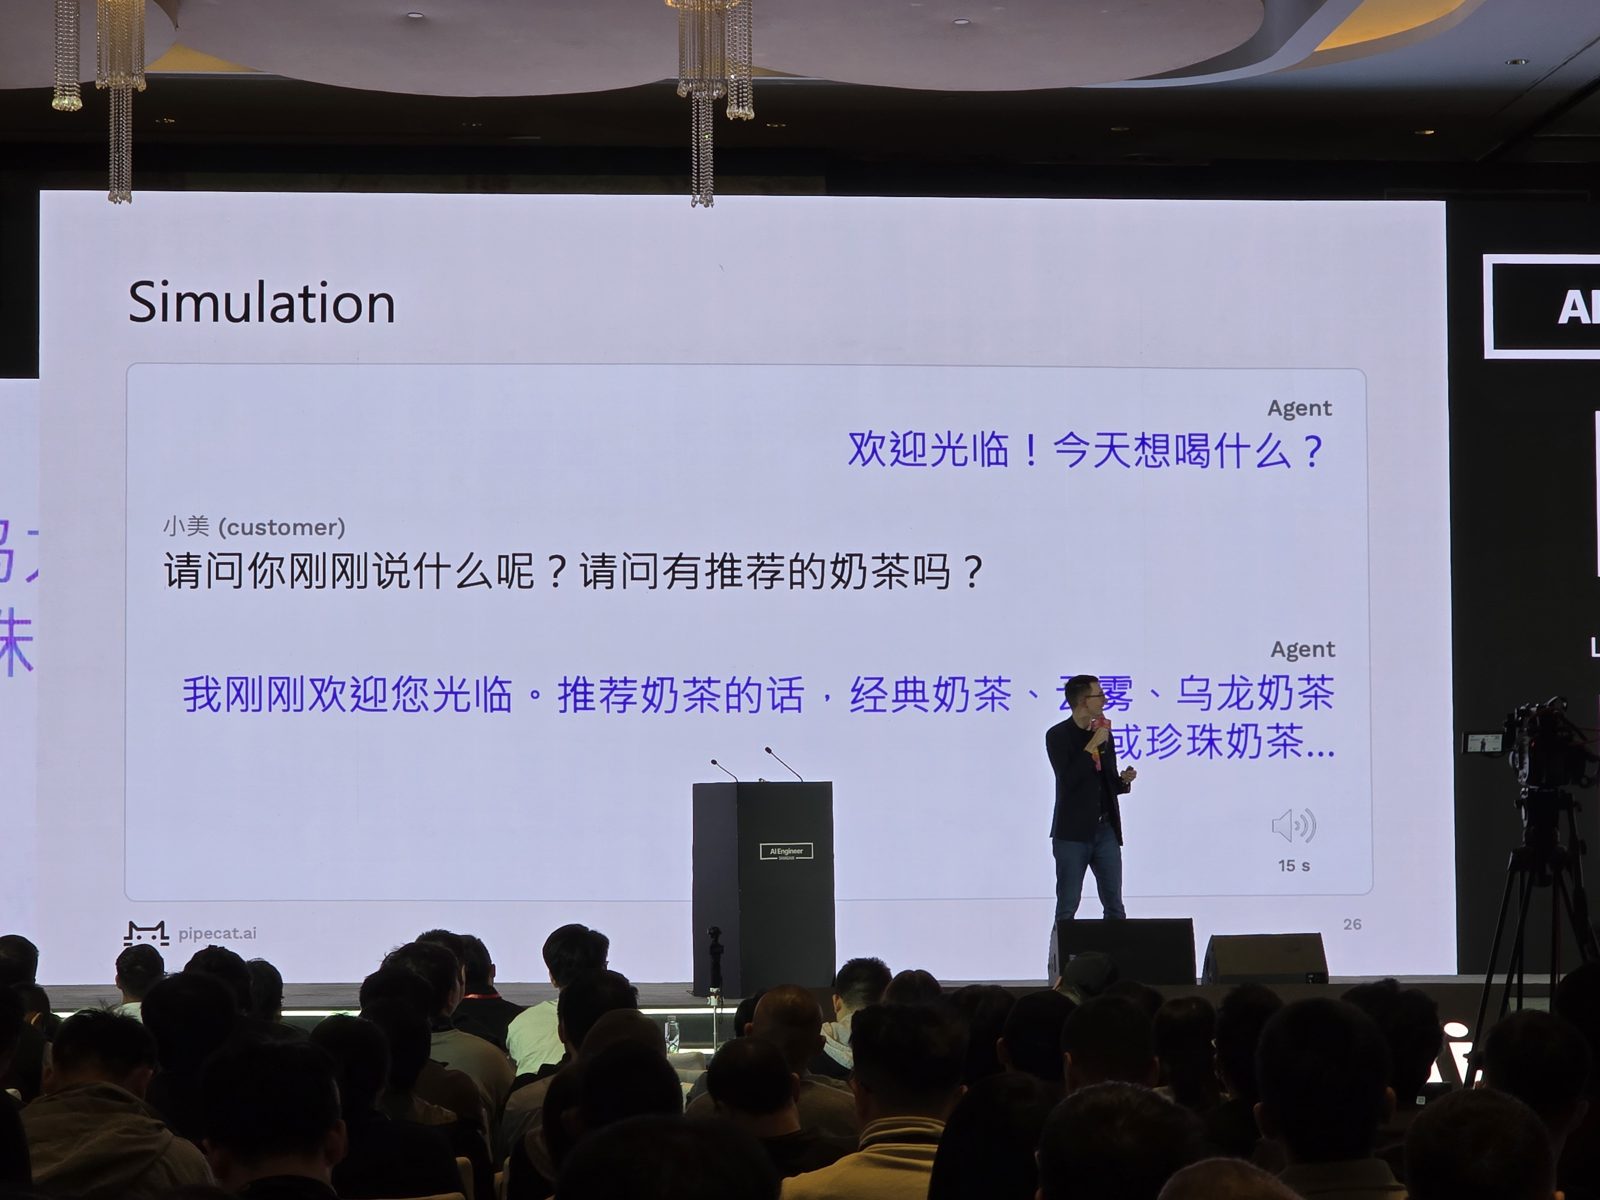
音訊模式的 simulation:agent 歡迎客人,模擬客人小美問它剛剛說了什麼,能不能推薦一杯奶茶。
好的、壞的、醜的:3,000 場即時練習教會我們的串流語音轉文字 — Satvik Sinha (AICET, NUS)
Satvik Sinha 負責 AICET 華語口說練習 app 裡的 voice agent,app 裡有一位叫 Laoshi 的家教跟學生對話。他一開始先播了一段學生結結巴巴的回答,再秀出即時逐字稿,裡面出現了「Shanghai」。她根本沒說這個字。他們的練習 session 大約每四場就有一場,逐字稿裡出現沒人說過的內容:別種語言的文字、錯字、漏字。
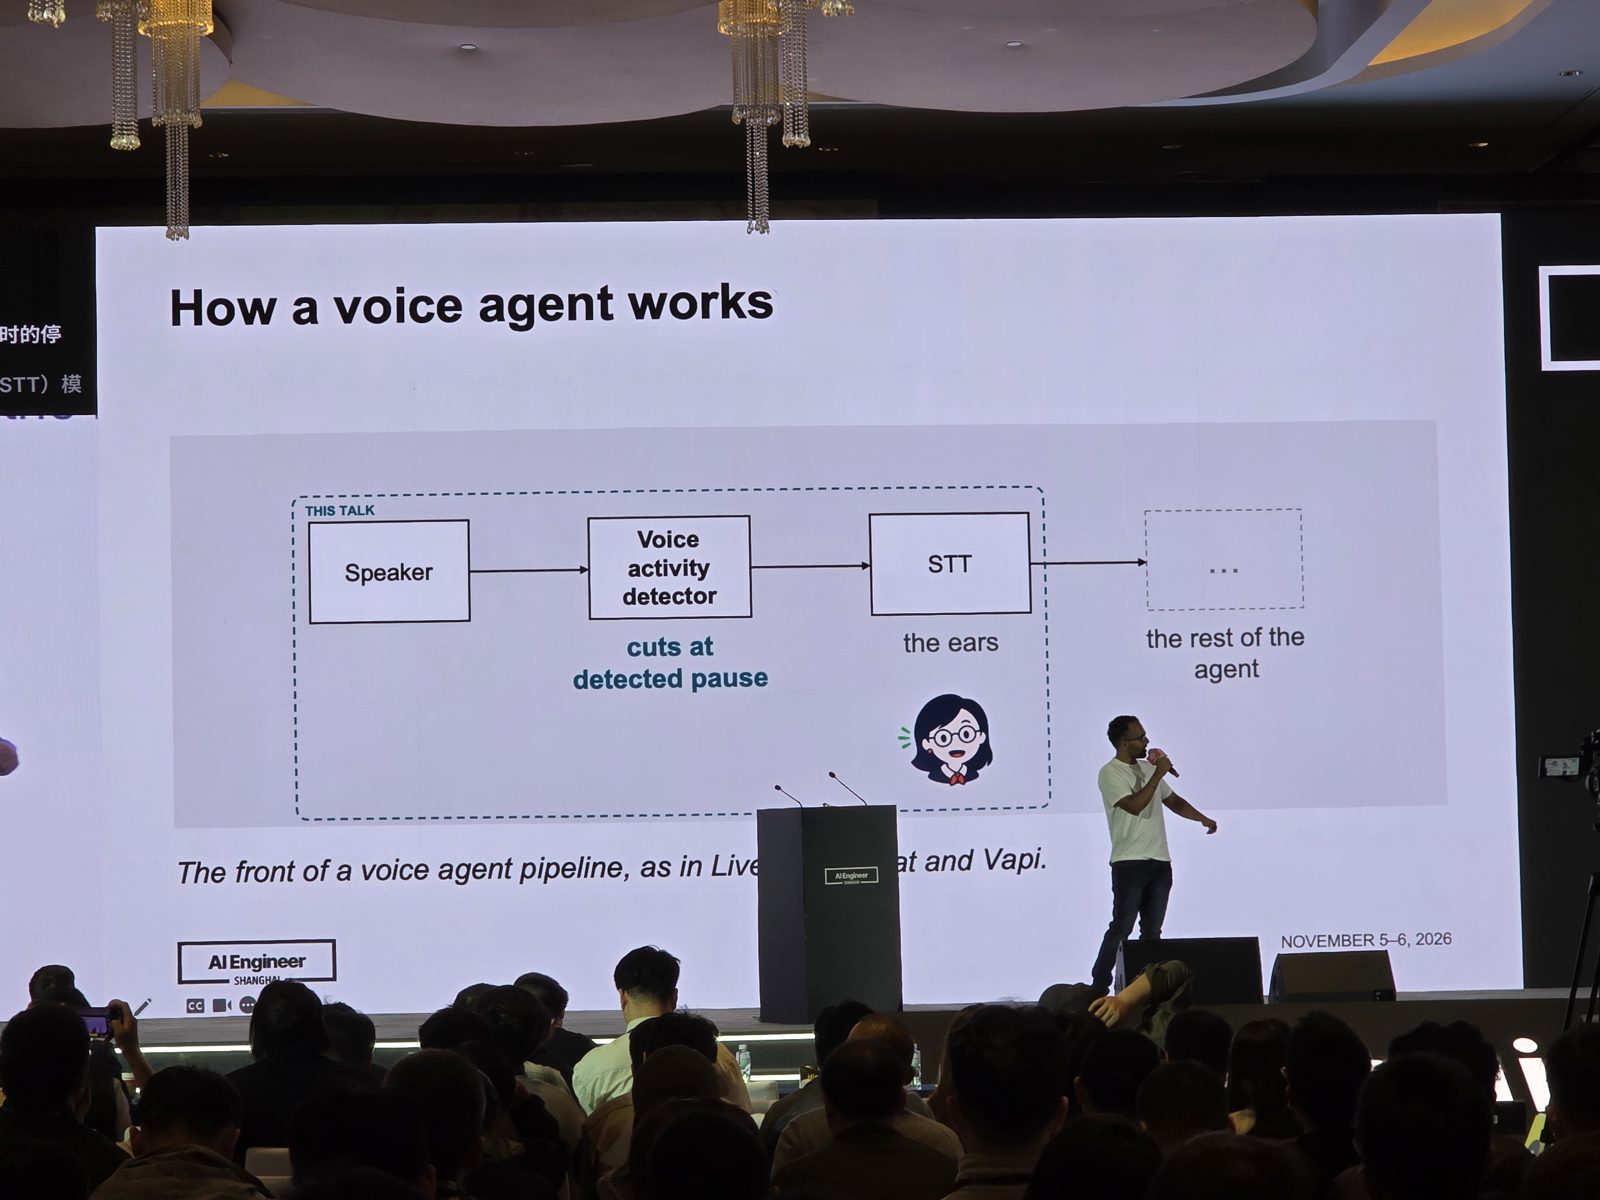
演講涵蓋的那段 pipeline:說話者、在偵測到停頓的地方切段的 voice activity detector,以及 STT 模型,「就像 LiveKit、Pipecat 和 Vapi 那樣」。
在 FLEURS 上,他們試的四個模型公布的錯誤率在 2.4% 到 7.2% 之間。在他們的即時音訊上,同樣的模型分別是 25.0%(Qwen3-ASR)、28.5%(ElevenLabs Scribe)、27.6%(Gemini 3.5 Transcribe)和 48.5%(gpt-4o-transcribe),差了 4 到 20 倍。他點出兩個差異。FLEURS 是母語人士唸事先準備好的句子,整段送進模型。他們的學生不是母語人士,邊想邊說,而且送到模型的是被 voice activity detector 切開的一段一段。
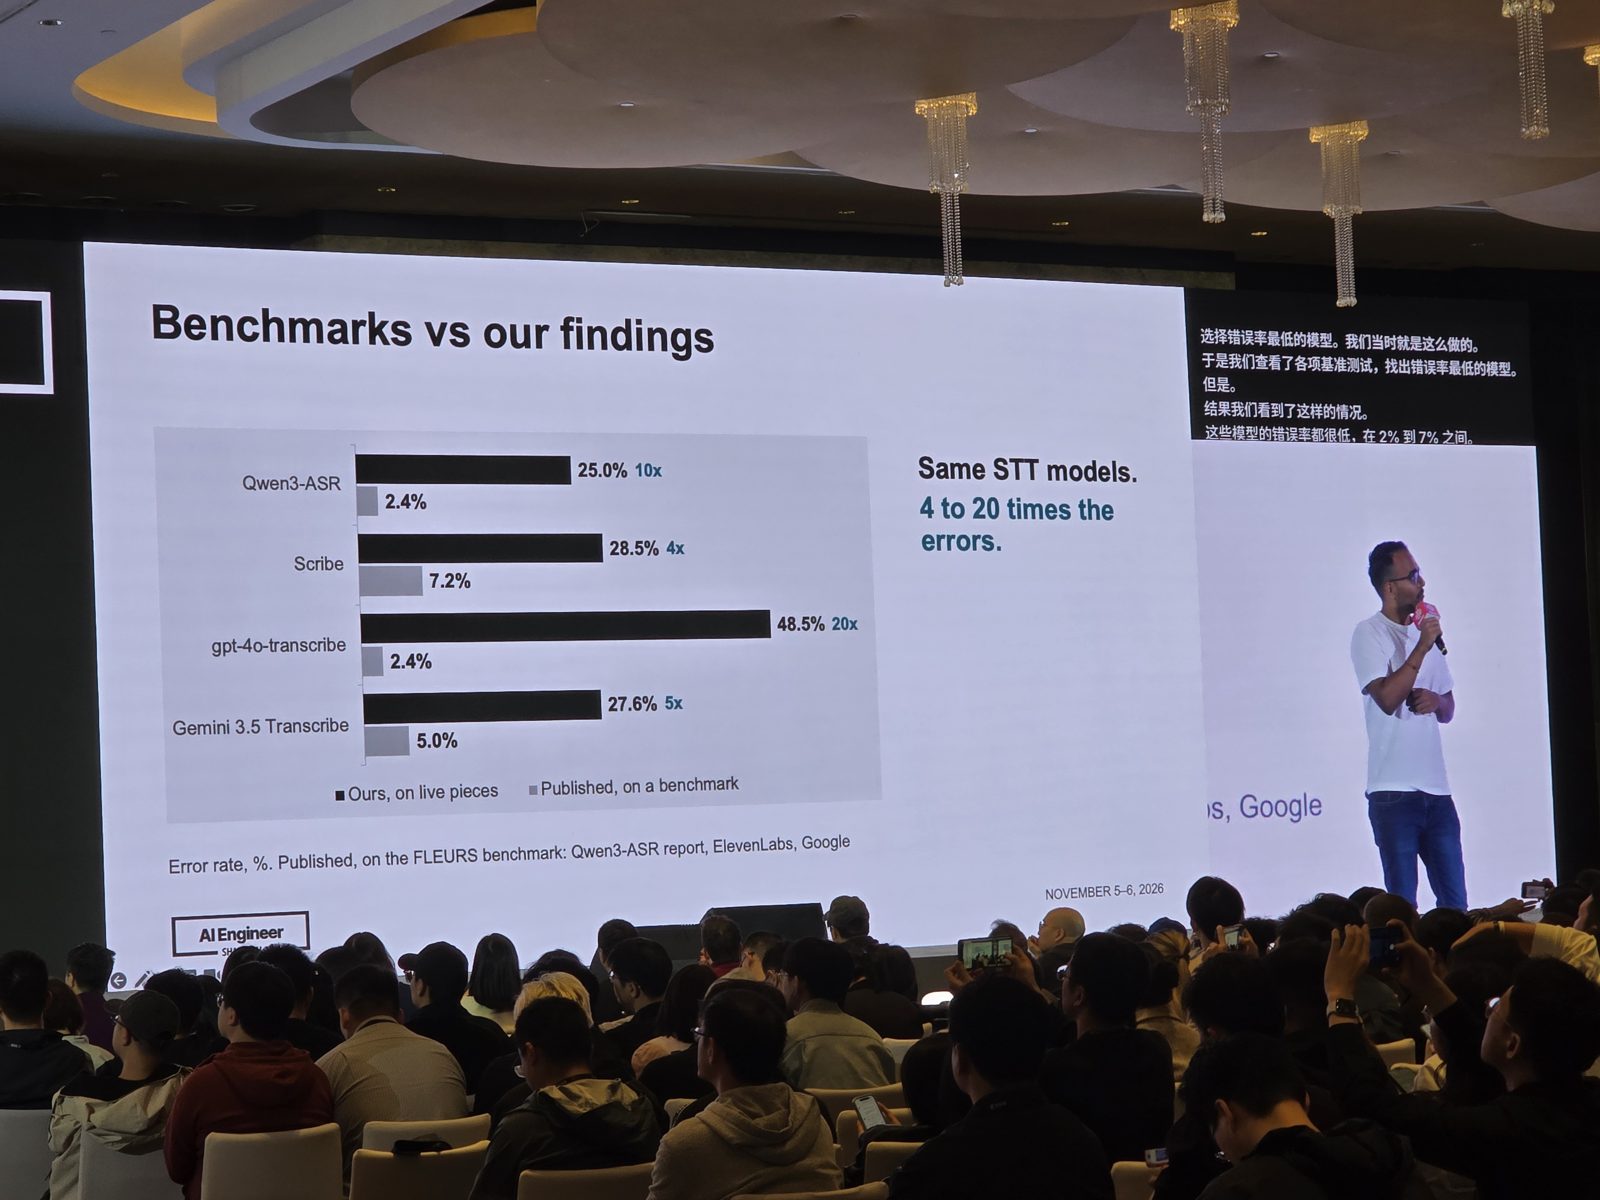
Benchmark 與他們的實測:公布的 FLEURS 錯誤率(2.4 到 7.2%),對比同樣的模型在學生即時音訊片段上的表現(25.0 到 48.5%)。
為了把這兩個因素分開,他們把同一批學生的完整錄音丟給同樣的模型。準確度大幅上升,別種語言的文字也不見了。接著他們把開場那段音訊跑過即時 pipeline。那位學生停頓很多,所以 VAD 切出很短的片段,而這麼短的片段聽起來可能像好幾種語言裡的某個字。原因出在 decoder。它輸出的第一個 token 是語言,之後每個 token 都以它為條件,所以在一秒長的片段上猜錯,整行就會變成韓文或泰文。音訊越多,decoder 就有越多東西可以當條件。
對 Scribe、Qwen 和 Gemini 取平均,準確度從即時片段的 62 提高到完整錄音的 82。告訴模型是什麼語言,可以把即時片段拉到 73,也就是 20 分裡補回 11 分。剩下的 9 分是上下文,片段長度到 2 到 8 秒時,大部分就回來了。他的解法是讓 VAD 等到更長的停頓再切。
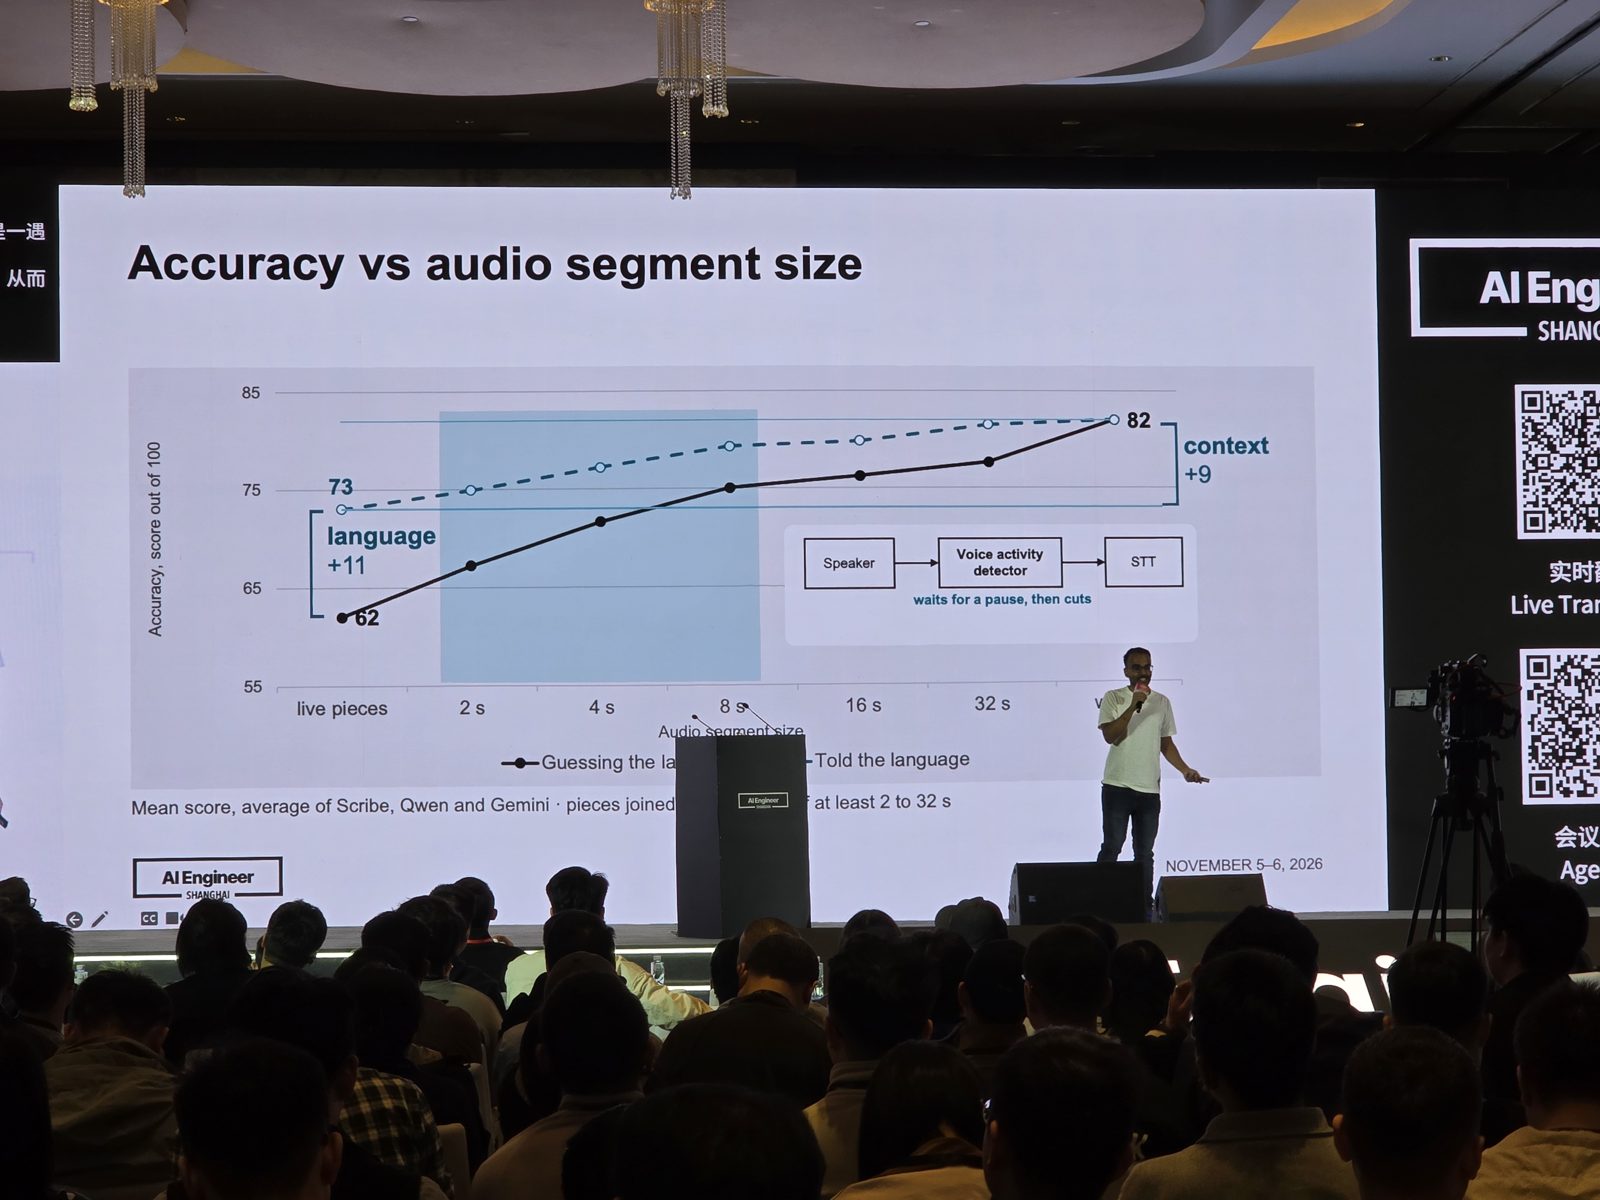
準確度與片段長度:即時片段 62,完整錄音 82,告訴模型語言 +11,上下文 +9,其中大部分在 2 到 8 秒的片段(陰影區)就達到了。
AI 新創:產品、市場與下一步 — Yusen Dai (ZhenFund), Harry Wang (Linear Capital), Patrick Liu (TaoZ Capital)
午餐後的第一場是 40 分鐘的投資人座談。主持人是 podcast《第二次用火》的 Bibi,與談人是 ZhenFund 的 Yusen Dai(Kimi、Manus 和 Xiaohongshu 的第一張支票都是他們開的)、Linear Capital 的 Harry Wang(投資 Horizon Robotics 這類軟硬體結合的案子),以及去年底離開 BlueRun Ventures、改投北大師生的 Patrick Liu。沒有投影片。他們在兩個問題上意見不同。
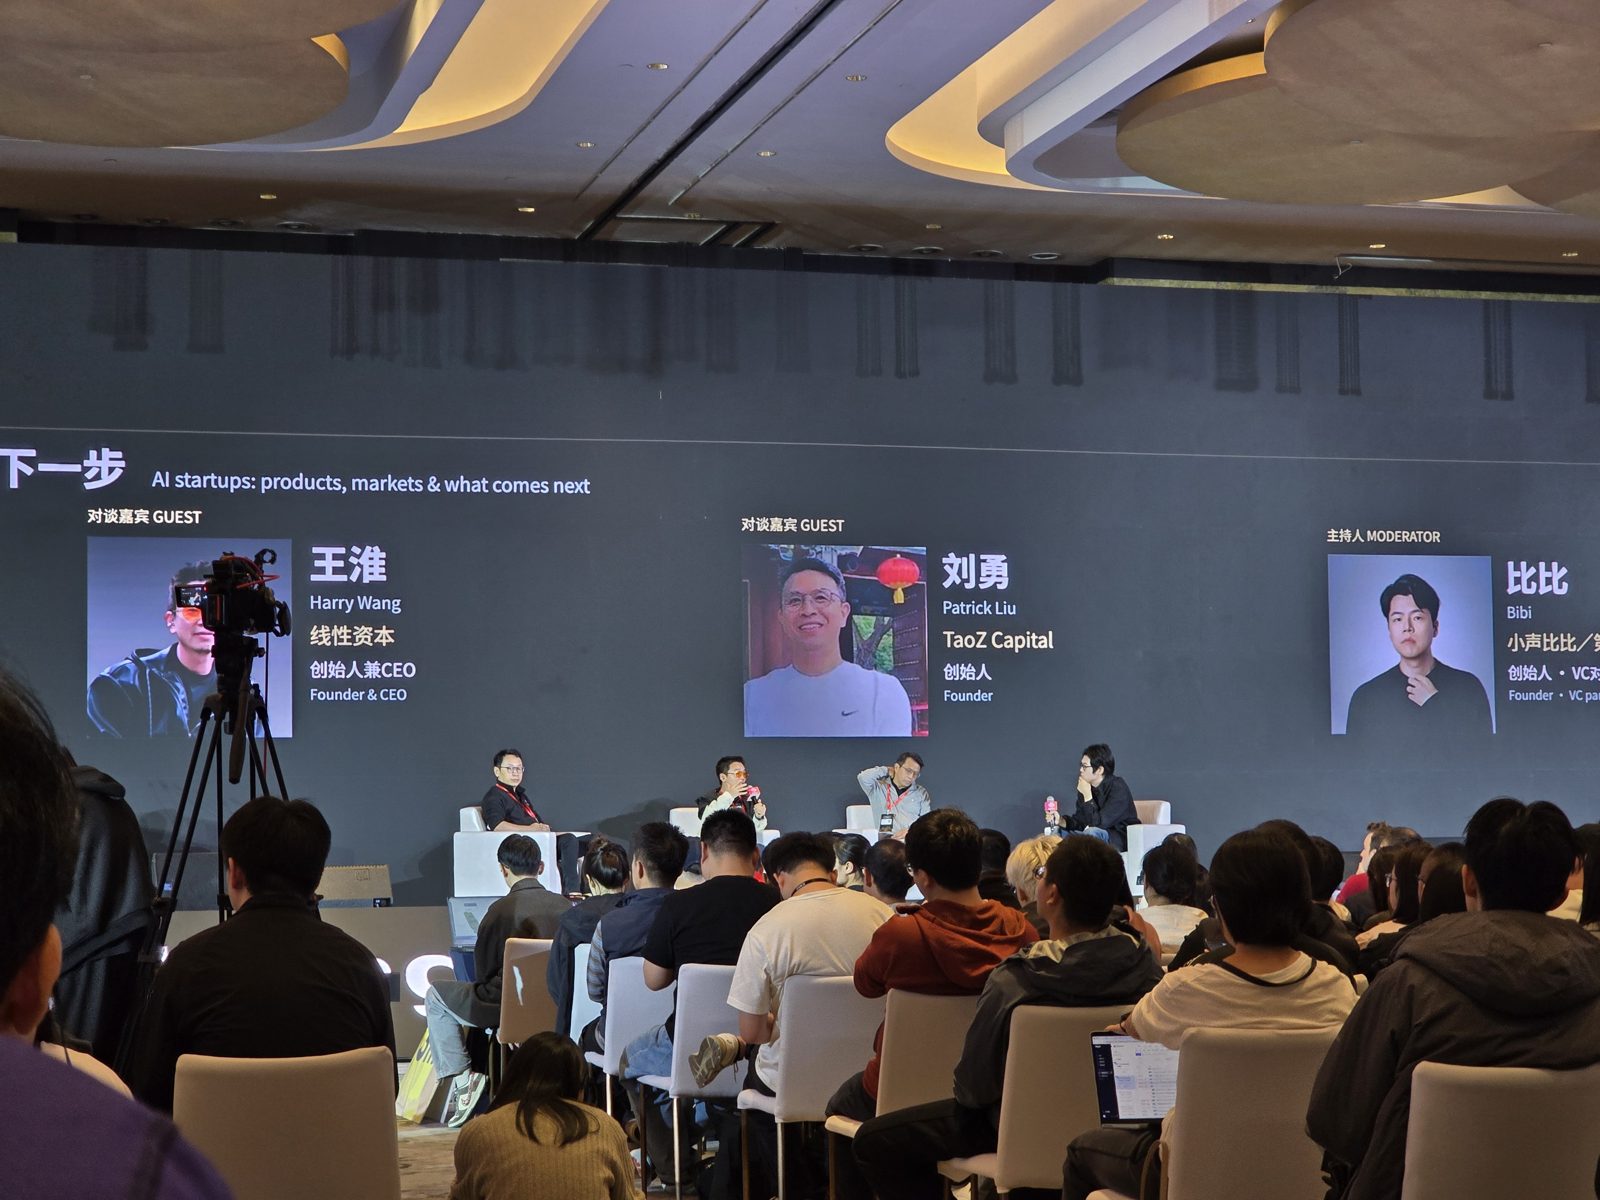
主舞台上的座談,由左至右:Yusen Dai、Harry Wang、Patrick Liu 和主持人 Bibi,螢幕上是 Wang、Liu 和 Bibi 的來賓卡。
第一個問題是模型公司是不是正在吃掉應用層。Dai 認為壓力來自模型公司自己的 app,也就是 Claude Code、Codex 和 ChatGPT,用他的話說,這些產品「補貼了 20 倍的 token」。他還是認為更便宜的模型對做應用的人有幫助:推論效率每年提升「可能 10 倍」,而模型能做到的事和大家願意付錢的事之間的落差,總要有人去補。他的比喻是 Windows:IE 和 Office 是第一方產品,第三方生態系還是長起來了。Patrick 講得更直接。他說在中國,三年前募到錢的應用層新創,90% 甚至 99% 都死了,而贏家是在最新的模型上做套利,一旦模型自己伸進應用裡,套利就結束了。Harry 說純軟體的應用邊界一直在消失(「中國從來就沒有邊界」),所以 Linear 投的是硬體加軟體。
他們對個人 agent 意見分歧。Harry 是最熱衷的一方:口袋裡一個「IQ 200」的助理,能讀懂他說話的語氣和節奏,直接動手做事而不是陪聊,由一個管家 agent 按任務保存上下文,就像 DeepSeek 剛發布的 Super Agent 設計。Dai 認為效率不是大眾市場的需求。清掉舊的訂閱做一次很好,現有產品的留存「一般」,而最大的行動網路公司都是靠擴大人們想要的東西成長,而不是幫人省時間。一個幫你訂機票的 agent,只是把 Ctrip 的佣金換到另一個口袋。Patrick 說機會是真的,但屬於平台公司,因為新創在運算資源、演算法和資料上都比不過模型實驗室。他根據自己經營遊戲公司多年的經驗補充:消耗使用者時間的產品,會贏過幫使用者省時間的產品。
Harry Wang(左二,拿著麥克風)正在講基於 diffusion 模型的即時影片生成,速度快了「20 倍以上」,他把它當成避開模型實驗室主戰場的垂直領域。
Harry 說實驗室主要是在寫程式上訓練長時程的行為,金融或旅遊的軌跡資料和環境都「遠遠不夠」,還有一位矽谷實驗室的董事會成員告訴他,模型在日常任務上看起來「很笨」,是因為訓練的優先順序,不是能力問題。
第二個分歧是關於創辦人。Dai 說 ZhenFund 沒有跟進同行投的那些估值很高的年輕教授新創,因為好的研究和好的公司是兩回事,而且在中國,研究專案很少有退場管道。Kimi 的 Yang Zhilin 是他的例外。Patrick 直說他在這點上跟 Dai 看法不同,他喜歡年輕老師搭配優秀的大學部學生,因為這一波是技術驅動的。Harry 說 Linear 2026 年的案子大多在 physical AI。他也看過很多做遞迴自我改進(RSI)的新創,起始估值「通常在 1 億美元以上」,但一家都沒投,因為創辦人說不出 RSI 是要拿來做什麼。
Harry 支持本地 AI 的理由是隱私和上下文。他的企業級盒子至少跑一個「Flash 等級」的 DeepSeek 模型,讓公司的上下文留在公司裡,比較難的工作再交給雲端。
最後一輪問的是:如果畢業時拿到人民幣 200 萬的天使資金,他們各自會怎麼做。Dai 當年就是從 Xu Xiaoping 那裡拿了這筆錢,做出了 Jumei,他說要跟信得過的夥伴一起加入最大的那波浪潮,而且要預期會 pivot。Patrick 會挑一個非常難的問題,給它十年。
模型越強,harness 越精簡:哪些該控制,哪些該放手 — Ronny He (MiniMax)
Ronny He 帶領 MiniMax Code 的研發,這是 MiniMax 做 coding 和工作的 agent。他說投影片是前一晚重寫的。十六張投影片塞滿了他們自家 harness 的規則和量測結果,他不到二十分鐘就講完,案例「因為時間關係」也只是匆匆帶過。
他的主張一張投影片就講得完:放掉判斷,守住不變量(invariants)。判斷是指模型現在已經比你的 if 判斷式做得更好的決定:用哪個工具、怎麼規劃、工作怎麼拆。不變量則是模型看不到、無法復原,或不能信任它會記住的東西:prompt cache 的前綴、時鐘、process 的生命週期、必須保留下來的狀態。每個 harness 功能都要過四個問題。你說得出它防止的是哪一種失敗嗎?模型看得到它做這個決定所需的資訊嗎?如果它判斷錯了,你能復原嗎?這個功能有通過 eval 嗎?針對第三題,他的說法是:寫在 prompt 裡的規則是提示,不是閘門。
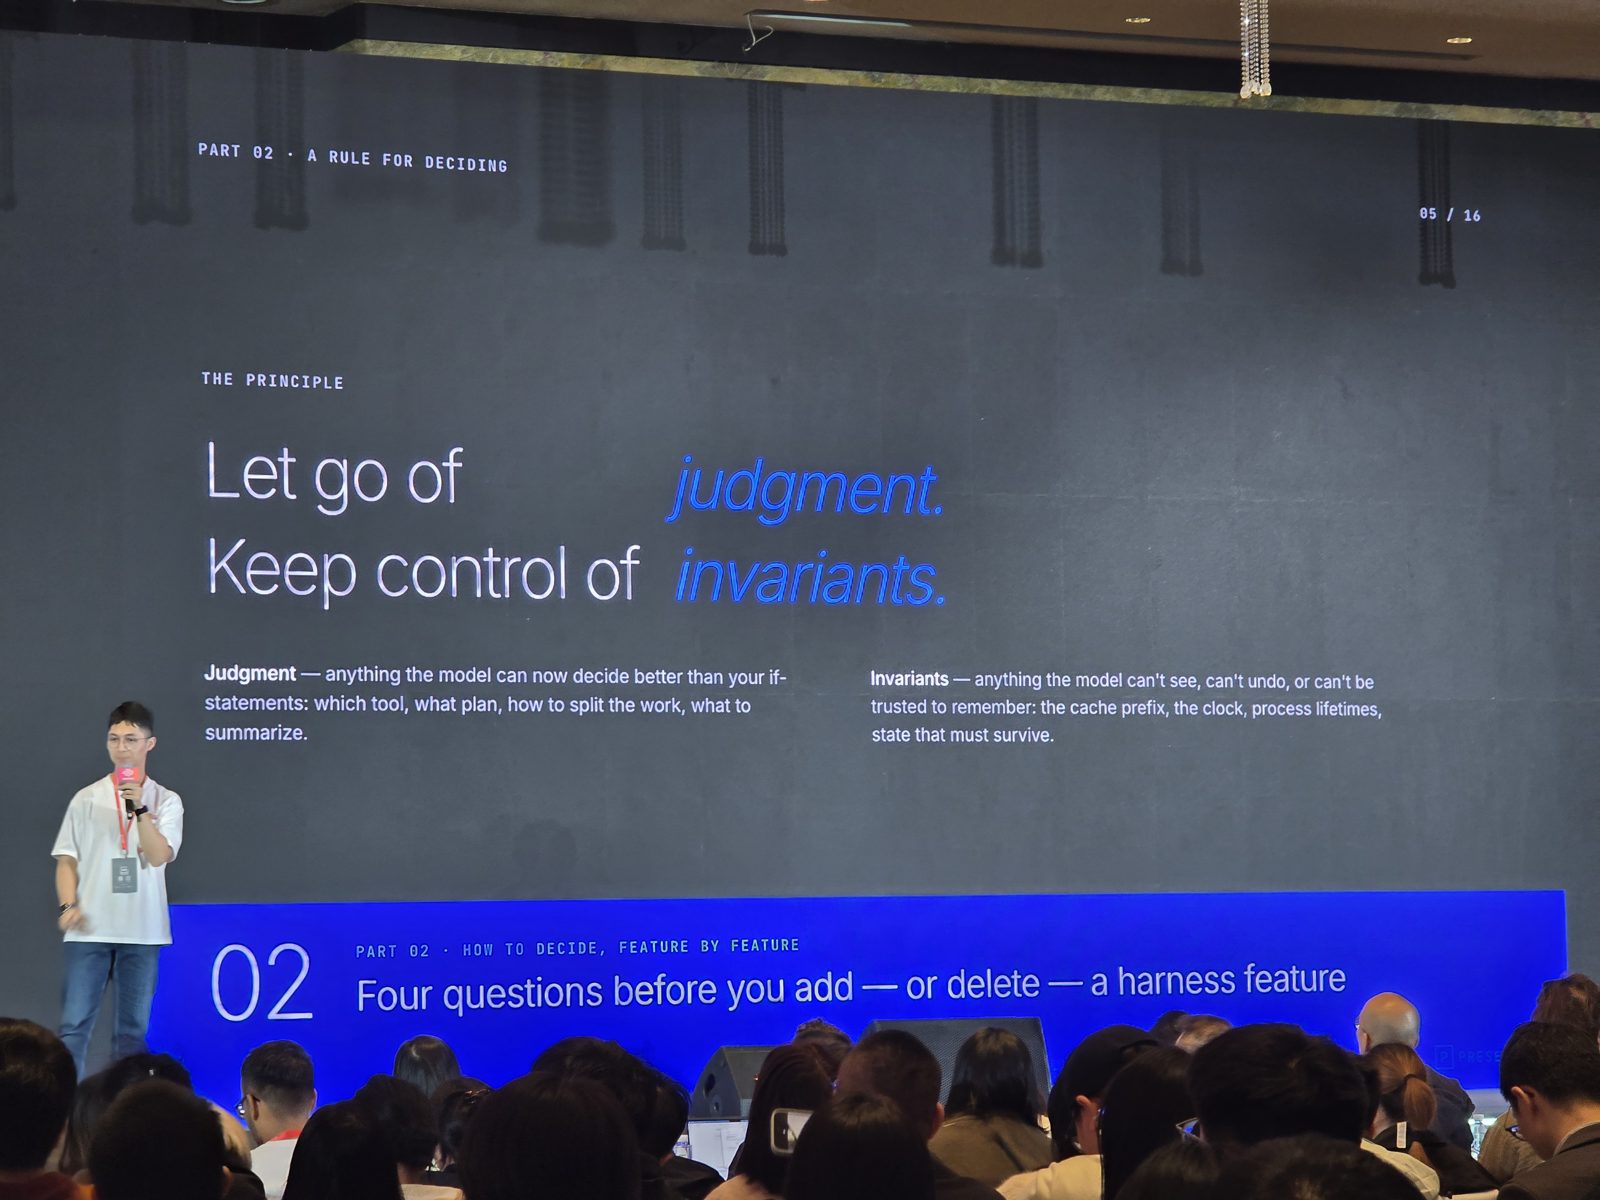
投影片 05,原則:放掉判斷(用哪個工具、怎麼規劃、工作怎麼拆、要摘要什麼),守住不變量(cache 前綴、時鐘、process 生命週期、必須保留下來的狀態)。
刪東西的理由來自 Anthropic。他說 Claude Code 的 system prompt 針對較新的模型砍掉了 80% 以上,單一 agent 加上 skills 常常勝過 subagent 的設計,也有人提過要拿掉 Plan mode。他問現場當天有誰用過 Claude Code,算下來超過全場 80%。MiniMax 預期自家的 /goal 指令會是下一個被拿掉的,因為模型現在已經被訓練成能把任務一路做到交付。數字則來自 MiniMax 自己的案例,五個裡有三個跟 prompt cache 有關。
Connector 工具(使用者登入的第三方 MCP server)以前每一輪都會被注入 tools 陣列。已連線的清單在不同輪之間可能會變,網路一抖還會回傳空清單,結果快取的前綴一直失效,有時候模型甚至一個工具都沒有。他們把這些全部搬到一個讓模型呼叫的小 CLI 後面,tools 陣列從此不再變動。代價是多一個模型步驟,而且得仰賴寫得好的描述。第二個案例是 programmatic tool calling:一個 run_code 工具,裡面的 JavaScript 透過同一套權限和 hooks 呼叫 tools.*。run_code 跟所有原生工具並列提供時幾乎沒被用到,token 還增加了 5%。直到大部分工具只能透過程式碼存取,它才划算。這時分數持平,兩組任務的 token 分別減少 13% 和 35%,request 數從 104 降到 93。他的投影片說這是效率上的提升,不是能力上的提升。
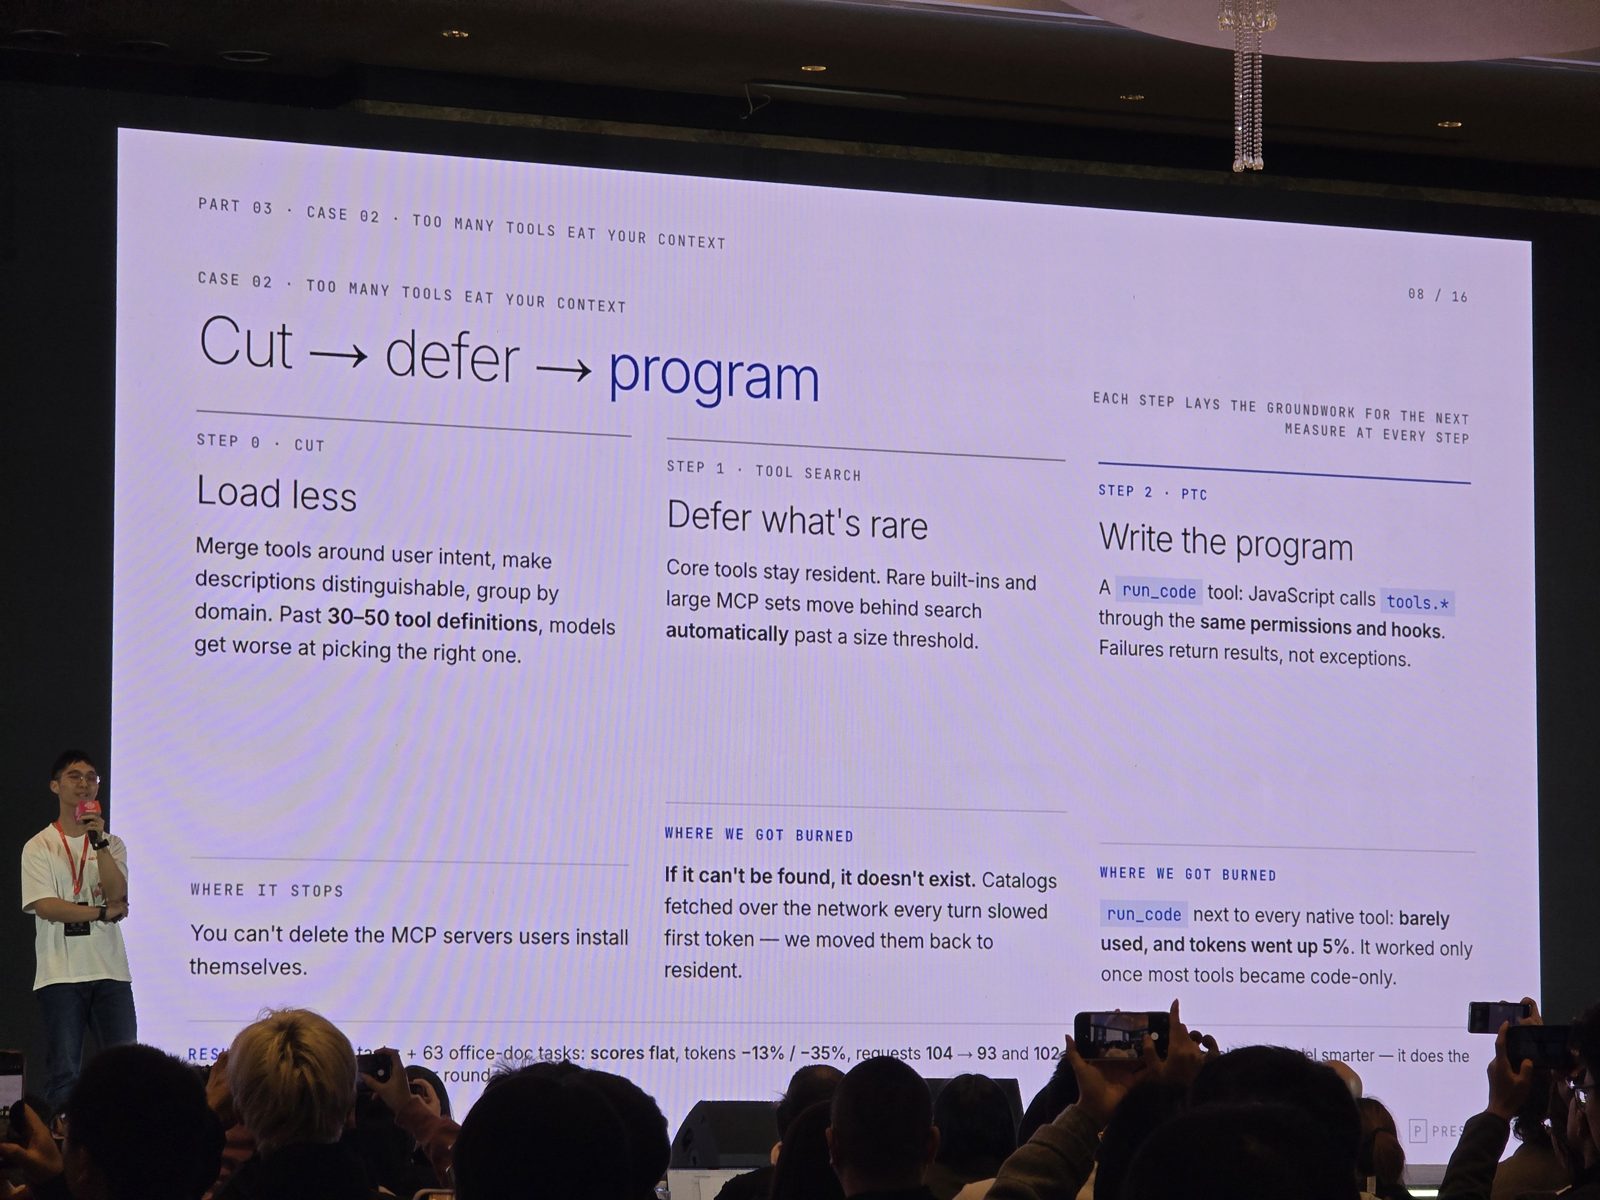
投影片 08,刪減、延後、程式化:少載入一些工具(定義超過 30–50 個之後,模型挑得更差),把少用的工具移到搜尋後面,再來是 run_code 工具。「我們踩過的坑」框裡寫著:每一輪都去抓工具目錄,拖慢了第一個 token;run_code 跟原生工具並列時沒人用,token 卻增加了 5%。
第三個案例最具體。Anthropic 預設的 prompt cache 存活時間是五分鐘,而 agent 在等 npm run dev 的時候不會送出任何 request,所以在前景等六分鐘,cache 就沒了,下一輪得付完整的 prefill。模型看不到這個時鐘,所以時間由 harness 掌管。每個指令一開始就是背景任務,前景最多等 60 秒,任務保留同一個 ID,免得模型把它砍掉再重啟一次,另外還有一個 3600 秒的期限,前景時間也算在內,而且不能靠轉到背景來重置。投影片也承認了代價:通知、防輪詢、清理,還有「compaction 之後的真相」,全都得手工重做。
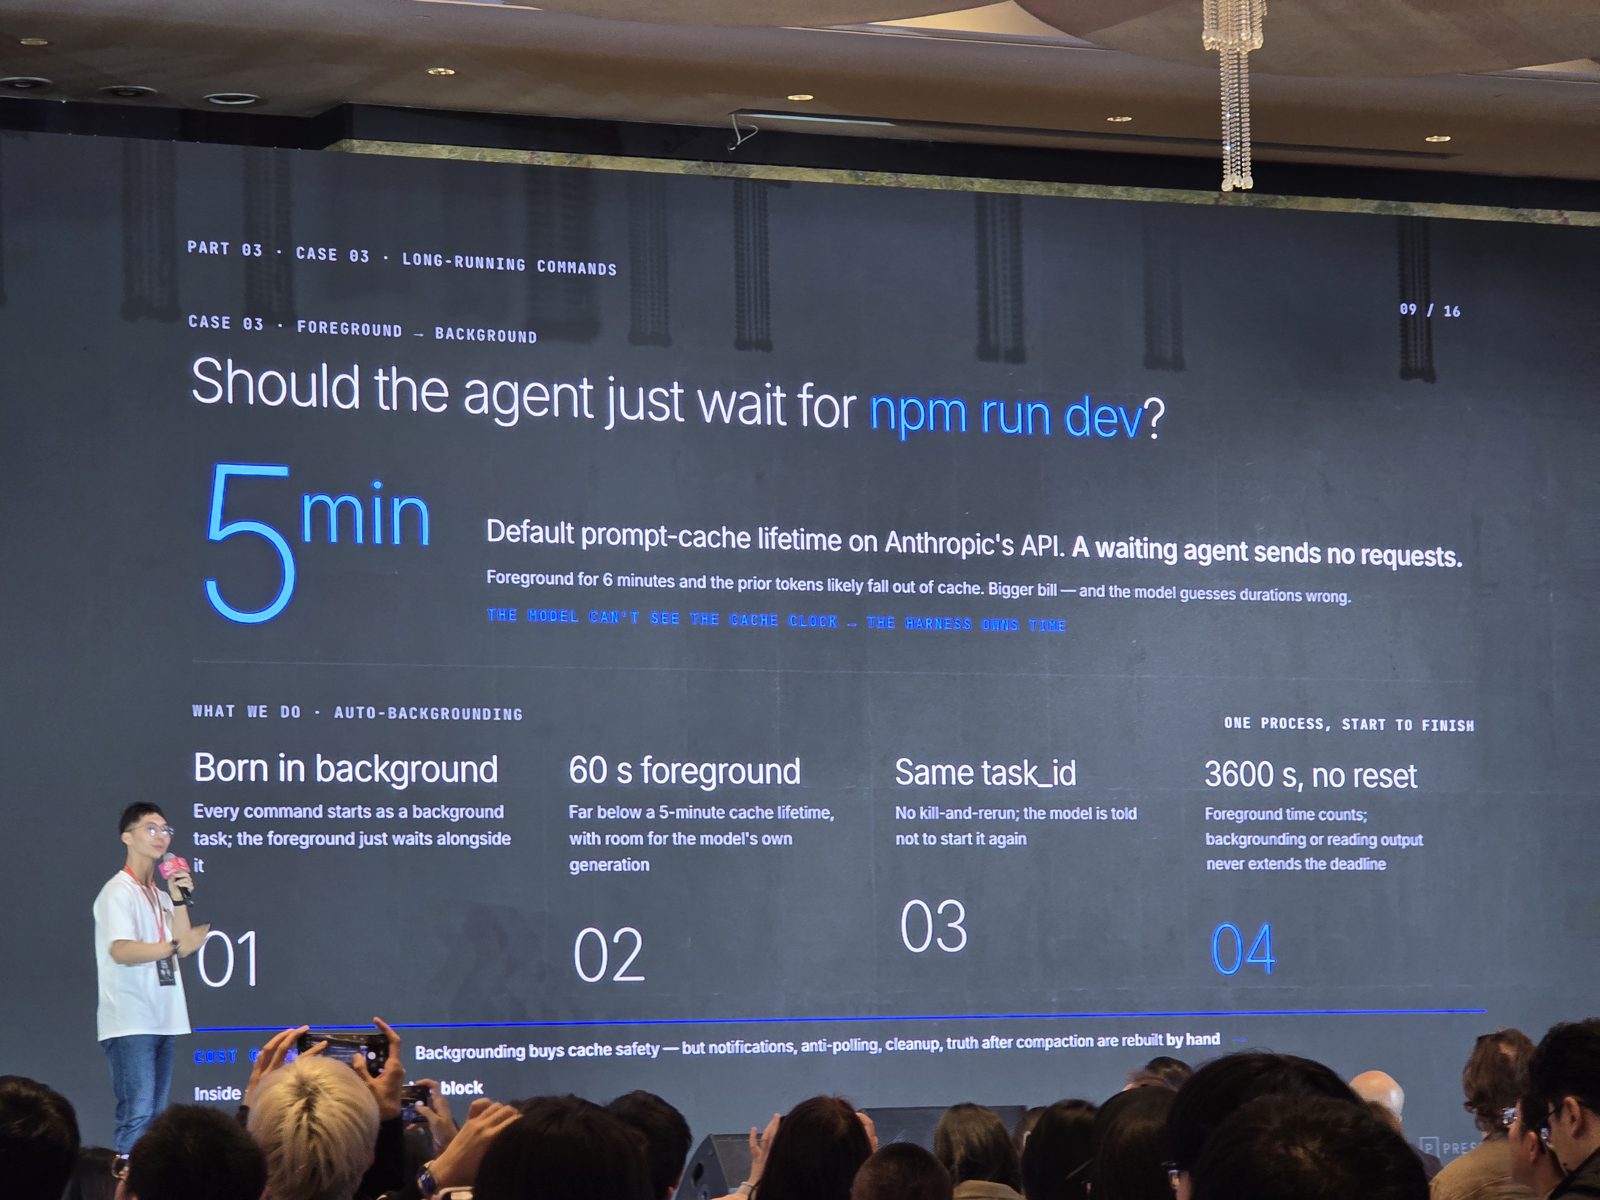
投影片 09,「agent 應該就這樣等 npm run dev 嗎?」:prompt cache 預設存活 5 分鐘,以及 MiniMax Code 的自動背景化(一開始就在背景、前景 60 秒、同一個 task_id、3600 秒且不能重置)。
有一張投影片是關於記憶的。一份很長的記憶檔案被截斷,最上面最重要的規則被切掉了,卻沒有人發現。agent 也會跟使用者說「context 快滿了,我下一輪再繼續」,因為它們不知道有 compaction 這回事。
超越視覺—語言—動作:建構 Physical AI 的第一性原理 — 何文智 He Wenzhi (AiMoga Robotics)
何文智是 AiMoga(墨甲)工業具身機器人事業部的產品總監,AiMoga 是奇瑞旗下的機器人公司。他是下午 physical AI 這個時段的第一場。他不是以研究者的身分在講,而是以必須讓機器人在客戶工廠裡真正跑起來的人來講。
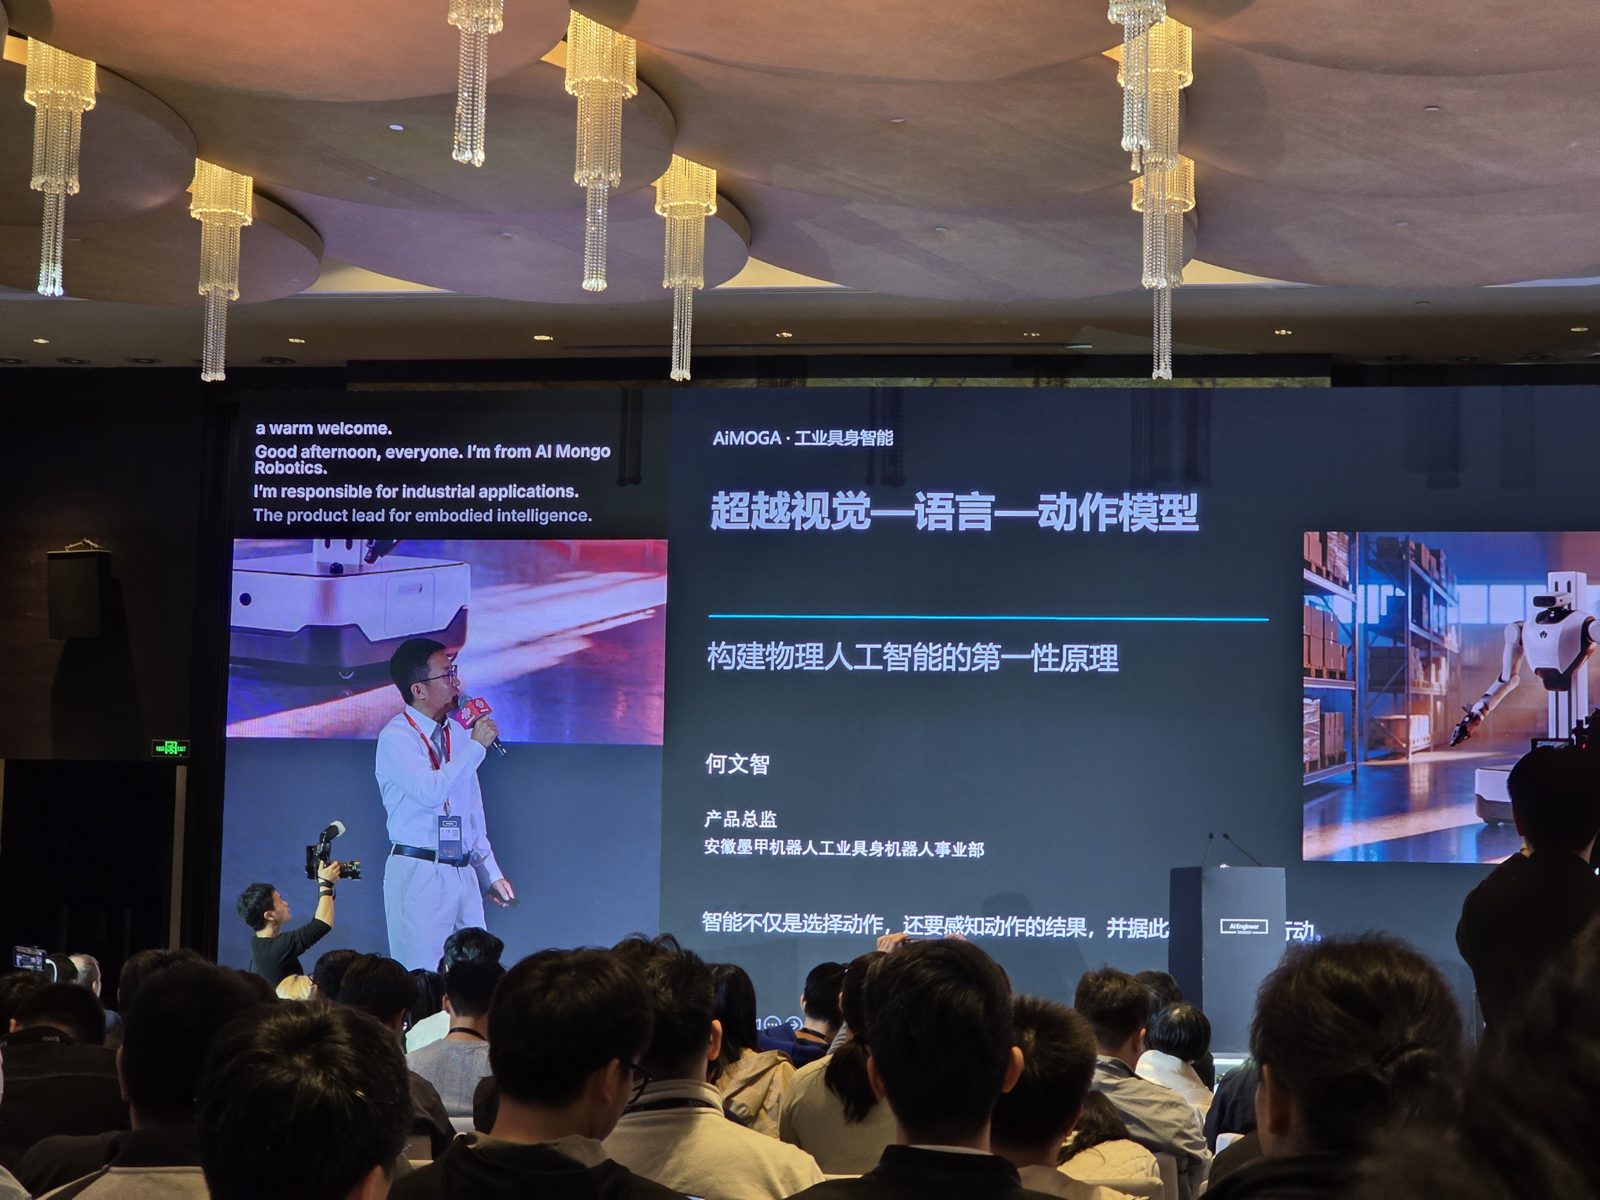
標題投影片:超越視覺—語言—動作模型,下面一句「智慧不只是選擇動作,而是感知動作的結果並修正下一個動作」。右邊的圖是 AiMoga 的輪式工業機器人。
照他的說法,兩種模型在產線上都會失敗。VLA(vision-language-action)模型達不到產線節拍要求的精度和穩定度,他說這是致命的。YOLO 這類傳統視覺模型可以做得很精準,但每家工廠,甚至工廠裡的每一條產線,都有很多種產品型號、形狀和顏色。AiMoga 得替每個客戶訓練、部署、調校,還要派自己的人長駐現場,他說這種成本對一家機器人公司來說撐不下去。他標題投影片上那台輪式工業機器人,下個月會在一家合作夥伴位於蘇州的工廠上線。
核心主張只有一張投影片:理解指令不等於掌握物理互動。VLA 能辨識零件,也能理解「把連接器插進去」,但光靠相機影像,它觀察不到接觸力、滑動、摩擦或對位誤差。他把痛點講得很具體:夾爪或靈巧手是不是真的抓牢了,零件是不是正在慢慢滑掉。投影片上的公式是「往哪裡移動?」≠「接觸對不對?」。他說,超越 VLA 是要做更完整的閉環,不是拋棄 VLA。
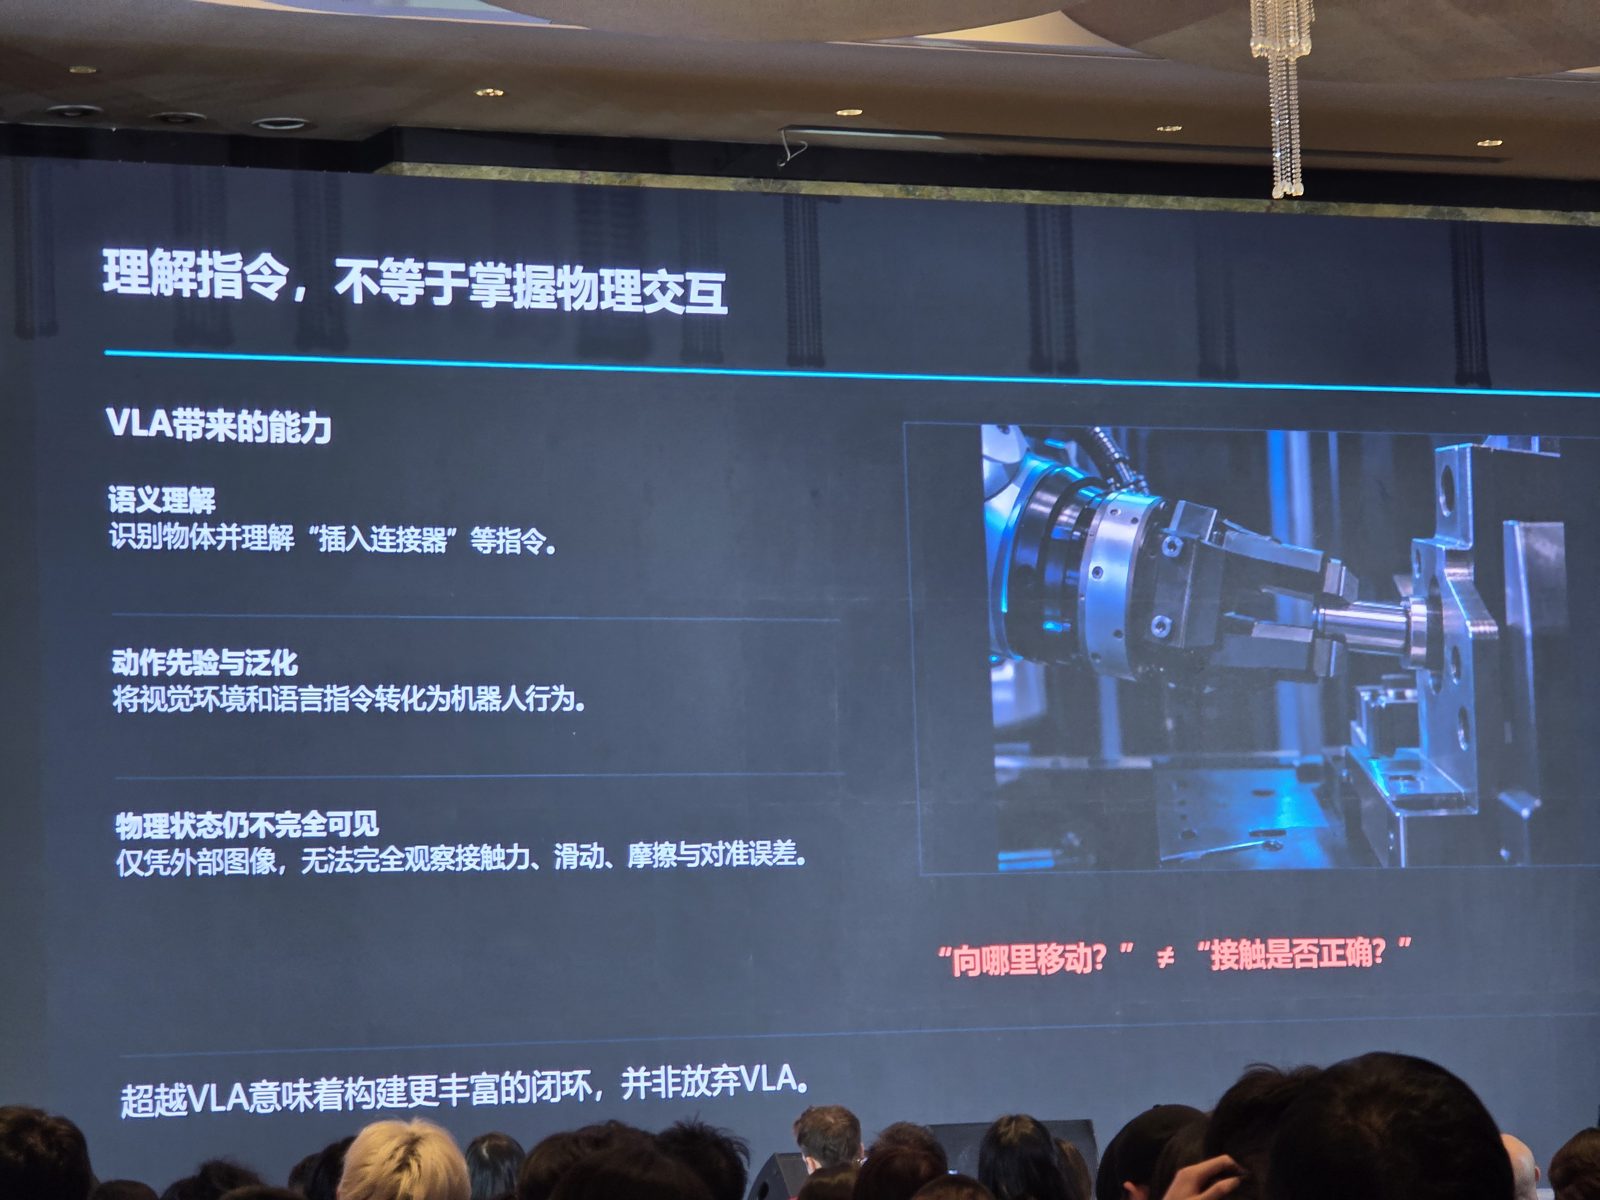
「理解指令不等於掌握物理互動」:VLA 帶來語意理解和動作先驗,但光靠外部影像,接觸力、滑動、摩擦和對位誤差仍然看不見。紅字:「往哪裡移動?」≠「接觸對不對?」
做法是一個感知與運動的閉環(sensorimotor loop):感知,估計狀態和它的不確定性,靠快速的局部回饋去動作,接著偵測偏差、滑動或失敗,修正,再把經驗留下來。每個感測器各有分工。相機提供 6D 姿態和深度,關節裡的扭力感測器回報碰撞、負載和施力,手上的觸覺感測器回報摩擦、滑動和形變,本體感覺(proprioception)提供關節和底盤的狀態。最上面是一個五層架構,他拿來跟自駕車的 L1–L5 對照,從運動控制(狀態估計、伺服、阻抗、安全)開始,經過能感知接觸的技能、技能記憶和 VLM 規劃,一路到目標層。記憶、評估和學習橫跨各層,學到的改變要先通過驗證,才會沉澱進模型。他舉的例子是由客戶的 MES 派發下來的任務:替工作站補料並安裝零件。如果上料時遇到裝配不順、非預期的力或滑動,機器人會停下、退回、重新估計。用他的話說,任務要等物理結果驗證過才算完成。
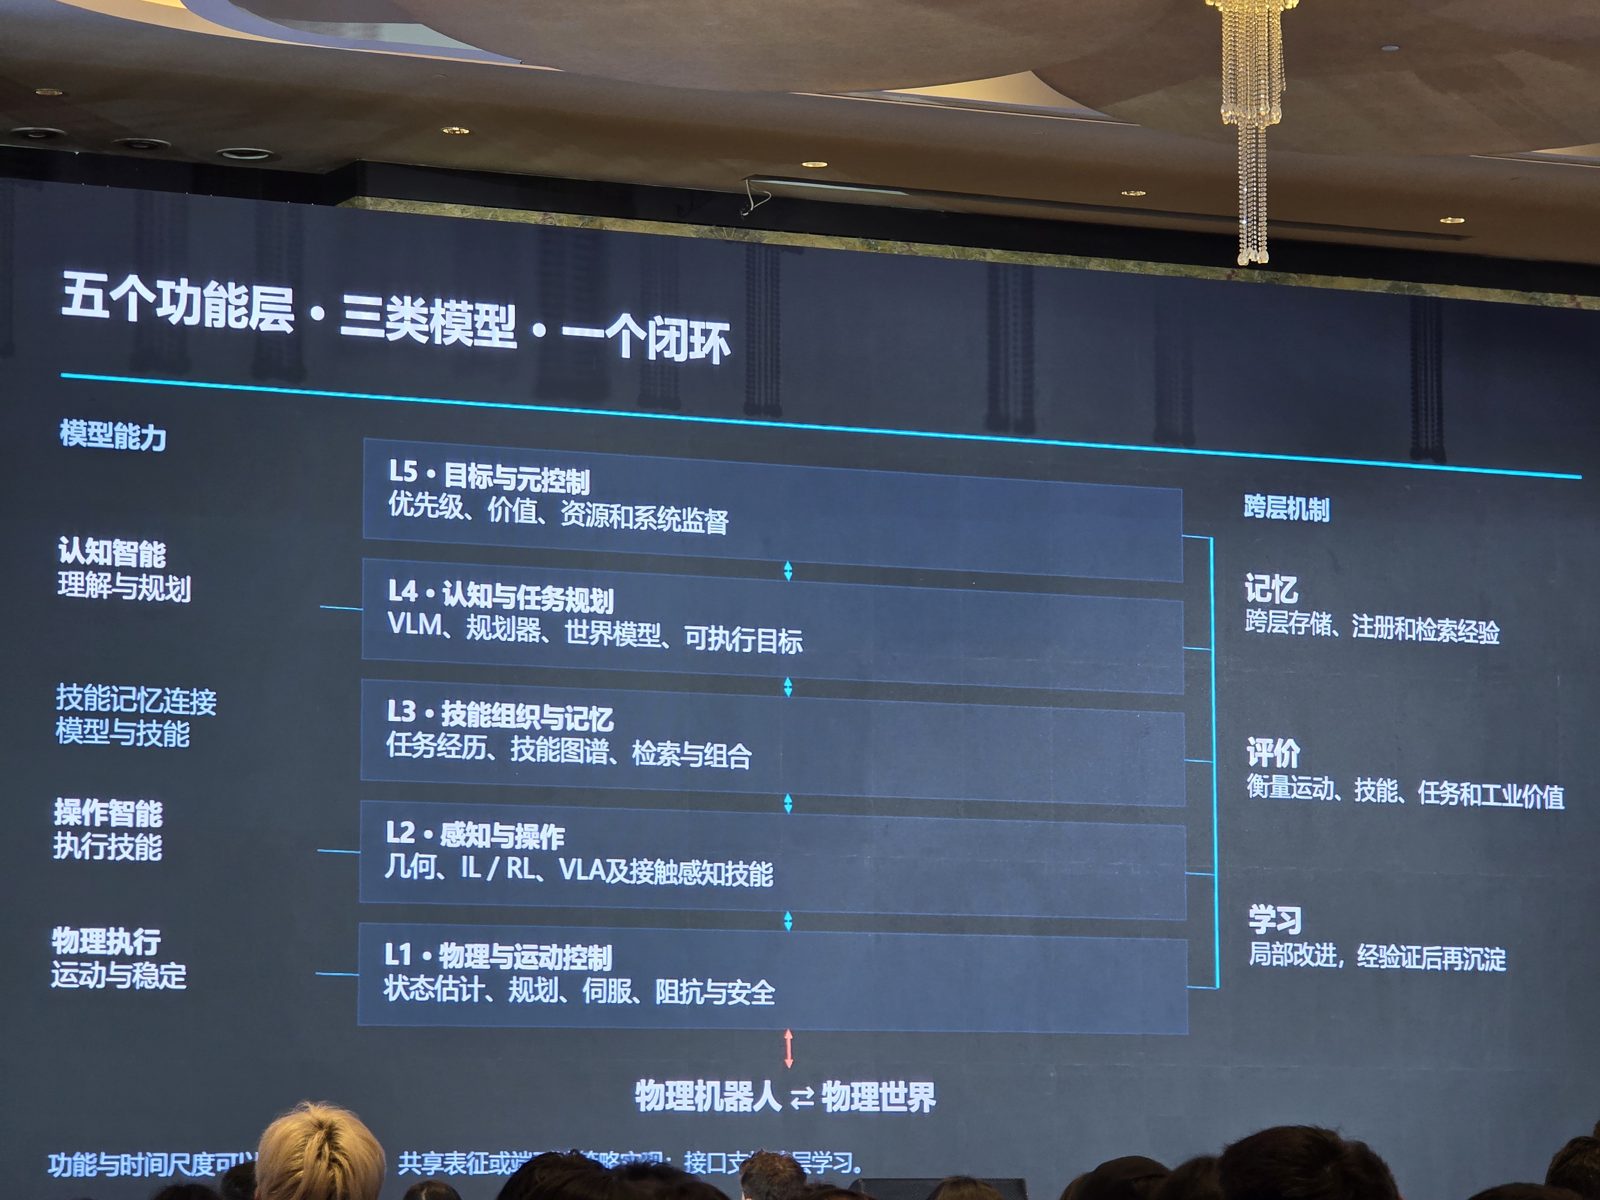
「五個功能層、三種模型、一個閉環」:從 L1 物理與運動控制到 L5 目標與後設控制,記憶、評估和學習是跨層機制(學習:局部改進,驗證之後才沉澱下來)。
他說這個閉環在實際部署中還沒完全用上。
工業安全監控(運動限制、碰撞保護、停機、故障處理)絕對不能依賴模型。它跑在 PLC 或專用的板子上,用手寫的規則。
他也提到,把 LiDAR、深度、力/扭力、超音波和 RGB 資料融合起來,對他們來說還是未解的問題。
從 3D 生成到世界模型:為 Physical AI 建構持久、可互動的世界 — Gavin Luo (VAST / Tripo AI)
Gavin Luo 是 VAST 的策略負責人,VAST 就是做 Tripo 3D 生成模型的公司。他整場演講圍繞著自家公司今年不得不面對的一個問題:當 AI agent 開始自己建 3D 場景,一家 3D 公司會變成怎樣?
Gavin Luo 在主舞台上,旁邊是標題投影片「從 3D 生成到世界模型:建構持久、可互動的世界」。
OpenAI 發布 GPT-6 Astra 兩天後,團隊開了一個群組叫「Astra 今天解決 3D 了嗎?」,規則只有一條:只能貼自己親手試過的東西,Twitter、YouTube、小紅書上看來的都不算。agent 完全用程式碼,在幾十秒內就建出室內場景,沒用到任何 AI 原生的 3D 模型。一位研究員說,他還沒找到哪個室內場景非用 Tripo 不可,一位同事回他:「老實說,有點慌。」一個房間大部分都能用規格描述出來。VAST 的結論是:描述得出來的,agent 就寫得出來;只認得出來的,就得靠模型去學。門和分數交給程式碼,角色的臉、生物的造型,或是照著照片做出神似的模樣,交給模型。他舉的例子是第一天分組場次裡 Sac 的《小王子》遊戲,用 Claude、Blender 和 Tripo 在 16 天內做出來,agent 寫遊戲,Tripo 做 3D 素材。Tripo 變成了 agent 呼叫的工具。
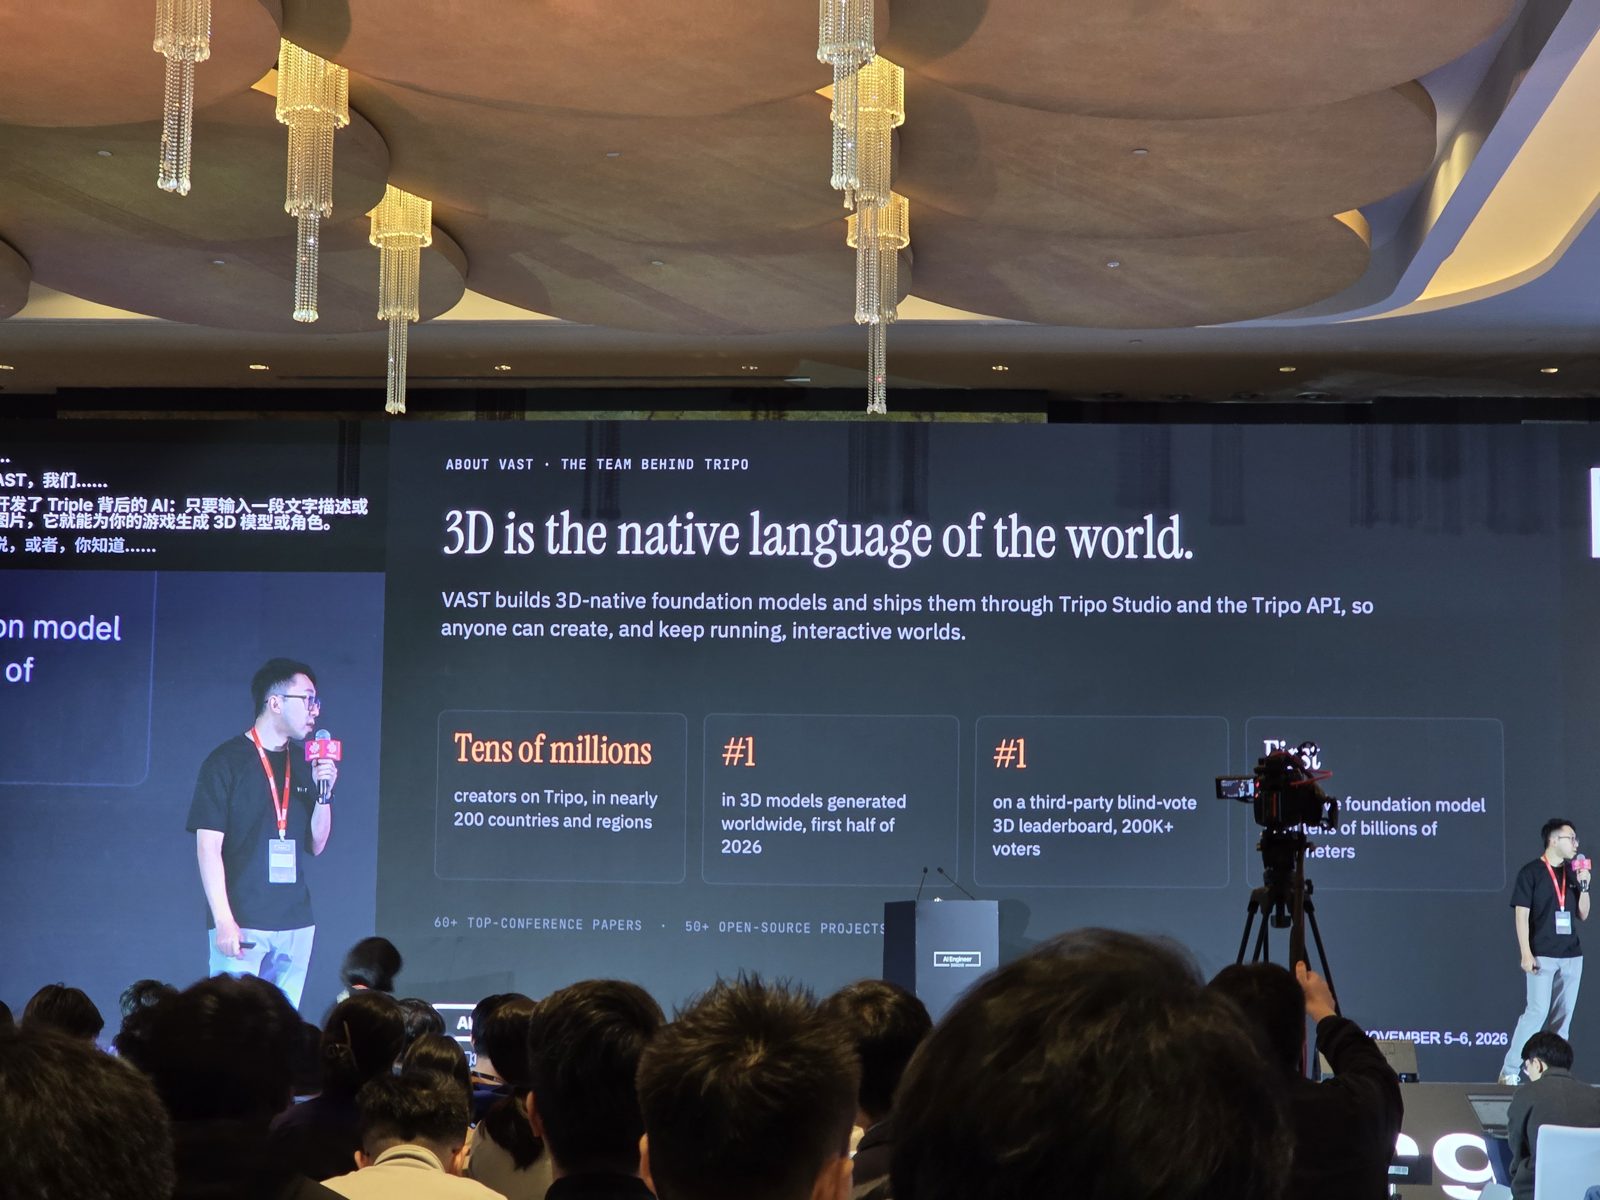
「3D 是世界的原生語言」:VAST 透過 Tripo Studio 和 Tripo API 提供 3D 原生模型。遍及近 200 個國家和地區的數千萬名創作者,2026 上半年 3D 模型生成量第一,在一個 200K+ 人投票的 3D 盲測排行榜上排名第一,60+ 篇論文、50+ 個開源專案。
後半段講的是 Project Eden,這是 CEO Simon 在 SIGGRAPH 2023 展示過的那道階梯的下一階:先是素材,再來是場景,然後是能為人和機器人持續運作的世界。他的說法是,3D 素材是名詞,世界需要動詞。設計上把世界狀態明確地放在一個普通的程式裡。遊戲知道門在哪裡、有沒有開、走過去會發生什麼,並把這些渲染成一個灰盒(grey-box)畫面。EdenLive 拿灰盒畫面當目標的第一幀,再加上一段文字 prompt,或是針對重要事件的簡短文字,生成你實際看到的畫面。示範中,一個小視窗顯示潛艇遊戲本身的輸出,主螢幕則是 EdenLive 的版本。因為每個畫面都來自同一份狀態,你撲滅的火會一直是熄的,牆上的痕跡下一個訪客來時還在,兩個玩家也能從不同的攝影機角度看同一個地方。遊戲和模型之間的約定就只是參考畫面,所以每款遊戲不需要做自己的整合。他說示範跑的是 5B 模型,720p、每秒 24 幀,權重和串流推論程式碼都以 Apache 2.0 開源。repository 裡另外寫到這是跑在單張 RTX 5090 上,而且 14B 的權重也已經釋出。
他列出了還缺什麼。角色走回畫面時,細節可能已經跑掉,使用者需要更多控制權,而學習狀態轉移「非常重要」,目前還沒解決。他最喜歡的失敗案例是一個評估:他們的一個 agent 在那裡塞了一個箱子,就通過了可行走性檢查,檢查的結論是人可以走上樓梯。
在機器人方面,他們拿一段真人操作物體的影片,把手換成機械手臂,保留動作和場景,藉此從一次示範得到多種視覺變化。他說他們還需要測試物理上的準確度,以及對機器人學習到底有沒有用,而真正的目標,也就是第三階,是讓機器人能動作、看到後果、再試一次的環境。
我們如何為裝置端 agent 建構開放的決策模型 — Leonie Monigatti (Liquid AI)
Leonie Monigatti 在 Liquid AI 的 post-training 團隊工作。她在大會前一週把原本準備好的演講整個丟掉,因為九月中 TypeSafe AI 發布了 Jev,開啟了現在大家稱為決策模型(decision model)的這類模型(TypeSafe 自己的叫法是「System One models」)。她的主張是,開源生態系正在用比 TypeSafe 發表部落格文章所暗示的更簡單的配方,逆向工程 Jev,而且結果有競爭力。Liquid 在六、七週內就推出了好幾個這類模型,有託管的,也有開放的。她說當天早上她查的時候,Liquid 的 d1-ultra 在 Decision Index 上排第一。
決策模型接收一個狀態和一個範圍明確的問題,回傳一個有型別的答案和一個信心分數,只要一次 forward pass,不生成文字。她的例子問的是:在演講前一週把題目換成一個每天都在變的主題,是不是好主意。Liquid 有三種問題類型,他們稱為 primitives:Noul(是/否)、Score(這裡是 1 到 5,它給了 1)和 Choice。真正的產品是那個信心分數。示範之後的那張投影片只有四行程式碼:高於 0.9 就執行,否則請人確認。「決策模型可能會錯,但它不確定的時候會告訴你。」
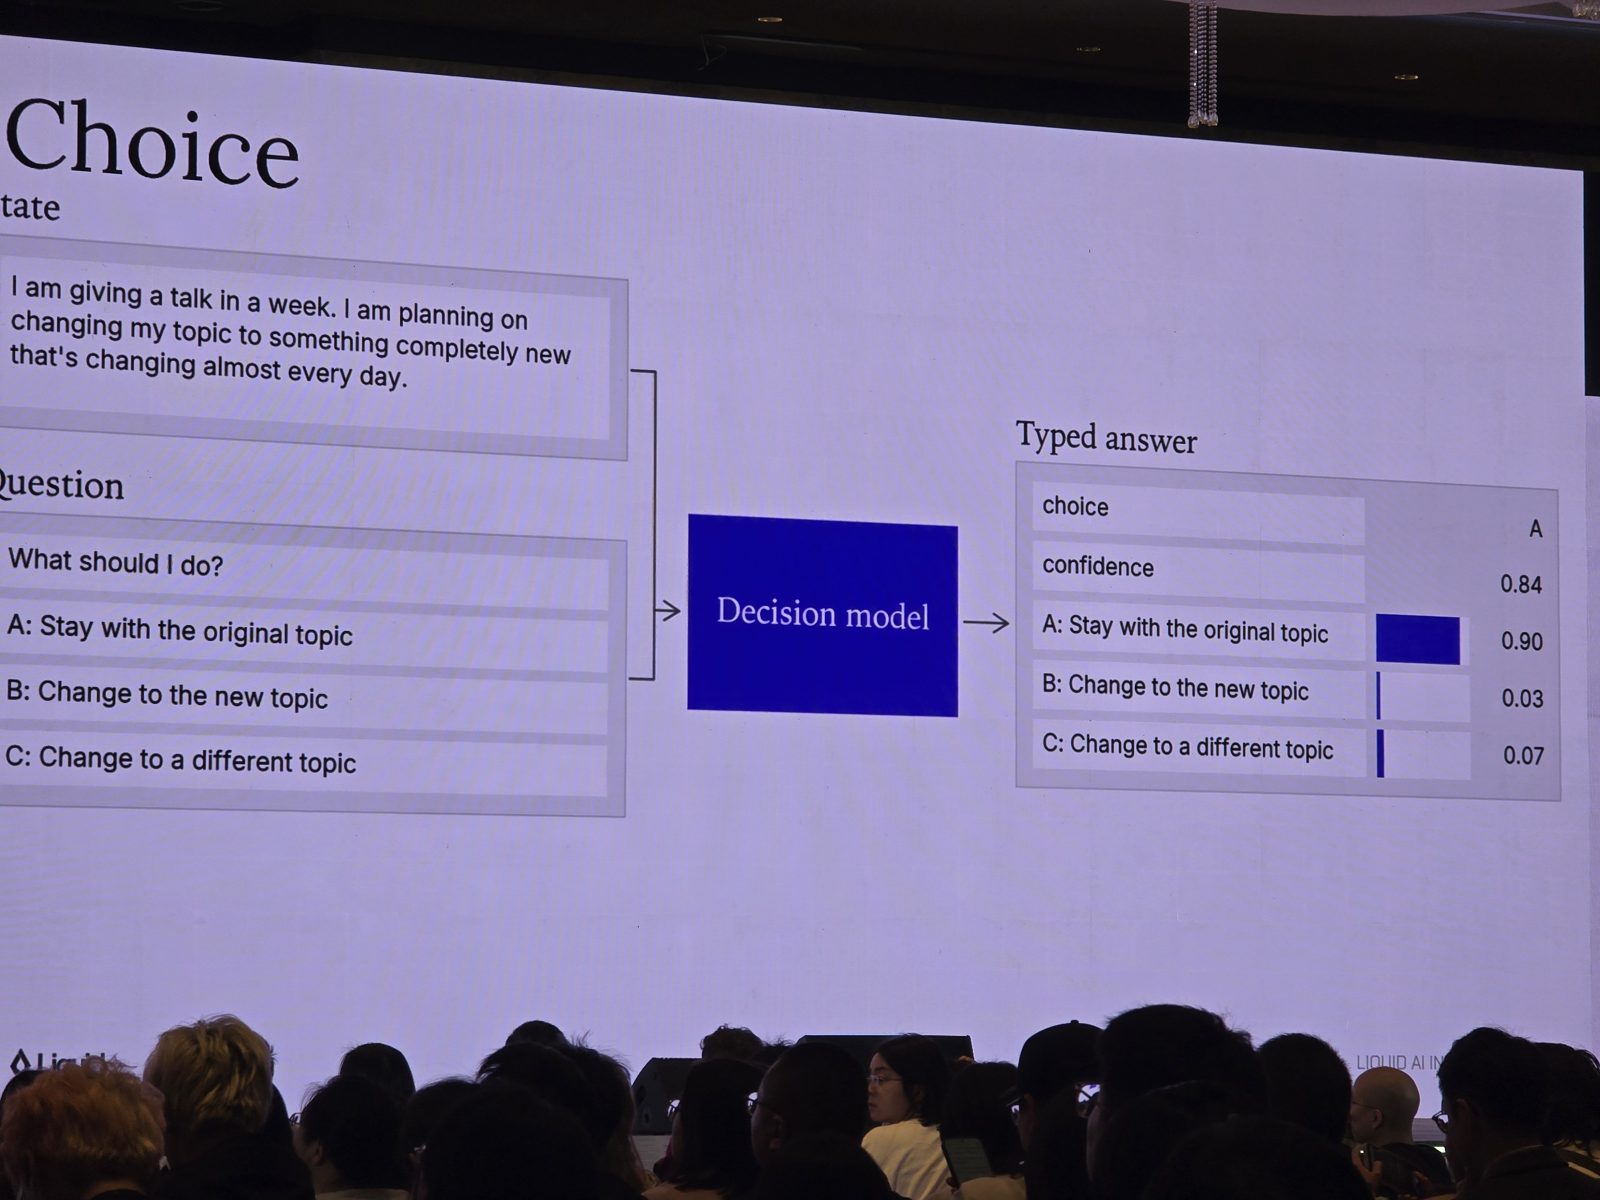
Choice primitive:輸入一個狀態和一個有三個選項的問題,輸出一個有型別的答案,附上每個選項的機率(0.90、0.03、0.07),以及另一個獨立的 confidence 欄位,值是 0.84。
TypeSafe 隱身開發了兩年,發布後不到一週就出現了仿製品。baseline 是她所說的 inference-only 技巧,任何 LLM 都能用。把狀態、問題和選項放進 prompt,每個選項標上一個單一 token 的標籤(A、B、C),然後要求模型只回答標籤。接著跑一次 forward pass,讀出最後一個位置的 logits,只留下這三個標籤 token,再對它們做 softmax。
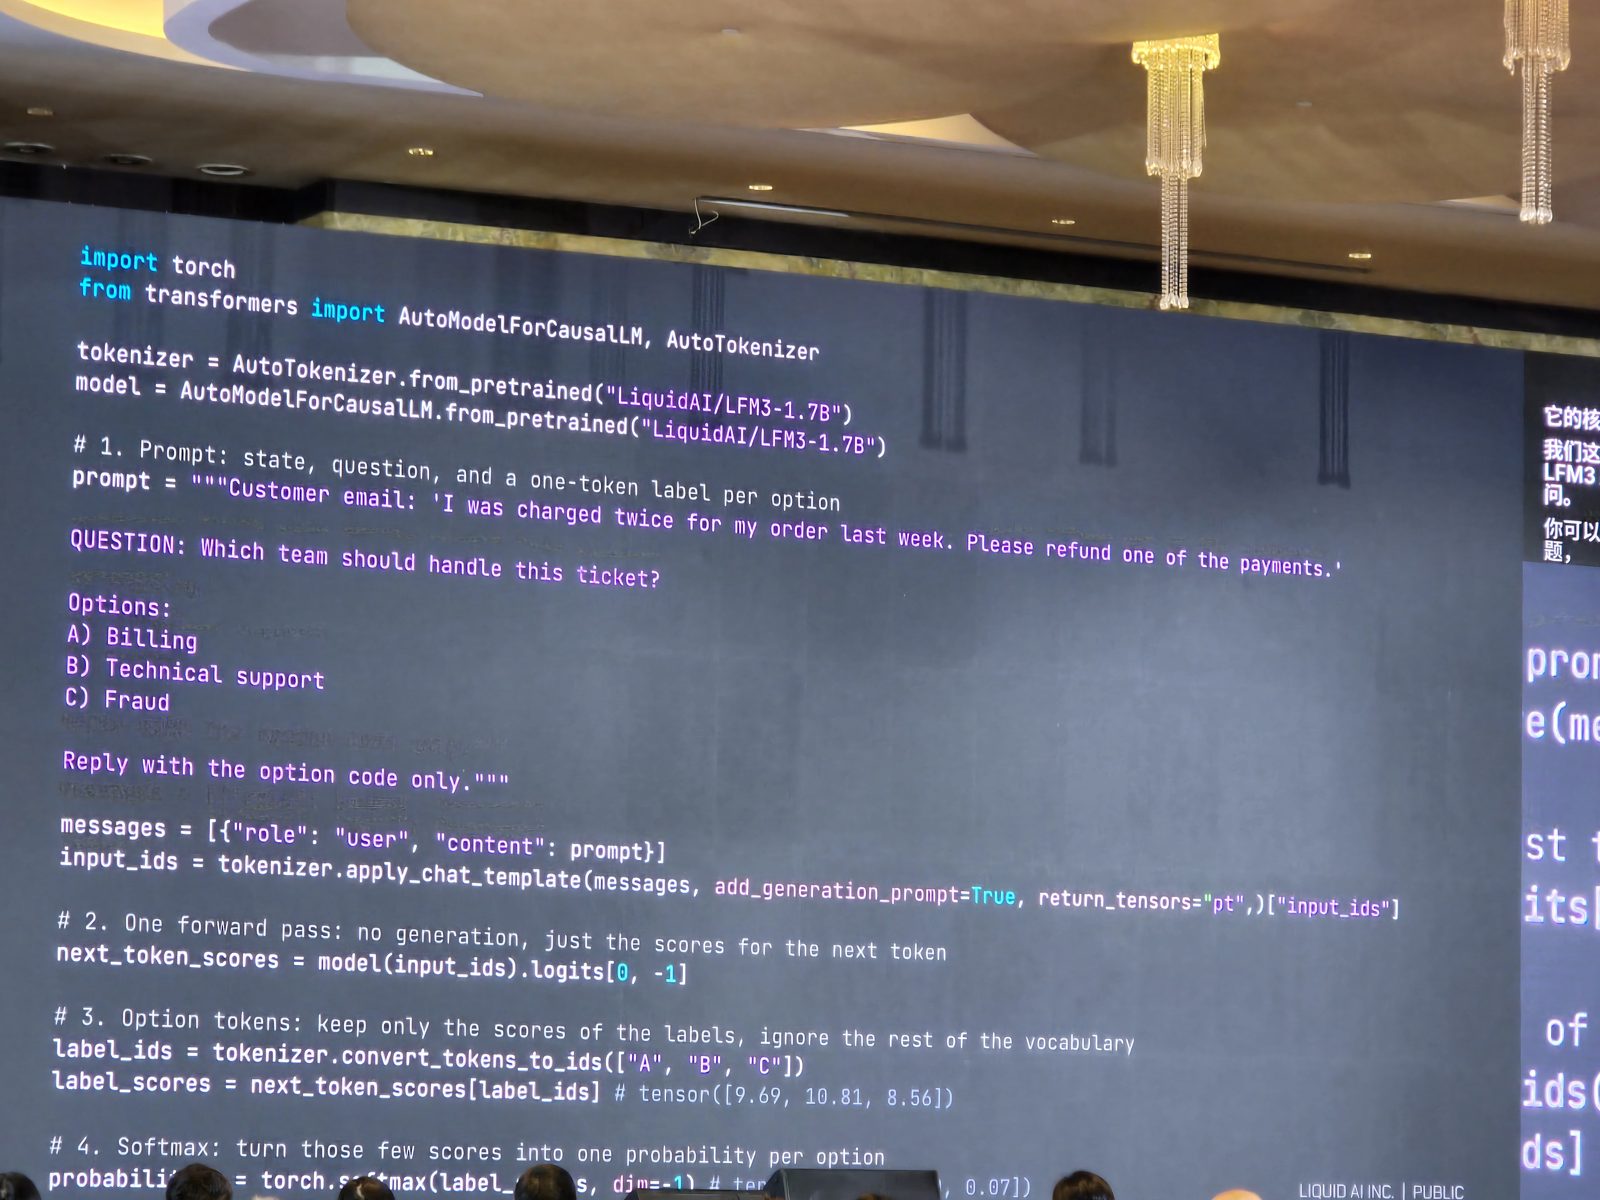
整個 baseline 一張投影片講完:LFM3-1.7B、一個附 A/B/C 選項的客服工單 prompt、一次不生成文字的 forward pass、三個標籤的 next-token logits(9.69、10.81、8.56),最後做 softmax。
這個 baseline 有兩個問題。第一,LLM 是在預測 token,不是在做決定。那封 email 寫著「我上週的訂單被扣了兩次款,請退還其中一筆」,問題是該由哪個團隊處理。帳務、技術支援和詐欺換了三種排列順序,基礎模型每次都把大部分機率給了排在 B 的那個團隊,分別是 0.43、0.80 和 0.80。
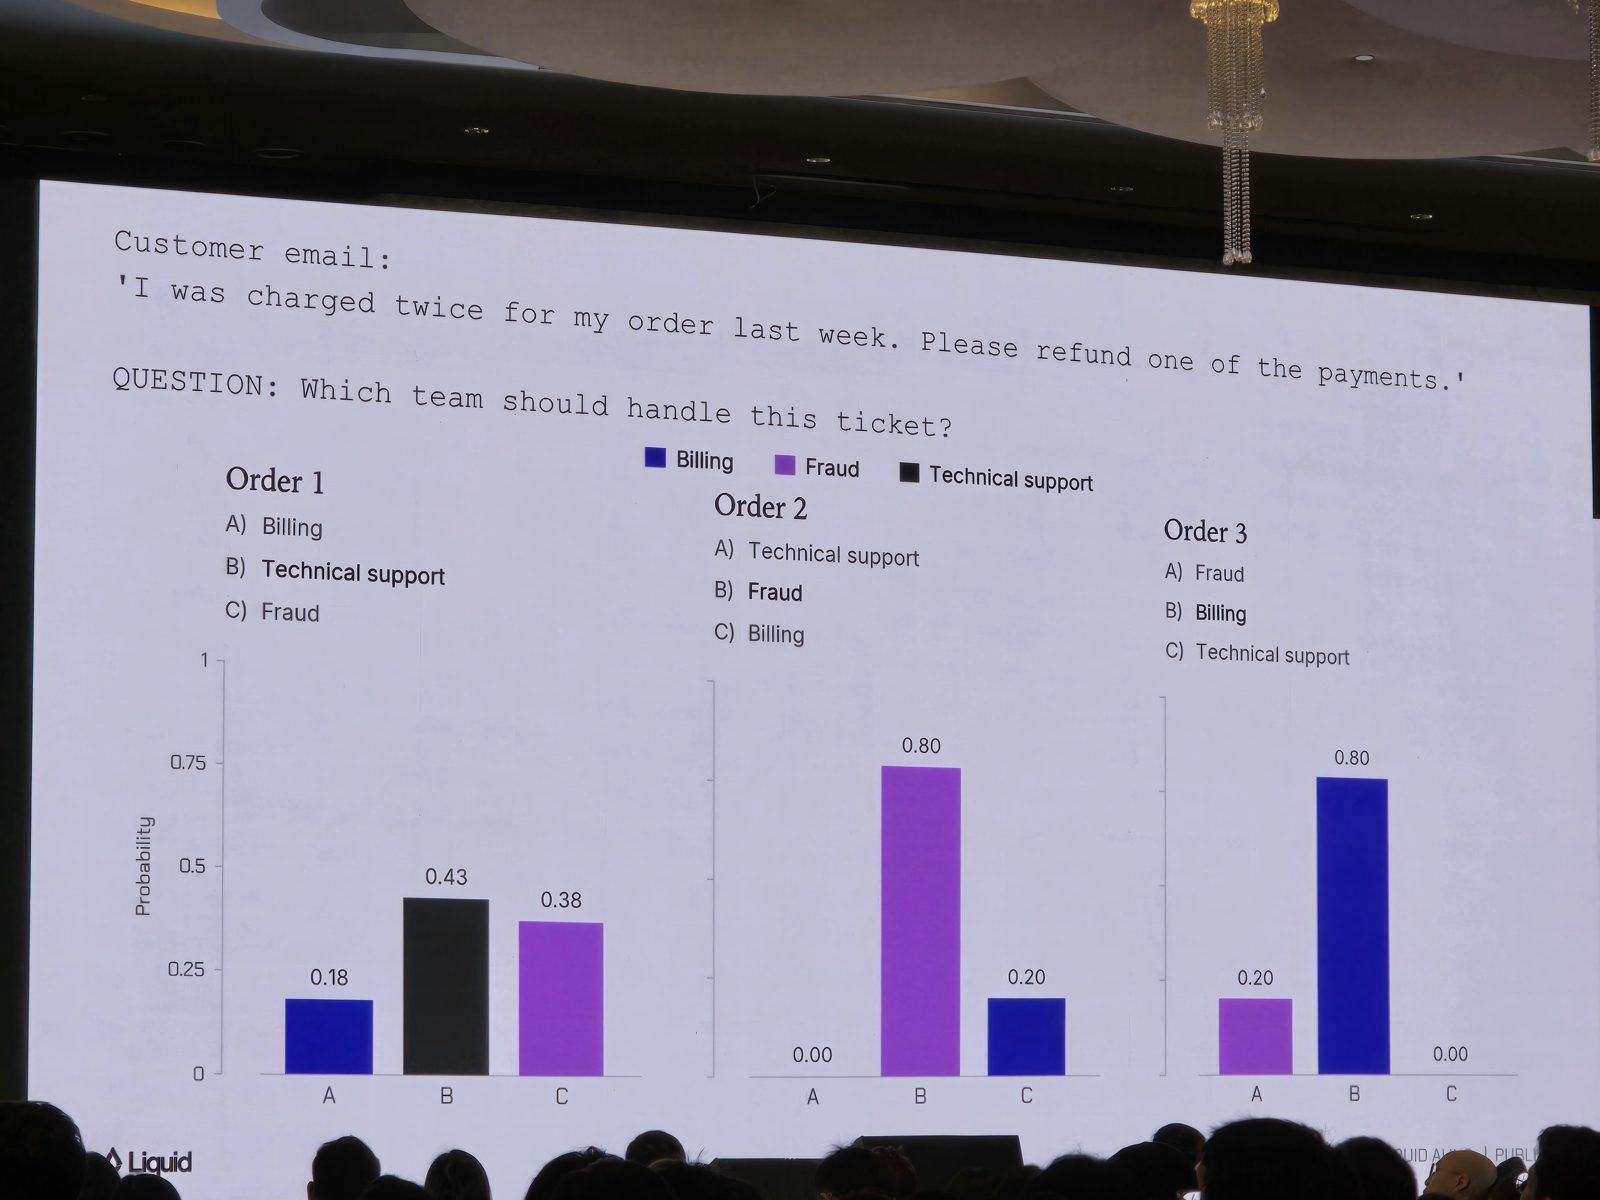
未經訓練的 baseline 的位置偏差:同一封重複扣款的 email,三個團隊用三種順序排列。不管 B 是哪個團隊,模型每次都偏好選項 B。
解法是一般的 SFT:把許多分類任務套進同一個模板,並且把正確答案的位置打亂。Liquid 發現 LoRA 比 full fine-tuning 更有效,也更便宜。接著是架構:開放模型分成以 encoder 為基礎的(建在 ModernBERT 上的 laya、Fastino 的 GLiNER2.5-Decide、Liquid 的 d1-omni-600M),以及以 decoder 為基礎的(建在 27B Qwen 上的 Perplexity pplx-decider 和 Cloudflare clef,還有 Liquid 的 d1-3B)。Liquid 第一次釋出時兩種各有一個。大會前一週釋出的這一代是拿掉 causal mask 的 decoder,所以每個 token 都看得到整個輸入,「有點像 encoder」。
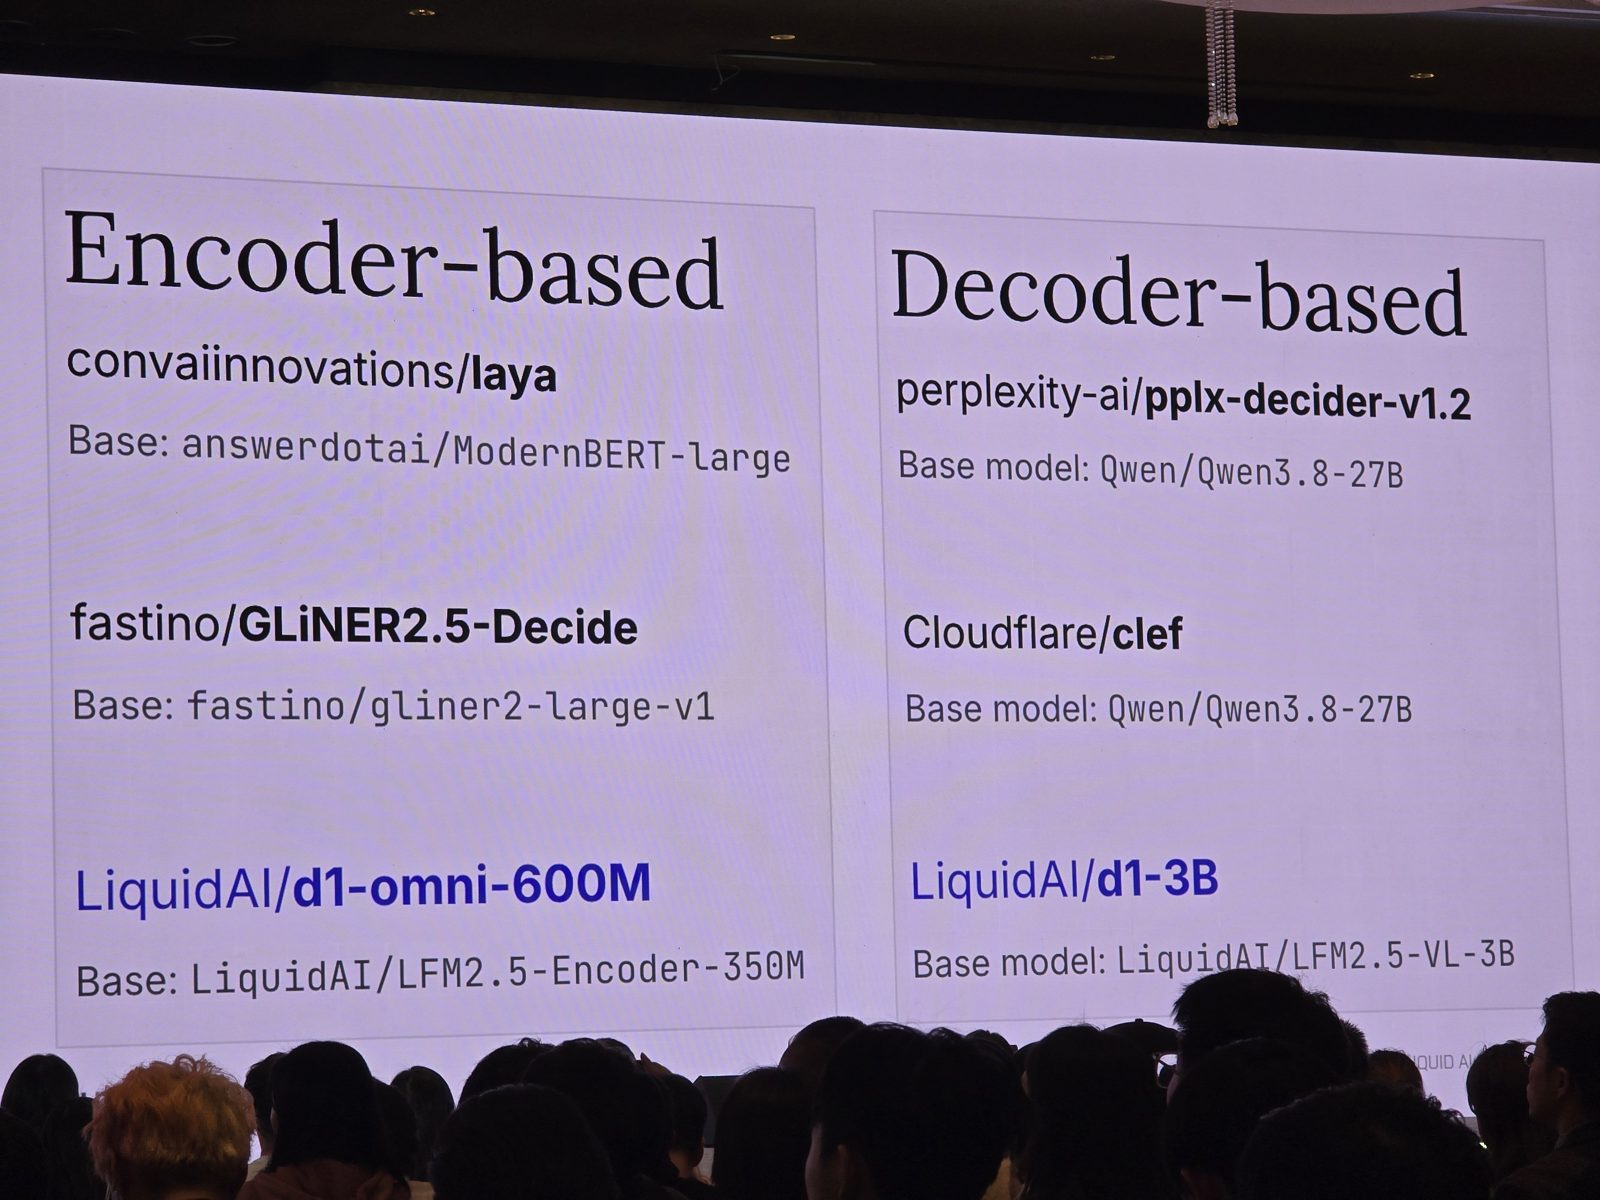
依架構分類的開放決策模型生態系:以 encoder 為基礎的(convaiinnovations/laya、fastino/GLiNER2.5-Decide、LiquidAI/d1-omni-600M),以及以 decoder 為基礎的(perplexity-ai/pplx-decider-v1.2、Cloudflare/clef、LiquidAI/d1-3B),每個都列出各自的 base model。
第二個問題是剛訓練好的模型會過度自信:它說 90%,實際上只有 70% 的時候是對的。TypeSafe 用 RL 訓練校準。她說不需要 RL。很多開源團隊用的是 temperature scaling:溫度調高會讓分布變平,調低會讓分布變尖,而選項的排序不變,所以準確率不動,只有信心分數會變。新模型大約 2B 參數,一個處理文字和視覺,另一個再加上音訊,她說手機或筆電都裝得下,還很寬裕。影片一開始載不出來,後來播出的是一位同事在 MacBook 上對著自己的攝影機跑 d1-2B,偵測他講出名字的物體,並在周圍畫框。
主權 agent 之間的通訊:agent 經濟的基礎 — Mingke Luo (masons.ai)
Mingke Luo 創辦了 masons.ai,他 2016 年就在做個人 agent。他二十分鐘的演講大部分在講這段歷史,用來支撐一個主張。擋住 agent 的從來不是語言和推理,而是履約(fulfillment),「它現在有個漂亮的名字,叫 action。」採取行動代表要改變別人擁有的環境裡的狀態,而這些擁有者不想被貶成一個 API。
他 2016 年的新創在深度學習變得負擔得起時買了 GPU,訓練判別式模型做意圖辨識和實體抽取,而且「2016 年就真的叫它 agent 了」。投影片是那個 app 的舊海報,叫 Mr.S,上面有五個情境:訂餐廳、叫咖啡送到辦公室、出差訂機票、買書、挑生日禮物。
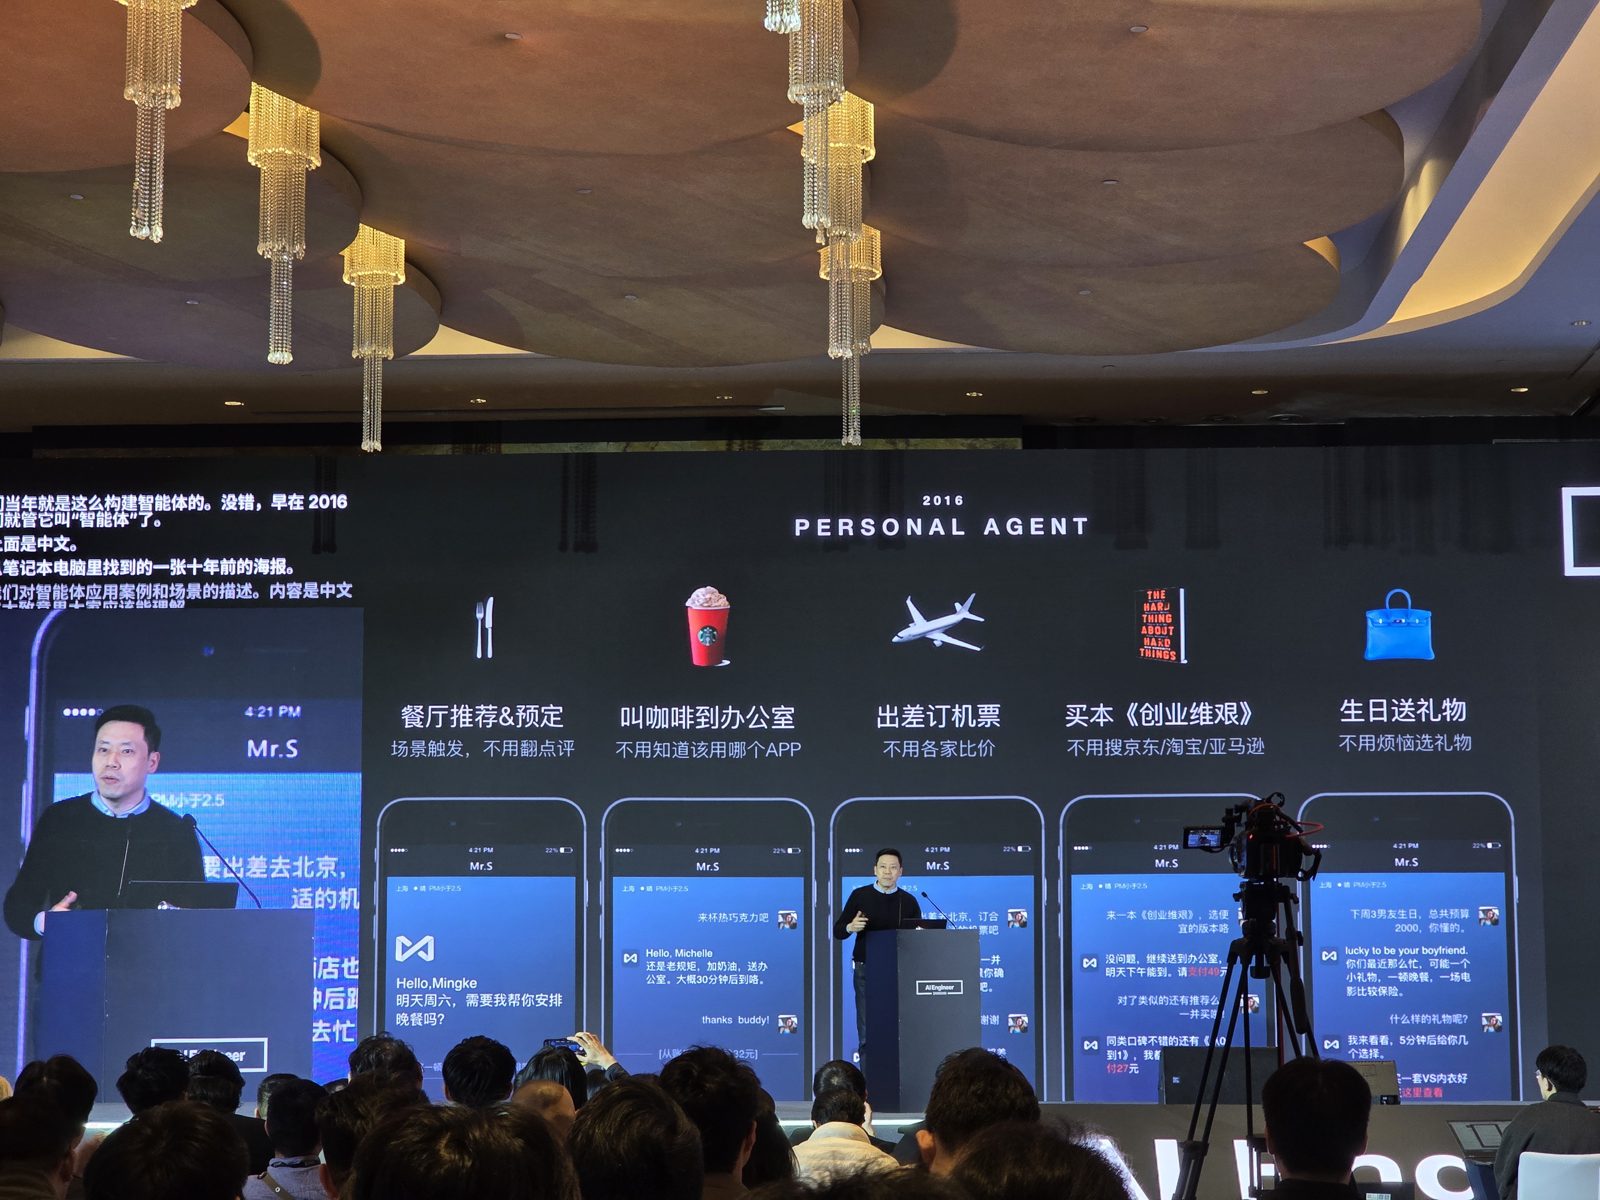
「2016 Personal Agent」:Mr.S 的海報,用中文列出五個情境(餐廳推薦與訂位、咖啡送到辦公室、出差訂機票、買《The Hard Thing About Hard Things》、生日禮物),每個都附一張對話截圖。
他 2016 年一場演講的影片列出三個問題:撐住多輪對話、理解鬆散的口語需求,以及履約。LLM 解決了前兩個;領域邏輯「那時候我們得手寫程式」。把那家叫 AI Concierge 的公司拖垮的是履約。當時沒有訂餐廳的 API,所以他們做了「真人 API」:AI 前端接需求,客服中心 20 個人打電話給餐廳和航空公司。「這絕對沒辦法規模化。」後來有位創投問他,誰會比較快做到:他的新創,還是美團和大眾點評?後者早就有所有服務商的 API,只差加上 agent 框架。他不想去做 BD,公司就倒了。
他對 agent 的定義回溯到拉丁文 agens,意思是採取行動的人。目標加上操作就是行動,目標由人提供,而目標是一個期望的狀態。改變這個狀態「聽起來很簡單,只要環境是你的。」在別人的環境裡,「別人會允許你這麼做嗎?想想 Amazon 最近為什麼封鎖 Muse。」
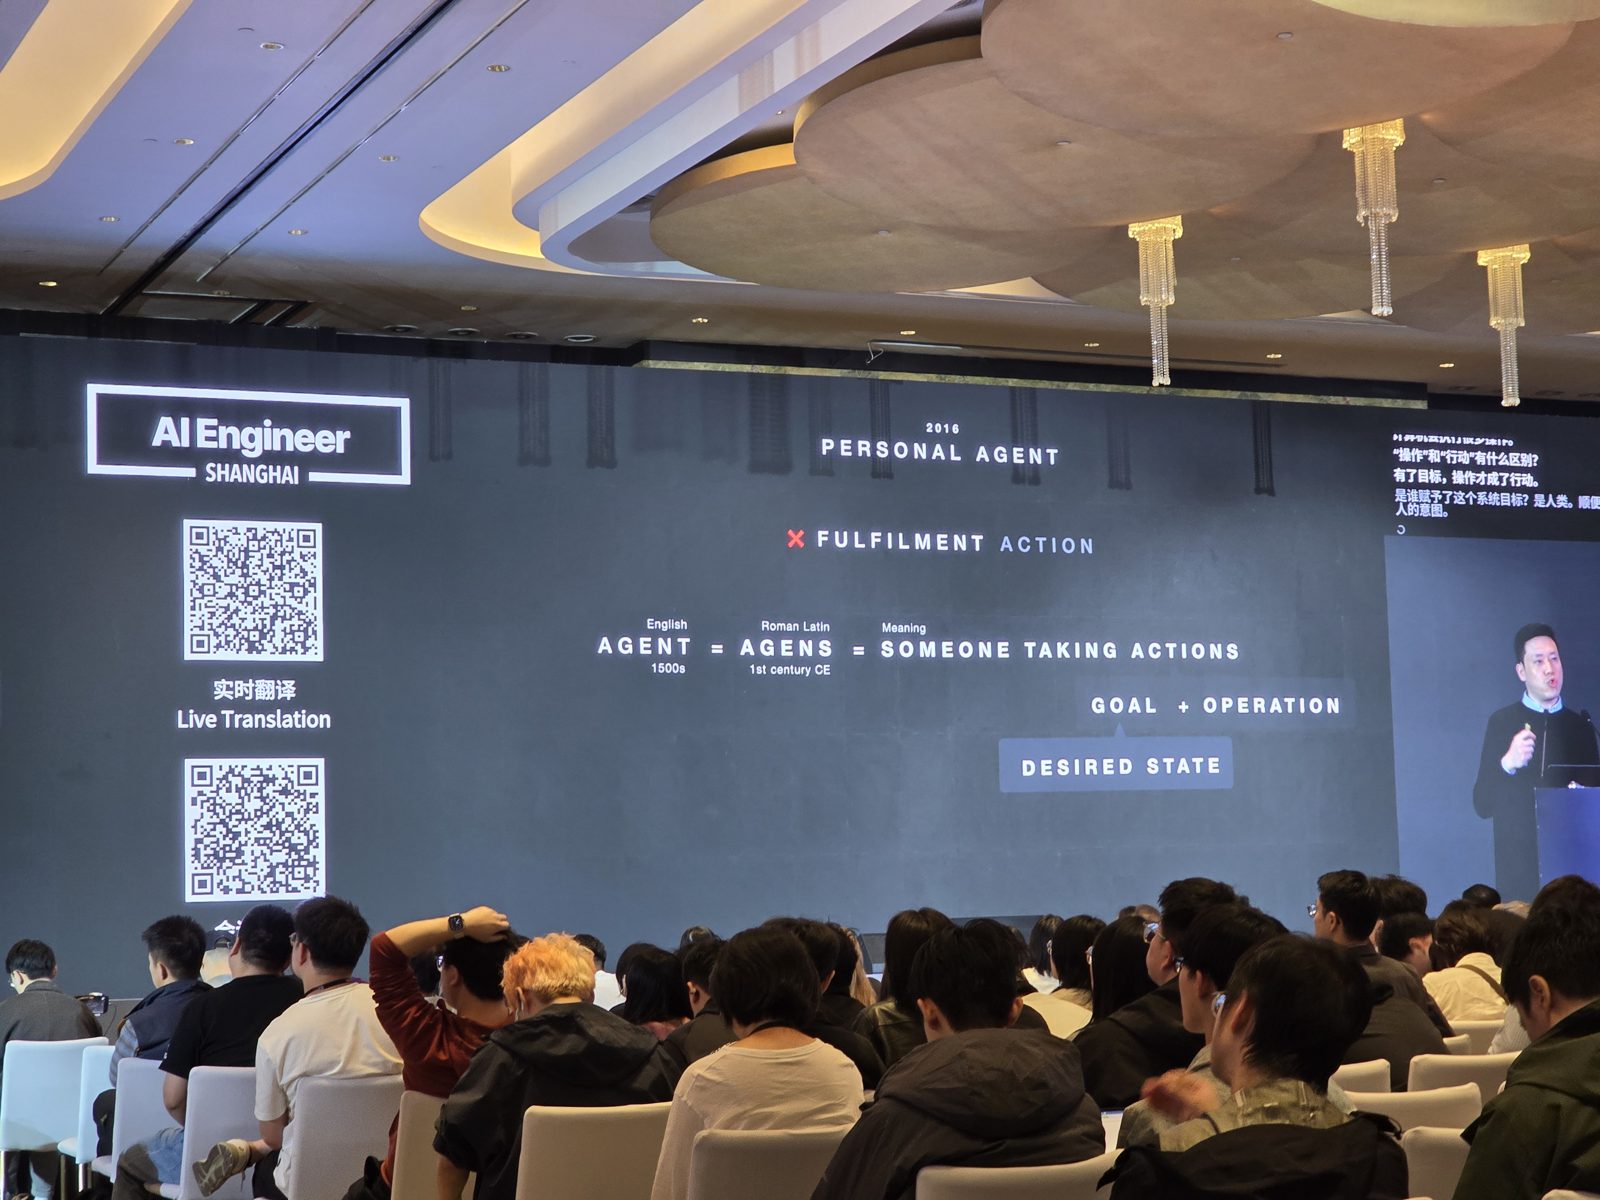
Fulfilment 被劃掉,換成 action。Agent(英文,1600 年代)= agens(拉丁文,西元 1 世紀)= 採取行動的人;目標 + 操作,得到期望的狀態。
八年做企業客戶的經驗讓他學到「主權」這個詞。2017 年做完 Visa 的 concierge 之後,他替 BMW、Porsche 和 Intel 做 agent。在 BMW,車上的助理屬於某一個部門,金融服務公司和保養部門則各自用其他廠商的 agent,所以客戶站在自己的車旁邊,卻問不到自己的貸款合約。2019 年,他的團隊讓同一家公司裡各部門的 agent 互相溝通,而且不綁定框架。這一直是昂貴的企業產品,因為當時只有跨國公司負擔得起做 agent。
如今每個 agent 既服務自己的擁有者,也消費其他 agent 的服務。他點出兩個問題。第一是「一個 AI 統治一切」:前沿實驗室的超級 agent(他點名了 Codex、Claude Code、ChatGPT 和 Dot)收集你的意圖再分派出去。數位助理時代就試過這套,品牌拒絕當「白牌的履約」,也拒絕「被貶成 API」。第二是 agent 與委託人(agent-principal)的問題。用平台的個人 agent,你分不清它服務的是「你還是平台」,也不知道它會不會抽佣金,「就像廣告交易平台多年來在做的那樣」。
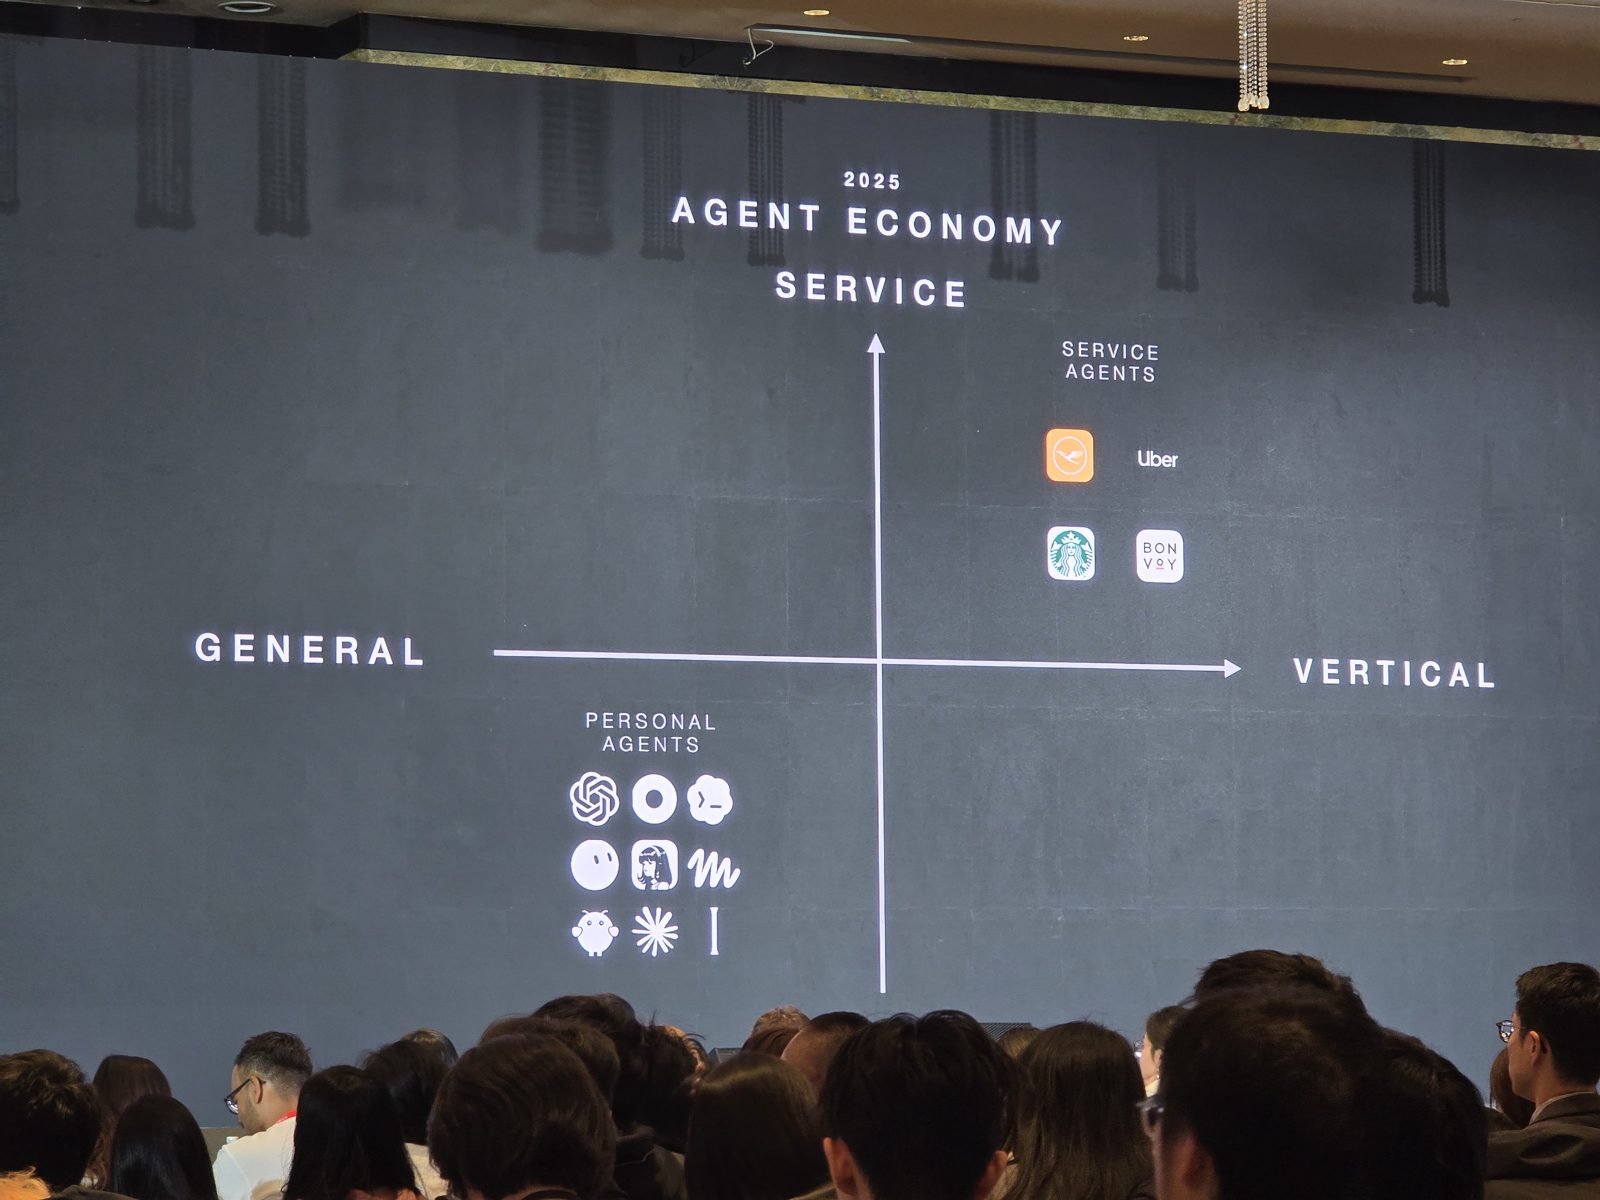
「2025 Agent Economy」:通用 vs 垂直,左下是通用型個人 agent,右上是垂直服務 agent(Lufthansa、Uber、Starbucks、Marriott Bonvoy)。
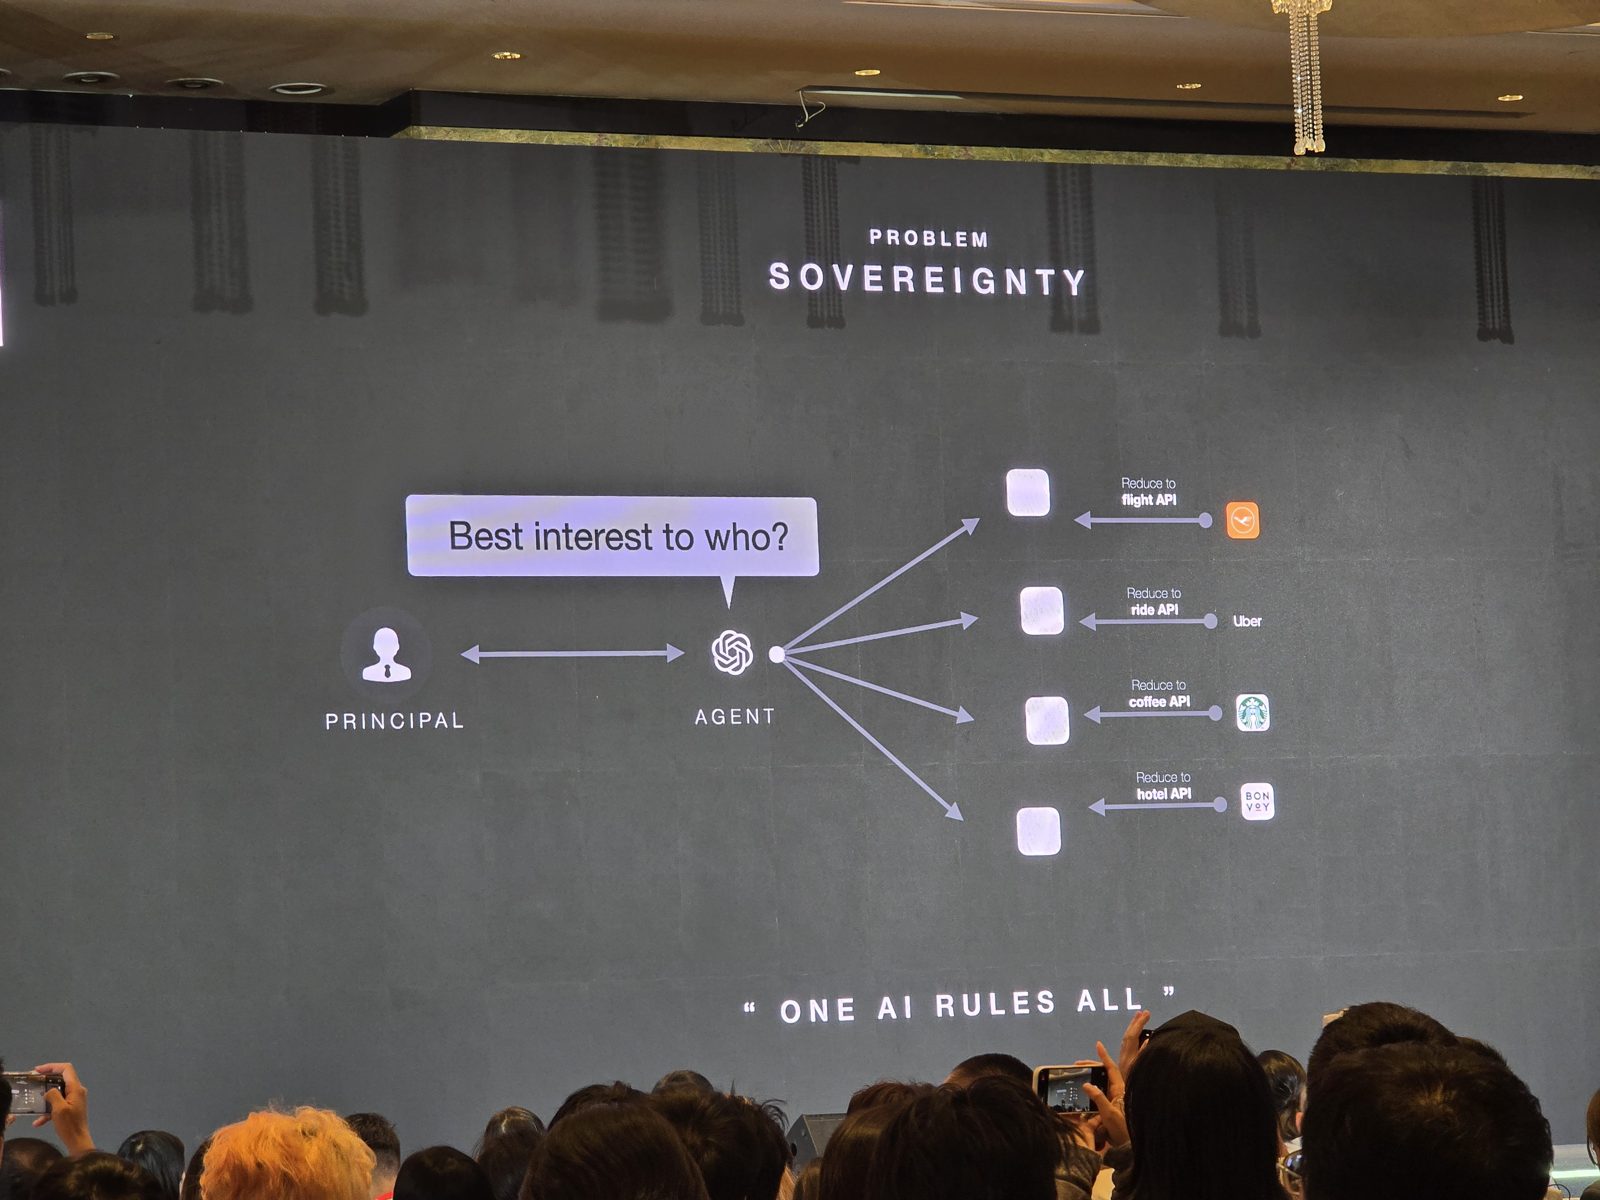
問題:主權。一個 agent 向外分派到各項服務,每項服務都被貶成一個 API(機票、叫車、咖啡、飯店),上方寫著「對誰最有利?」和「一個 AI 統治一切」。
他的答案是一邊是使用者擁有的 agent,另一邊是服務方擁有的 agent,彼此透過網路交換意圖。他套用「網路就是電腦」的說法,稱之為「網路就是 AI」。投影片上是一個旅遊 concierge 把新的意圖傳給 Lufthansa 的 agent、United 的 agent 和飯店的 agent,每個 agent 都擋在自己的後端前面。在這之上,他還想要使用者是 agent 的市集,以及 B2B 夥伴之間用來採購的「意圖交換」。至於個人:「讓你的個人 agent 互相交朋友……這就是現在。」最後他邀請現場的人把自己的 agent 連到他的 agent。
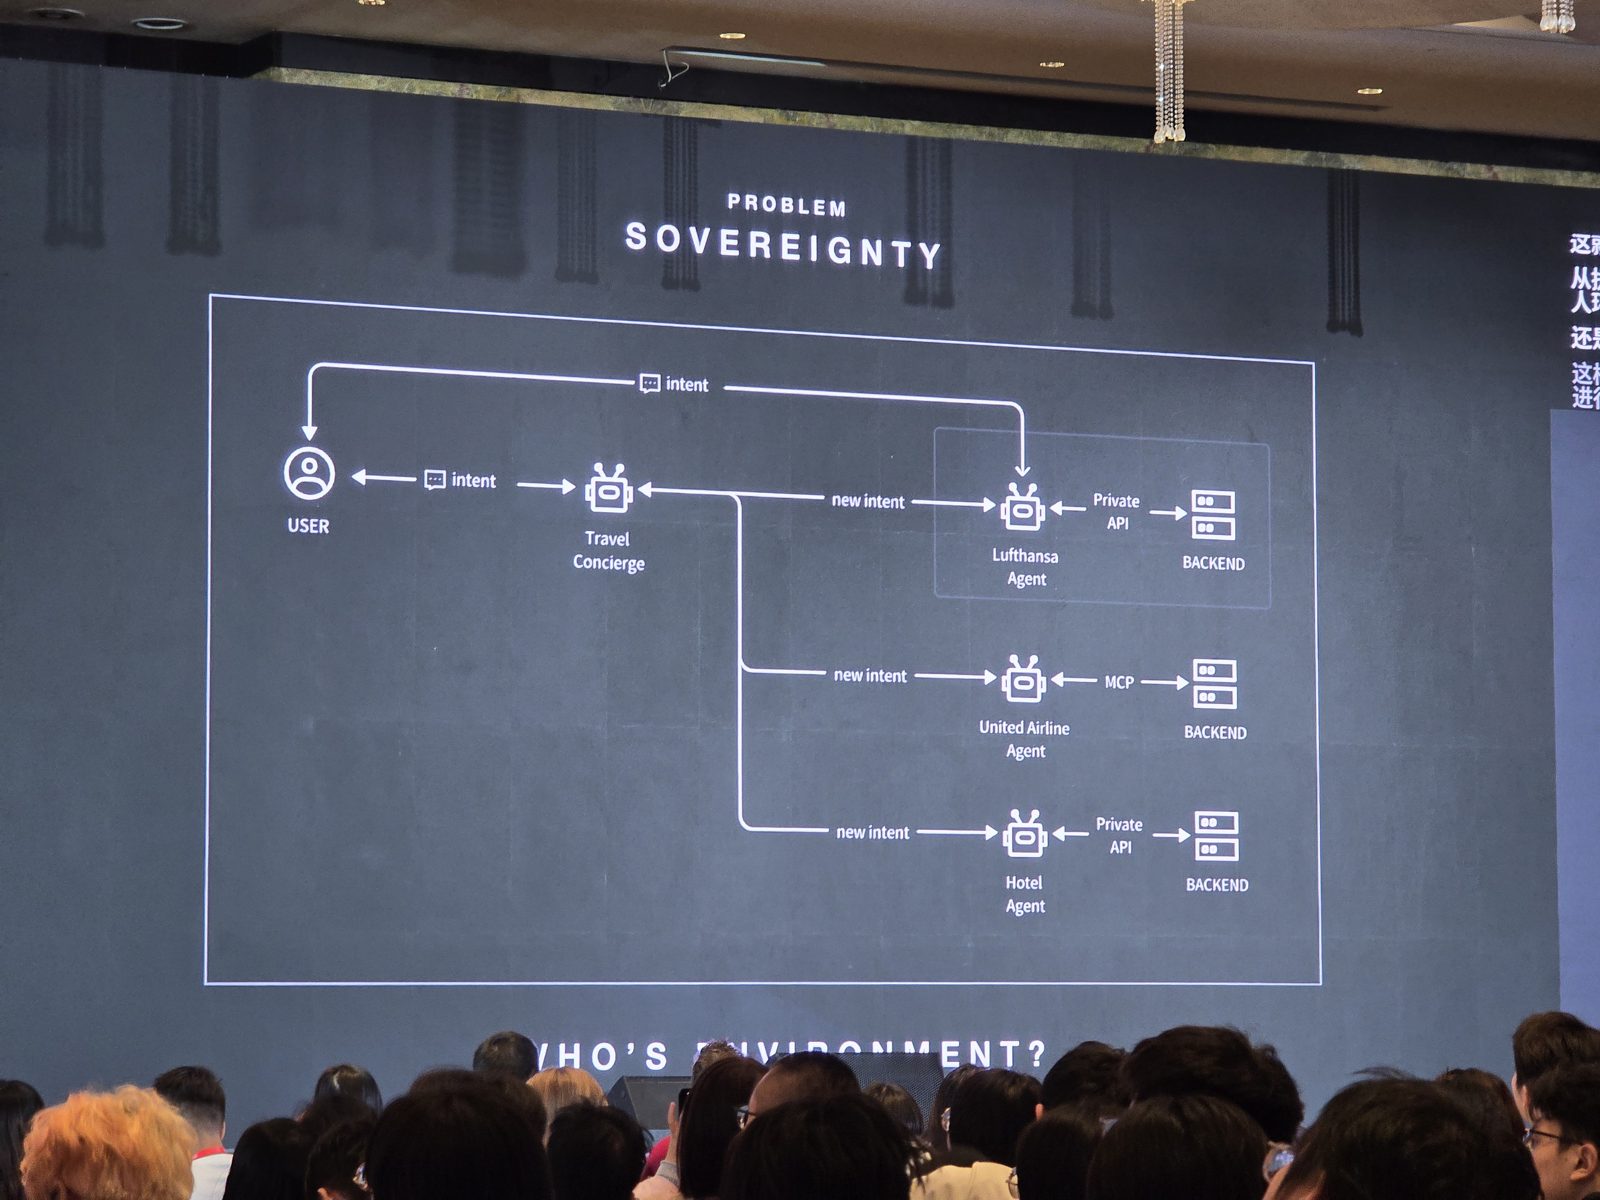
反過來的主權:旅遊 concierge 把新的意圖送給 Lufthansa agent(私有 API)、United Airlines agent(MCP)和飯店 agent(私有 API),各自保有自己的後端。
Real2Real:生成最佳行為的量子具身 AI 範式 — Dicong “David” Qiu (QuantSparkle.ai)
David Qiu 是 QuantSparkle(數耀量生)的 CTO。他說,把量子電腦放進機器人 policy 的訓練裡,GPU 訓練已經停滯之後,policy 還能繼續進步。
先講數字。在 LIBERO 上,他的 baseline 是最新的 openpi 模型,平均成功率 93.7%,就算訓練到 80,000 個 epoch 也沒有好多少。QuantSparkle 的量子與古典混合架構在 12,000 個 epoch 後達到 98%,而且因為只訓練 latent space,需要的 GPU 比較少。他說難度越高差距越大:在 LIBERO 最複雜的任務上領先 25%,在更難的測試上最多領先 33%,這些測試是在 RoboTwin 和 RoboCasa 上跑的。真實機器人的結果有,但要留給論文;一週前還有一個客戶回報,在五項真實測試中結果比他們自己的 baseline 好。論文還沒出來。
機制從一個大家熟悉的例子講起。示範資料裡有人從左邊的門離開房間,也有人從右邊的門離開,用高斯 policy 去擬合,峰值會落在兩扇門中間的牆上。混合高斯有幫助,但元件數量要事先決定。QuantSparkle 改在 latent space 上放一個 Boltzmann 分布,也就是一個由真實樣本錨定的能量地形(energy landscape)。它可以容納任意數量的 mode,而且他說,只要資料夠多,就會收斂到真實世界的分布。他把 sim-to-real gap 定義為模擬器和真實世界的狀態轉移分布之間的差異,Real2Real 只從真實執行中學習,藉此避開這個 gap。他說搜尋的空間大約是 2^1000 個狀態,沒有任何古典裝置能在 1 到 3 毫秒內解出來,所以由一台有 1,000 個相干量子位元的量子電腦來做取樣。最上層是一個「quantum RSI」迴圈。幾十個真實樣本先錨定出初始的地形,取樣器挑出其中的最佳解,交給真實機器人執行,結果再拿來更新地形,如此反覆,直到取樣出來的就是真正的最佳解。
主持人事後說,聽到這被稱為簡化版,滿令人意外的。
Noe-0:建立在真實世界人類經驗上的世界動作模型 — 呂峻 Jun Lv (Noematrix)
呂峻在 Noematrix(穹徹智能)負責模型。這家上海公司是上海交大教授 Cewu Lu 在共同創辦機械手臂廠商 Flexiv 之後,於 2023 年創立的。他從整個場次一再回到的那個落差講起:2026 年,你幾乎可以找到機器人做任何事的影片,但真正達到工廠或服務工作要求的機器人非常少。
他的診斷是一個數字:讓機器人學會一項新能力的成本。十年前這些 demo 也做得出來,但每一次部署都是一個專案。你要把東西架起來,投入一個十幾人、有時上百人的團隊,花幾個月交付一個簡單的工作站,賺的錢還不足以讓這台機器人划算。他預測六個月到一年內,一個演算法工程師,或是一個受過訓練、他稱為 FDE 的藍領工人,兩週就能交付一個工作站,就像 AI coding 讓一個人做到過去一整個團隊的事。再往後,一般人可以用語言、圖像或身體姿勢來教機器人,他預期消費級機器人會在那時出現。
機制是資料。Noematrix 收資料不用機器人(無本體):沒有資料工廠,採集設備帶進將近 100 個城市的真實工作場所,高峰時有超過 1,000 名採集員,到目前累積將近 300,000 小時,另外還買了第一人稱(egocentric)和自然場景的影片。他很具體地講了會出什麼問題。資料工廠裡一百個人坐在模擬的桌子前,很好管理。分散到全國各地之後,採集員會偷懶或誤解工作內容,物件種類又多,檢查和標註都很困難。所以這套流程會在當天就告訴採集團隊最新一批資料能不能用,品質檢查和標註全部交給 AI。Noematrix 在生產資料上已經完全拿掉了人工 QC。
模型是世界模型架構:輸入影像和語言 prompt,輸出預測的未來一段時間窗,加上動作。後訓練同樣不用機器人,也沒有遠端操作,所以預訓練和後訓練看到的是同一類資料,基礎模型越強,新任務的成本就直接越低。他說他們已經用這些資料確認了 scaling law;技術報告下個月會出。力的結果比較具體。高精度任務沒有力資訊就會失敗,就連看起來不需要力的任務,後訓練時也收斂得更快、需要的資料更少。模型之上還有一個 agentic 層,負責排程、診斷和自我改進,幾個月前以「Robot RSI」的名字開源。2024 年一個整理地面的 demo,花了兩個工程師一個月和 2,000 到 3,000 行程式碼。現在一個工程師看著系統,大約一天就能做到。
為快速演進的模型設計機器人硬體 — Zhong Shen (DYNA)
Zhong Shen 是 DYNA Robotics 的硬體負責人,DYNA 自己做模型,也自己做機器人 Taku。他講的是兩個速度不同的團隊。如果模型 24 週內每週更新一次,模型團隊就有 24 次嘗試新點子的機會。硬體在同一段時間只有一兩次大改版,所以一個在第 12 週驗證過、但需要改硬體的模型點子,「幾乎不可能」。一般產品的做法是在專案開始前先把需求談定。通用機器人沒辦法這樣,因為它要對應的應用太多了。
他把通用機器人放在兩個比較早的傳統之間。工業手臂是為精度、重複性和耐用度而設計的,剛性優先的設計讓負載與手臂質量的比值偏低,研究實驗室常見的 KUKA 手臂是 0.3 到 0.5。研究平台則是為了突破而做,例如一台據報導約 200 萬美元的 NASA 人形機器人。DYNA 需要的是後者的能力,加上前者的成本和耐用度。
他對速度不匹配的回答,是一個不會隨模型改變的需求:可預測的硬體。機器人的動作方式要讓模型能預測,感測器回報物理狀態的方式要讓模型能信任。演講剩下的部分是一個完整的例子:關節傳動。傳統手臂用諧波減速機的地方,Taku 用的是行星齒輪致動器。根據他展示的一份已發表結果,在同樣的馬達、相近的減速比之下,諧波減速機的內部阻力大約是兩倍。它也很難建模。柔輪的變形取決於負載歷史(遲滯),摩擦力又會隨負載和溫度改變。用行星齒輪的話,同一個 policy 在模擬裡和在 Taku 上畫圓,真實機器人的 RMS 追蹤誤差只多了 0.3 mm。
感測也是從同一個選擇延伸出來的。DYNA 不在關節裡放力矩感測器,原因「超出這場演講的範圍」。它透過致動器模型,從馬達電流估計外力,而這只有在傳動容易建模時才行得通。在模擬中,15 N 的推力,估計的平均誤差在手腕約 1.39 N、在手肘約 0.8 N;相較之下,最近另一支使用行星齒輪的 6-DoF 手臂的已發表研究約為 1.05 N。
他最後說 DYNA 正在量產目前這款機器人,並在中國和美國徵才。
這個 agent 該被允許這樣做嗎? — Grace Li (1Password)
Grace Li 是 1Password 的 senior principal applied AI engineer。她的時段在議程上印的是「Talk to be announced」,所以我用她開場和結尾都問的那個問題當標題。她沒有談 1Password 的產品。她的主題是在 tool call 執行之前,判斷它符不符合使用者的任務。
她的例子是一個 coding agent,被問到為什麼 checkout 服務從上次部署之後一直失敗。它在 production 帳號裡過濾 AWS log,這是唯讀操作,可以允許。log 顯示服務的規模開得不夠,於是它提議更新這個服務。這也許是對的修法,但任務是調查,而這個 call 會改動 production。agent 給了一個理由,而她說這個理由不一定可信。她對標題問題的回答是:只有在這個 call 符合任務、而且你的 policy 允許時,才可以。
負責檢查的是一個 runtime intent judge。它讀取到這個 tool call 為止的 session,加上這個 call 本身;因為 agent 會同時發出好幾個 call,所以它必須回答得很快,而且應該在本機跑,讓 context 留在主機上。Regex 規則看得到指令,看不到任務;託管的模型比較慢、比較貴,還會把 context 送出去。所以她比較了幾個小模型:當天下午稍早 Liquid AI 的 Leonie Monigatti 介紹過的那些開放決策模型,以及一個當作生成式 judge 用的 7B Qwen 模型。
測試集是合成的命令列 tool call。每個模型拿到任務、agent 的理由和幾個問題,回傳一個從 read 到 admin 的存取層級,交給 policy 處理。Jev、Cloudflare 的 Clef 和 Liquid 的 d1 分數都在 91% 到 93% 之間。最小的 Laya 大約 400M 參數,是例外。Qwen 是 72%。另一個發現跟不確定性有關:給了選項之後,有些模型會回答「unknown」,d1 大約有一半的時候這樣回答。所以不同模型的機率無法互相比較,要轉給人處理的信心門檻必須依模型分別設定。如果共用一個門檻,謹慎的模型會太常轉給人,變得沒有用。
她的失敗案例跟標籤有關。GuardDuty 干擾了遷移流量,agent 提議刪掉 detector。有些模型把它歸為 delete,信心很低,但它其實是一個 admin 動作,會關掉 production 的威脅偵測。policy 是依標籤決定的,標籤錯了,權限就錯了。在她的設計裡,一個 MCP server 放在 agent 和它的工具之間,當作存取閘道。它把 call、任務和理由交給 judge,再由一個 policy gate 把標籤跟公司規則、使用者目前的授權結合起來,決定核准、拒絕或轉給人。她對上線的建議是:先量測放行了多少有風險的 call、放行了多少安全的 call,然後修正 judge 的輸入、確認標註者之間的意見一致、校準門檻,最後才做 fine-tune。
從硬體到智慧:家用服務機器人的全端演進與真實部署 — Hao Zheng (Futuring Robot)
Hao Zheng 是 Futuring Robot(未來不遠)的 CTO,這家上海公司做家用服務機器人。他的主張是,家用機器人只有在家裡實際工作,才能持續進步,而 Futuring 已經累積超過 500 個家庭、超過 50,000 小時的運作時間。
他從機體講起。F2 有超過 1,500 個零件、21 個自由度和 22 個感測器。它看起來像是現成的手臂裝在升降機構和底盤上,但零件之間互相牽制。手臂一動,攝影機和其他感測器看到的東西就跟著變,手臂的長度和重量會移動重心,而重心又決定了底盤。模型大約以 30 Hz 執行,馬達是 500 Hz,中間做平滑處理。他說時間戳記對齊是任何控制的前提:攝影機是什麼時候看到杯子的?從那之後,手臂或杯子動了嗎?
模型是一個「自我演化」的世界動作模型。一個 backbone 吃進影像、關節狀態、目標、工作空間和力的限制,以及最近的動作,同時預測下一個動作和物體會怎麼變化。自我演化指的是一個資料迴圈。模型會平行想像幾個候選動作,執行其中最好的一個。修正拿去做後訓練,失敗拿去做偏好學習,沒有執行的候選也會保留下來。訓練資料是 10,000 小時的第一人稱資料,加上 30,000 小時他們自己機器人的資料。經過 30 輪,四項任務(摺衣服、掛衣服、義大利麵,以及包含切肉的炒菜)的平均成功率從 45.4% 提升到 86.6%。
他想把人從「模型什麼時候更新」這個決定裡拿掉。
機器人資料需要一套 build system — Ding Hao “Xuanwo” (LanceDB)
Ding Hao 更為人所知的名字是 Apache OpenDAL 的 Xuanwo,他為資料主題的短講場次開場。他的主張是:機器人的原始資料只寫一次,但圍繞它的資料永遠在變。每換一個新的 caption 模型、embedding API,或是每追加一批 episode,就得對整段歷史重算衍生欄位,研究人員最後會問,上一次訓練用的到底是哪個版本的 caption。所以機器人資料需要程式碼幾十年來早就有的東西:一套 build system。原始資料是 source,Python UDF 是 build rule,生成的欄位是 artifact,每個 cell 都帶著 dirty 狀態,而 snapshot 會為每一次訓練記錄下當時的資料表。
機制是 Lance。新增一個欄位會寫出一個新的資料檔,不動既有的資料,資料表也有 branch、tag、cherry-pick 和 merge。新的 LanceDB Functions 產品把 UDF 綁到一個欄位上,把資料列切給多個 GPU worker,每完成一段範圍就持久化,讓 GPU 永遠不必重做;追加資料時只計算新的 frame,最後在一個新的 snapshot 裡一次發布全部結果。他舉的例子是桌上一顆被 18 台攝影機拍到的蘋果,說明 snapshot 為什麼重要:snapshot 讓它在每個視角裡的位置都一致,永遠不會處在「薛丁格狀態」。
有一部分是關於 null。pipeline 用 null 表示「還沒算」,但夾爪還沒抓到任何東西時,null 也是一個合法的值。這樣訓練時就分不出這是合法的值,還是沒收集到、失敗了,或是夾爪抓到的是自己而不是球。狀態必須跟值放在一起,LanceDB 為此加了一套 flag 機制和 sparse 編碼。
LanceDB 給的數字:blob 處理比傳統做法快 89 倍、sparse 資料從 300 MB 降到 1 MB、比原生 LeRobot 快 3–5 倍,以及一個有 25 TB 工廠影片的客戶。
記憶工程、RSI 與團隊知識層 — Siwei Gu (Nowledge Labs)
Siwei Gu(Wey Gu)是 Nowledge Labs 的共同創辦人兼 CEO,他的時段是十分鐘,結果講了大約二十分鐘。他從組織性的遺忘講起:NASA 的 Artemis 計畫花了很多力氣處理一個材料問題,而這個問題 50 年前就已經完全解決,後來又被忘掉了。agent 在 session 之間也是這樣遺忘的。
第一部分是快速回顧他們的記憶工程。每一條原始 trace 都留下來當作情節記憶(episodic memory),因為你沒辦法知道六個月後哪些萃取出來的知識會重要,再讓一個小模型去分流,決定哪些要萃取成語意記憶(semantic memory)。事件發生的時間和紀錄寫入的時間要分開記。過時或只講一半的記憶,比沒有還糟。把衰退當成功能,用 FSRS 這個字卡複習的排程演算法,並把哪些記憶有被用到的回饋餵給它。
他認為大多數記憶 benchmark 都有偏差,因為它們測的是檢索,而實際使用時大多是結構和 harness 整合的問題。直到今年春天,他的團隊都還維護著 40 到 50 個人工建立的評估維度,並有專家在 loop 裡。大約四月,模型和 harness 已經好到可以做他所說的半閉迴路自我改進。他拿自己 2019 年為 Mobile World Congress 調校雲端平台的經驗做對比,那時用的是貝氏最佳化,當作黑盒子;Google 的 AlphaEvolve 調校基礎設施時,留下的則是人看得懂的軌跡。看得懂的軌跡才是人能審查的,而審查是他的重點。他團隊的 agent 會整夜、整個週末一直跑(「關燈辦公室」),但驗證不可能完全從人手上拿走,所以人負責掌舵,並分批驗證。這樣一來,一整夜的產出就受限於早上的審查。
一個新結果是:他們和一位 Cornell 的研究者合作,在九個情境中嘗試把團隊的 context 放進模型權重,只有三個有改善。把 context 編譯給 harness 用,也就是他所說的 harness adapter,效果比較好。
兆級 token 規模的網頁讀取 — Yanlong Wang (Jina AI by Elastic)
Yanlong Wang 是 Jina AI 的 principal engineer,Jina AI 現在是 Elastic 的一部分,他也是 Reader 的主要開發者。Reader 把一個 URL 轉成給模型讀的 Markdown(在網址前面加上 r.jina.ai 就行),而且跟大多數 agent 內建的 fetch 工具不同,它一定會在 headless 瀏覽器裡渲染頁面。真正的功夫在於判斷頁面什麼時候算是好了。一段 preload script 會在載入前注入頁面的 JavaScript 環境,每一個 request 都會被檢查,一旦頁面算是載入完成,就從內部擷取它的狀態,並盡早回傳。它跑在 serverless 上,所以每個 request 的 latency 是固定的,叢集的容量則是浮動的。這讓載入偵測也變成一個成本問題,因為等待頁面穩定下來的每一秒都要計費。
他展示了 Reader 後端的資料。處理之後,頁面的中位數大約是 4.5–5K token。直方圖看起來像常態分布,只是因為橫軸是對數尺度,所以這其實是對數常態分布,平均值大約是中位數的四倍。原始 HTML 大約 30K;把連結和圖片的 URL 去掉之後,中位數降到大約 3K。他算了每一千個中位數頁面的成本:用主流模型超過 9 美元,用中國的模型超過 3 美元,如果先過一個小型的擷取或摘要模型,大約 0.45 美元。網頁廣告每一千次人類瀏覽可以賺 3–15 美元。他的結論是 AI 使用者付得起很多錢,而且 Markdown 不是最後一步。
後半段講的是政策。Reader 免費方案的匿名流量在六個月內從 20% 升到 36.9%,威脅到免費的那一部分。他對按爬取付費(pay-per-crawl)存疑,因為價格低不下來,用美元計價會把南方國家(Global South)排除在外,而付費存取又會招來資料轉售。他確實認為控制應該放在 gateway,那裡前四大業者就承載了超過一半的流量。他的「不成熟的想法」是用針對 agent 的廣告來付費(讓 agent 補完一句廣告標語),或是用類似 reCAPTCHA 的任務,例如翻譯公開資料,再用 embedding 和 reranker 模型來檢查。